
Dieser Beitrag wurde im Rahmen der Data Science Blogathon
Einführung
Python ist eine leicht zu erlernende Programmiersprache, Damit ist es die bevorzugte Wahl für Data-Science-Anfänger, Datenanalyse und maschinelles Lernen. Es hat auch eine große Online-Studentengemeinschaft und ausgezeichnete datenzentrierte Bibliotheken..
Bei so vielen Daten, die generiert werden, Es ist wichtig, dass die Daten, die wir für datenwissenschaftliche Anwendungen wie maschinelles Lernen und prädiktive Modellierung verwenden, sauber sind. Aber, Was verstehen wir unter sauberen Daten? Und was bringt die Daten überhaupt durcheinander?
Schmutzige Daten bedeuten nur schlechte Daten. Vervielfältigung von Datensätzen, Unvollständige oder veraltete Daten und falsche Analysen können die Daten durcheinander bringen. Diese Daten müssen bereinigt werden. Datenbereinigung (oder Datenbereinigung) bezieht sich auf das Verfahren von „Aufräumen“ diese schmutzigen Daten, Fehler in den Daten erkennen und dann beheben.
Die Datenbereinigung ist ein wichtiger Schritt in einem Machine-Learning-Projekt, und wir werden einige grundlegende Datenbereinigungstechniken behandeln (und Python) in diesem Beitrag.
Datenbereinigung in Python
Anhand eines Beispieldatensatzes erfahren wir mehr über die Datenbereinigung in Python. Wir werden die verwenden Russischer Wohnungsdatensatz und Kaggle.
Wir beginnen mit dem Importieren der unverzichtbaren Bibliotheken.
# Bibliotheken importieren
Pandas als pd importieren
numpy als np importieren
Seegeboren als sns importieren
import matplotlib.pyplot als plt
%matplotlib inline
Laden Sie die Daten herunter und lesen Sie sie dann mit der Funktion read_csv in einem Pandas DataFrame aus () und Angabe des Dateipfads. Anschließend, Verwenden Sie das Shape-Attribut, um die Anzahl der Zeilen und Spalten im Datensatz zu überprüfen. Der Code dafür ist wie folgt:
df = pd.read_csv('housing_data.csv')
df.shape
Der Datensatz hat 30 471 Reihen und 292 Säulen.
Jetzt werden wir die numerischen Spalten von den kategorialen Spalten trennen.
# Numerische Spalten auswählen
df_numeric = df.select_dtypes(einschließen=[np.zahl])
numerische_cols = df_numeric.columns.values
# nicht numerische Spalten auswählen
df_non_numeric = df.select_dtypes(ausschließen=[np.zahl])
non_numeric_cols = df_non_numeric.columns.values
Jetzt sind wir mit den vorbereitenden Schritten fertig. Jetzt können wir mit der Bereinigung der Daten fortfahren. Wir beginnen damit, Spalten zu identifizieren, die fehlende Werte enthalten, und versuchen, diese zu korrigieren.
Fehlende Werte
Wir beginnen mit der Berechnung des Prozentsatzes der fehlenden Werte in jeder Spalte und speichern diese Informationen dann in einem DataFrame.
# % von Werten, die in jeder Spalte fehlen
values_list = Liste()
cols_list = Liste()
für Spalte in df.columns:
    pct_missing = np.mean(df[col].ist Null())*100
    cols_list.append(col)
    values_list.append(pct_missing)
pct_missing_df = pd.DataFrame()
pct_missing_df['col'] = cols_list
pct_missing_df['pct_missing'] = values_list
Der DataFrame pct_missing_df enthält jetzt den Prozentsatz der fehlenden Werte in jeder Spalte zusammen mit den Spaltennamen.
Wir können aus diesen Informationen auch ein Bild zum besseren Verständnis erstellen, indem wir den folgenden Code verwenden:
pct_missing_df.loc[pct_missing_df.pct_missing > 0].Handlung(kind='bar', Feigengröße=(12,8))
plt.zeigen()
Das Ergebnis nach der Ausführung der obigen Codezeile sollte so aussehen:
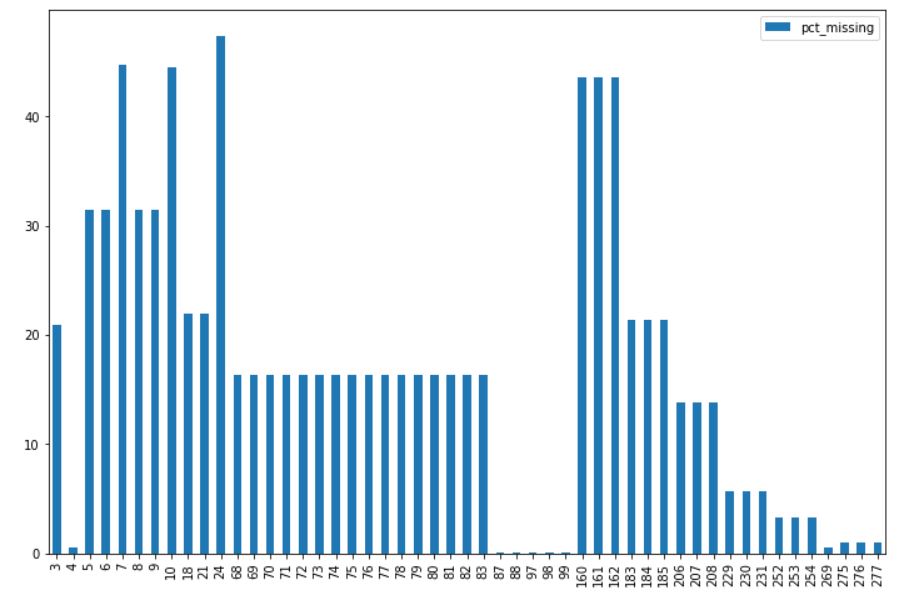
Es ist klar, dass in einigen Spalten nur sehr wenige Werte fehlen, während in anderen Spalten ein erheblicher Prozentsatz der Werte fehlt. Jetzt werden wir diese fehlenden Werte beheben.
Es gibt mehrere Möglichkeiten, diese fehlenden Werte zu korrigieren. Einige von ihnen sind“
Fallbeobachtungen
Eine Möglichkeit könnte darin bestehen, die Beobachtungen zu verwerfen, die einen Nullwert für eine der Spalten enthalten. Dies funktioniert, wenn der Prozentsatz der fehlenden Werte in jeder Spalte viel niedriger ist. Wir eliminieren die Beobachtungen, die Nullen in den Spalten enthalten, die weniger als haben 0,5% Null. Diese Spalten wären metro_min_walk, metro_km_walk, railroad_station_walk_km, railroad_station_walk_min e ID_railroad_station_walk.
less_missing_values_cols_list = Liste(pct_missing_df.loc[(pct_missing_df.pct_missing < 0.5) & (pct_missing_df.pct_missing > 0), 'col'].Werte)
df.dropna(subset=less_missing_values_cols_list, inplace=Wahr)
Dadurch wird die Anzahl der Datensätze in unserem Datensatz auf reduziert 30,446 Aufzeichnungen.
Spalten löschen (Funktionen)
Eine andere Möglichkeit, fehlende Werte in einem Dataset zu beheben, besteht darin, die Spalten oder Features zu löschen, die einen erheblichen Prozentsatz an fehlenden Werten aufweisen.. Diese Spalten enthalten nicht viele Informationen und können vollständig aus dem Datensatz entfernt werden. In unserem Fall, Lassen Sie uns alle Spalten eliminieren, die mehr als fehlen 40% von Werten. Diese Spalten wären build_year, Zustand, hospital_beds_raion, cafe_sum_500_min_price_avg, cafe_sum_500_max_price_avg und cafe_avg_price_500.
# Fallenlassen von Spalten mit mehr als 40% Nullwerte
_40_pct_missing_cols_list = Liste(pct_missing_df.loc[pct_missing_df.pct_missing > 40, 'col'].Werte)
df.drop(Spalten=_40_pct_missing_cols_list, inplace=Wahr)
Die Anzahl der Funktionen in unserem Datensatz ist jetzt 286.
Fehlende Werte imputieren
In unserem Datensatz fehlen noch Daten. Jetzt werden wir die fehlenden Werte in jeder numerischen Spalte mit dem Medianwert dieser Spalte imputieren.
df_numeric = df.select_dtypes(einschließen=[np.zahl])
numerische_cols = df_numeric.columns.values
für Spalte in numerische_spalten:
    fehlt = df[col].ist Null()
    num_missing = np.sum(fehlen)
    wenn num_missing > 0:  # Werte nur für Spalten mit fehlenden Werten imputieren
        med = df[col].Median() #mit dem Median anrechnen
        df[col] = df[col].Fillna(mit)
Fehlende Werte in numerischen Spalten werden nun behoben. Bei kategorialen Spalten, wir werden die fehlenden Werte durch die Modewerte dieser Spalte ersetzen.
df_non_numeric = df.select_dtypes(ausschließen=[np.zahl])
non_numeric_cols = df_non_numeric.columns.values
für Spalte in non_numeric_cols:
    fehlt = df[col].ist Null()
    num_missing = np.sum(fehlen)
    wenn num_missing > 0:  # Werte nur für Spalten mit fehlenden Werten imputieren
        mod = df[col].beschreiben()['top'] # mit dem am häufigsten vorkommenden Wert belegen
        df[col] = df[col].Fillna(mod)
Alle fehlenden Werte in unserem Datensatz wurden bereits behandelt. Wir können dies überprüfen, indem wir den folgenden Code ausführen:
df.isnull().Summe().Summe()
Wenn die Ausgabe null ist, bedeutet, dass jetzt keine fehlenden Werte mehr in unserem Datensatz vorhanden sind.
Außerdem können wir die fehlenden Werte durch einen bestimmten Wert ersetzen (Was -9999 Ö ‚fehlen‘) was darauf hinweist, dass die Daten an dieser Stelle fehlten. Dies kann ein Ersatz für die Anrechnung von Wertverlust sein.
Atypische Werte
Ein Ausreißer ist eine ungewöhnliche Beobachtung, die von den meisten Daten abweicht. Ausreißer können die Leistung eines Modells für maschinelles Lernen erheblich beeinträchtigen. Deswegen, Ausreißer zu erkennen und zu adressieren ist essentiell.
Tomemos la columna ‚life_sq‘ als Beispiel. Wir verwenden zuerst die Methode describe () um sich die beschreibenden Statistiken anzusehen und zu sehen, ob wir daraus Informationen sammeln können.
df.life_sq.describe()
Die Ausgabe sieht so aus:
zählen    30446.000000
bedeuten        33.482658
std         46.538609
Mindest          0.000000
25%         22.000000
50%         30.000000
75%         38.000000
max       7478.000000
Name: life_sq, dtyp: float64
Abreise, es ist klar, dass etwas nicht stimmt. Der Maximalwert scheint im Vergleich zu den Mittel- und Medianwerten ungewöhnlich groß zu sein. Lassen Sie uns einen Boxplot dieser Daten erstellen, um eine bessere Vorstellung zu bekommen.
df.life_sq.plot(kind='box', Feigengröße=(12, 8))
plt.zeigen()
Die Ausgabe sieht so aus:
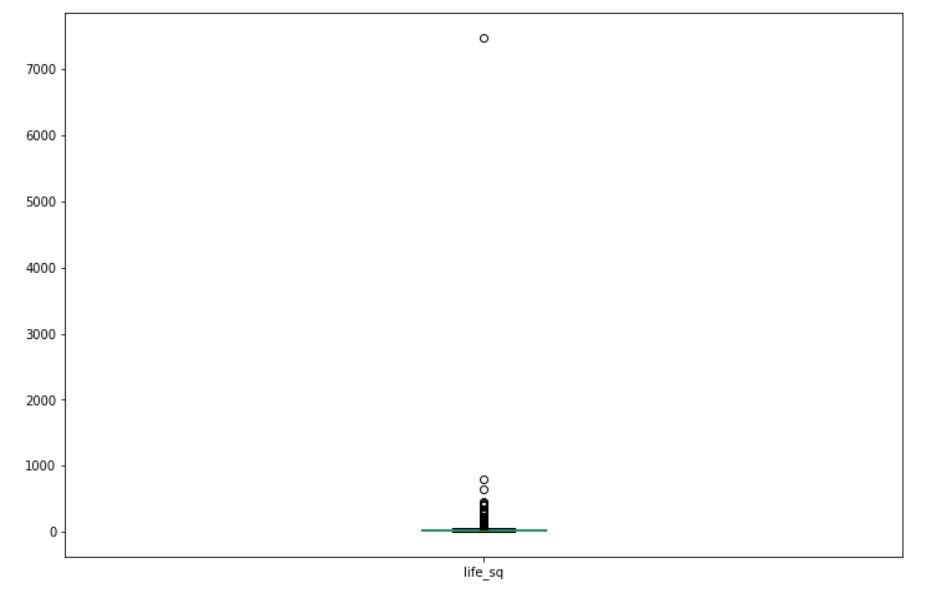
Aus dem Boxplot wird deutlich, dass die Beobachtung für den Maximalwert (7478) ist ein Ausreißer in diesen Daten. Beschreibende Statistik, das BoxplotsBox-Diagramme, Auch bekannt als Box- und Whisker-Diagramme, sind statistische Werkzeuge, die die Verteilung eines Datensatzes darstellen. Diese Diagramme zeigen den Median, Quartile und Ausreißer, Ermöglicht die Visualisierung von Datenvariabilität und -symmetrie. Sie sind nützlich für den Vergleich zwischen verschiedenen Gruppen und in der explorativen Analyse, So lassen sich Trends und Muster in den Daten leichter erkennen.... y los diagramas de dispersión nos ayudan a identificar valores atípicos en los datos.
Wir können mit Ausreißern wie mit fehlenden Werten umgehen. Wir können die Beobachtungen löschen, die wir für Ausreißer halten, oder wir können Ausreißer durch geeignete Werte ersetzen, oder wir können eine Art Transformation an den Daten vornehmen (als Logarithmus oder Exponential). In unserem Fall, eliminemos el registro donde el valor de ‚life_sq‘ es ist 7478.
# Entfernen des Ausreißerwerts in der Spalte life_sq
df = df.loc[df.life_sq < 7478]
Doppelte Datensätze
Manchmal, Daten können doppelte Werte enthalten. Es ist wichtig, doppelte Datensätze aus Ihrem Datensatz zu löschen, bevor Sie mit einem Machine Learning-Projekt fortfahren. In unseren Daten, da die ID-Spalte eine eindeutige Kennung ist, Wir werden doppelte Datensätze unter Berücksichtigung aller außer der ID-Spalte entfernen.
# Löschen von Duplikaten durch Berücksichtigung aller Spalten außer ID
cols_other_than_id = Liste(df.spalten)[1:]
df.drop_duplicates(subset=cols_other_than_id, inplace=Wahr)
Dies wird uns helfen, doppelte Datensätze zu löschen. Bei Verwendung der Formmethode, Sie können überprüfen, ob die doppelten Datensätze wirklich entfernt wurden. Die Anzahl der Beobachtungen ist jetzt 30,434.
Festlegen des Datentyps
Häufig, im Datensatz, Werte werden nicht im richtigen Datentyp gespeichert. Dies kann in späteren Phasen zu einem Roadblock führen und wir erhalten möglicherweise nicht das gewünschte Ergebnis oder erhalten Fehler während der Ausführung.. Ein häufiger Datentypfehler ist der von Datumsangaben. Datumsangaben werden in Python oft als Objekte geparst. Es gibt einen separaten Datentyp für Datumsangaben in Pandas, namens DateTime.
Wir prüfen zunächst den Datentyp der Zeitstempelspalte in unseren Daten.
df.timestamp.dtype
Esto devuelve el tipo de datos ‚Objekt‘. Jetzt wissen wir, dass der Zeitstempel nicht korrekt gespeichert ist. Um dieses Problem zu beheben, Zeitstempelspalte in DateTime-Format konvertieren.
# Konvertieren des Zeitstempels in das Datums-/Uhrzeitformat
df['timestamp'] = pd.to_datetime(df.Zeitstempel, format="%Y-%m-%d")
Jetzt haben wir den Zeitstempel im richtigen Format. Ähnlich, Es kann Spalten geben, in denen Ganzzahlen als Objekte gespeichert werden. Es ist wichtig, diese Merkmale zu identifizieren und den Datentyp zu korrigieren, bevor Sie mit dem maschinellen Lernen fortfahren.. Glück für uns, wir haben keine derartigen Probleme in unserem Datensatz.
EndNote
In diesem Beitrag, Wir haben einige grundlegende Möglichkeiten besprochen, wie wir Daten in Python bereinigen können, bevor wir unser Machine-Learning-Projekt starten.. Wir müssen die fehlenden Werte identifizieren und löschen, Ausreißer erkennen und beheben, Löschen Sie doppelte Datensätze und korrigieren Sie den Datentyp aller Spalten in unserem Datensatz, bevor Sie mit unserer AA-Aufgabe fortfahren.
Der Autor dieses Beitrags ist Vishesh Arora. Du kannst dich mit mir verbinden unter LinkedIn.
Die in diesem Beitrag gezeigten Medien zur Gebärdensprachakkreditierung sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





