
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Stellen Sie sich vor, Sie gehen in einen Buchladen, um ein Buch über die Weltwirtschaft zu kaufen, und können den Abschnitt des Ladens, der dieses Buch hat, nicht finden., vorausgesetzt die Buchhandlung hat einfach alle Arten von Büchern gestapelt. Dann merkt man, wie wichtig es ist, die Bibliothek je nach Buchtyp in verschiedene Bereiche zu unterteilen..
Die Themenmodellierung ähnelt der Aufteilung einer Bibliothek basierend auf dem Inhalt der Bücher, wie es sich auf den Prozess des Auffindens von Themen in einem Textkorpus und des Annotierens der Dokumente basierend auf den identifizierten Themen bezieht.
Wenn Sie segmentieren müssen, eine große Sammlung von Dokumenten verstehen und zusammenfassen, Themenmodellierung kann hilfreich sein.
Themenmodellierung mit LDA:
Die latente Dirichlet-Zuordnung (LDA) ist eine der Möglichkeiten, Themenmodellierung zu implementieren. Es ist ein generatives probabilistisches Modell, bei dem angenommen wird, dass jedes Dokument aus einem anderen Anteil von Themen besteht.
Wie funktioniert der LDA-Algorithmus?
Die folgenden Schritte werden in LDA ausgeführt, um jedem der Dokumente Themen zuzuordnen:
1) Für jedes Dokument, Initialisieren Sie jedes Wort zufällig mit einem Thema unter den K-Themen, wobei K die Anzahl der vordefinierten Themen ist.
2) Für jedes Dokument von:
Für jedes Wort w im Dokument, Berechnung:
- P (Thema zu | Dokument d): Anteil der Wörter in Dokument d, die dem Thema t zugeordnet sind
- P (Palabra w | Thema zu): Anteil der Aufgaben zum Thema t in allen Word-Dokumenten, die aus w . stammen
3) Reasignar el tema T ‚a la palabra w con probabilidad p (T‘ | D) * P (w | T ‚) unter Berücksichtigung aller anderen Wörter und ihrer Sachzuweisungen
Der letzte Schritt wird mehrmals wiederholt, bis wir einen stationären Zustand erreichen, in dem sich die Themenzuweisungen nicht mehr ändern. Aus diesen Themenzuordnungen wird das Themenverhältnis für jedes Dokument ermittelt.
Anschauliches Beispiel für LDA:
Nehmen wir an, wir haben folgendes 4 Dokumente als Korpus und wir wollen eine Themenmodellierung an diesen Dokumenten durchführen.
Dokumentieren 1: Wir sehen viele Videos auf YouTube.
Dokumentieren 2: YouTube-Videos sind sehr informativ.
Dokumentieren 3: Wenn ich einen technischen Blog lese, kann ich die Dinge leicht verstehen.
Dokumentieren 4: Ich blogge lieber als YouTube-Videos.
Die LDA-Modellierung hilft uns, Themen im vorherigen Korpus zu entdecken und Themenmischungen für jedes der Dokumente zuzuweisen. Als Beispiel, das Modell könnte etwas wie unten ausgeben:
Thema 1: 40% Videos, 60% Youtube
Thema 2: 95% Blogs, 5% Youtube
Papiere 1 Ja 2 würde dann dazu gehören 100% zum Thema 1. Das Dokument 3 würde gehören 100% zum Thema 2. Das Dokument 4 würde gehören 80% zum Thema 2 und das 20% zum Thema 1.
Diese Zuordnung von Themen zu Dokumenten erfolgt durch die LDA-Modellierung gemäß den Schritten, die wir im vorherigen Abschnitt besprochen haben. Wenden wir nun LDA auf einige Textdaten an und analysieren die tatsächlichen Ergebnisse in Python.
Themenmodellierung mit LDA in Python:
Hemos tomado los datos de ‚Amazon Fine Food Reviews‘ de Kaggle (https://www.kaggle.com/snap/amazon-fine-food-reviews) hier, um zu veranschaulichen, wie wir die Themenmodellierung mit LDA in Python implementieren können.
Auslesen der Daten:
Wir beginnen mit dem Importieren der Pandas-Bibliothek, um die CSV-Datei zu lesen und in einem Datenrahmen zu speichern.
Pandas als pd importieren
rev = pd.read_csv(R"Bewertungen.csv")
Drehzahlkopf()
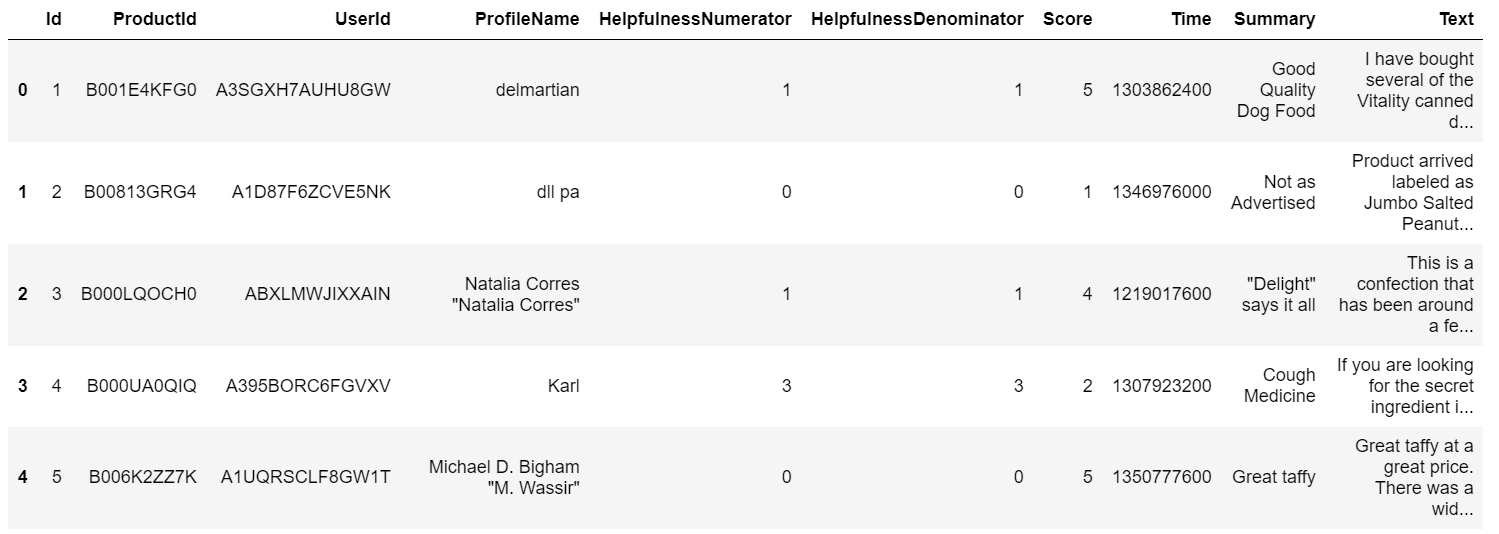
Estamos interesados en realizar un modelado de temas para la columna ‚Text‘ in diesem Datensatz.
Importieren der erforderlichen Bibliotheken:
Wir müssen die NLTK-Bibliothek importieren, da wir das Stemming für die Vorverarbeitung verwenden. Was ist mehr, wir würden auch die Stoppwörter entfernen, bevor wir die LDA durchführen. So führen Sie die Themenmodellierung durch, Wir müssen unsere Textspalte in eine vektorisierte Form konvertieren und importieren daher den TfidfVectorizer.
nltk importieren
aus nltk.corpus importieren Stoppwörter #stoppwörter
aus nltk.stem importieren WordNetLemmatizer
aus sklearn.feature_extraction.text import TfidfVectorizer
stop_words=set(nltk.corpus.stopwords.words('english'))
Vorbearbeitung des Textes:
Wir wenden die Wortstammung auf die Wörter an, sodass die Wurzelwörter aller abgeleiteten Wörter verwendet werden. Was ist mehr, Stoppwörter werden eliminiert und Wörter mit Längen größer als 3.
def clean_text(Überschrift):
      le=WordNetLemmatizer()
      word_tokens=word_tokenize(Überschrift)
      Token=[the.lemmatize(w) für w in word_tokens wenn w nicht in stop_words und len(w)>3]
        cleaned_text=" ".beitreten(Token)
      return cleaned_text
rev['cleaned_text']=rev['Text'].anwenden(clean_text)
TFIDF-Vektorisierung in der Textspalte:
Die Durchführung einer TFIDF-Vektorisierung in der Textspalte liefert uns eine Matrix von Dokumentbegriffen, auf der wir das Thema modellieren können.. TFIDF bezieht sich auf die inverse Häufigkeit von Dokumenten, da diese Vektorisierung vergleicht, wie oft ein Wort in einem Dokument vorkommt, mit der Anzahl der Dokumente, die es enthalten.
vect =TfidfVectorizer(stop_words=stop_words,max_features=1000)
vect_text=vect.fit_transform(Rev['cleaned_text'])
LDA in vektorisiertem Text:
Das ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... que le hemos dado al modelo LDA, wie im Folgenden gezeigt, die Anzahl der Themen einbeziehen, die Lernmethode (so aktualisiert der Algorithmus die Zuordnungen von Themen zu Dokumenten), die maximale Anzahl der auszuführenden Iterationen. aus und der zufällige Zustand. Die Parameter, die wir dem LDA-Modell gegeben haben, wie im Folgenden gezeigt, die Anzahl der Themen einbeziehen, die Lernmethode (so aktualisiert der Algorithmus die Zuordnungen von Themen zu Dokumenten), die maximale Anzahl der auszuführenden Iterationen. aus und der zufällige Zustand.
aus sklearn.decomposition import LatentDirichletAllocation
lda_model=LatentDirichletAllocation(n_Komponenten=10,
learning_method='online',random_state=42,max_iter=1)
lda_top=lda_model.fit_transform(vect_text)
Überprüfung der Ergebnisse:
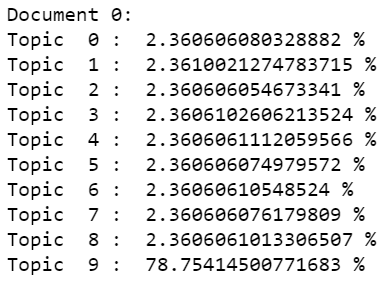
Wir können den Anteil der Themen, die dem ersten Dokument zugeordnet wurden, anhand der unten angegebenen Codezeilen überprüfen.
drucken("Dokumentieren 0: ")
für ich,Thema in Aufzählung(lda_top[0]):
  drucken("Thema ",ich,": ",Thema*100,"%")
Analysieren der Probleme:
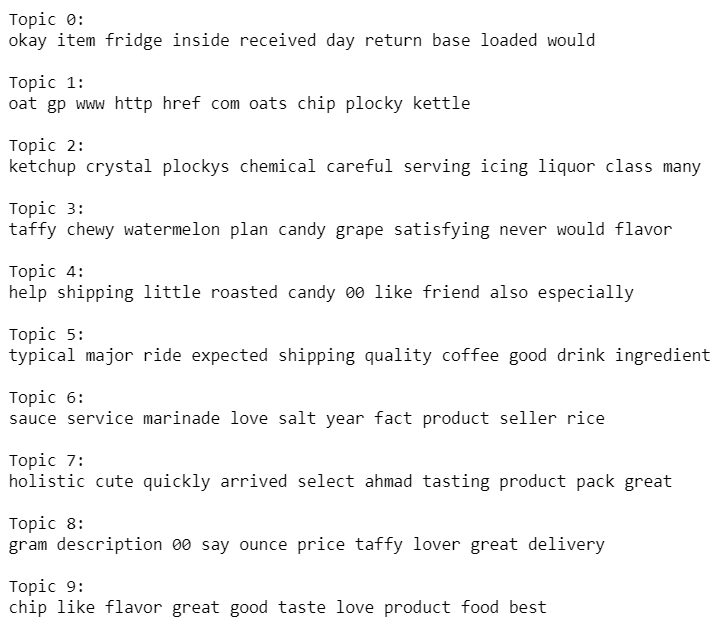
Mal sehen, was die Hauptwörter sind, aus denen die Themen bestehen. Dies würde uns eine Vorstellung davon geben, was jedes dieser Themen ausmacht..
vocab = vect.get_feature_names()
für ich, comp in aufzählen(lda_model.components_):
     vocab_comp = Reißverschluss(Vokabeln, Komp)
     sorted_words = sortiert(vocab_comp, Schlüssel = Lambda x:x[1], reverse=Wahr)[:10]
     drucken("Thema "+str(ich)+": ")
     für t in sorted_words:
            drucken(T[0],Ende=" ")
            drucken("n")
Zusätzlich zu LDA, andere Algorithmen können verwendet werden, um eine Themenmodellierung durchzuführen. Latente semantische Indizierung (LSI), Nicht-negative Matrixfaktorisierung sind einige der anderen Algorithmen, die ausprobiert werden können, um eine Themenmodellierung durchzuführen. All diese Algorithmen, als LDA, beinhalten die Extraktion von Merkmalen aus den Term-Arrays des Dokuments und die Generierung einer Gruppe von Termen, die sich voneinander unterscheiden, die schließlich zur Erstellung von Themes führen. Diese Themen können helfen, die Hauptthemen eines Korpus zu bewerten und, Daher, große Sammlungen von Textdaten organisieren.
Über den Autor
Nibedita
absolvierte seinen Master in Chemieingenieurwesen am IIT Kharagpur in 2014 Ja
arbeitet derzeit als Senior Consultant bei AbsolutData Analytics. In seinem
aktuelle Kapazität, arbeitet an der Entwicklung von KI-basierten Lösungen / ML für Kunden von
eine Vielzahl von Branchen.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





