
Dieser Artikel wurde im Rahmen der Data Science Blogathon
„Generative Adversarial Networks ist die interessanteste Idee der letzten zehn Jahre im Machine Learning“ – Yann LeCun
Einführung
mathematisches Verständnis und praktische Anwendung, aber vorher, wenn Sie einen Blick auf die Grundlagen von GAN werfen möchten, Sie können mit dem folgenden Link fortfahren:
Die meisten Tech-Giganten (wie Google, Microsoft, Amazonas, etc.) arbeiten hart daran, GANs in der Praxis anzuwenden, Einige dieser Anwendungsfälle sind:
- Adobe: Verwenden von GAN für Ihr Photoshop der nächsten Generation.
- Google: Verwenden von GAN zur Textgenerierung.
- IBM: Verwendung von GAN zur Datenerweiterung (um synthetische Bilder zu generieren, um Ihre Klassifizierungsmodelle zu trainieren).
- Snap-Chat / Tick Tack: um mehrere Bildfilter zu erstellen (die du vielleicht schon gesehen hast).
- Disney: Uso von GAN für super AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist.... (Verbesserung der Videoqualität) für deine Filme.
Das Besondere an GANs ist, dass diese Unternehmen für ihre Zukunft auf sie angewiesen sind., Glaubst du nicht??
Dann, Was hält Sie davon ab, sich das Wissen über diese epische Technologie anzueignen?? ich werde dir antworten, irgendein, Sie brauchen nur einen Vorteil und dieser Artikel würde es tun. Lassen Sie uns zuerst die Mathematik hinter Generator und Discriminator besprechen.
Mathematische Operation des Diskriminators:
Der einzige Zweck des Diskriminators besteht darin, echte und gefälschte Bilder zu klassifizieren. Zur Klassifizierung, verwendet ein rote neuronale FaltungFaltungsneurale Netze (CNN) sind eine Art von neuronaler Netzwerkarchitektur, die speziell für die Datenverarbeitung mit einer Gitterstruktur entwickelt wurde, als Bilder. Sie verwenden Faltungsschichten, um hierarchische Merkmale zu extrahieren, Dies macht sie besonders effektiv bei Mustererkennungs- und Klassifizierungsaufgaben. Dank seiner Fähigkeit, aus großen Datenmengen zu lernen, CNNs haben Bereiche wie Computer Vision revolutioniert.. (CNN) traditionell mit einer spezifischen Kostenfunktion. Der Schulungsprozess zum Diskriminierenden funktioniert wie folgt:
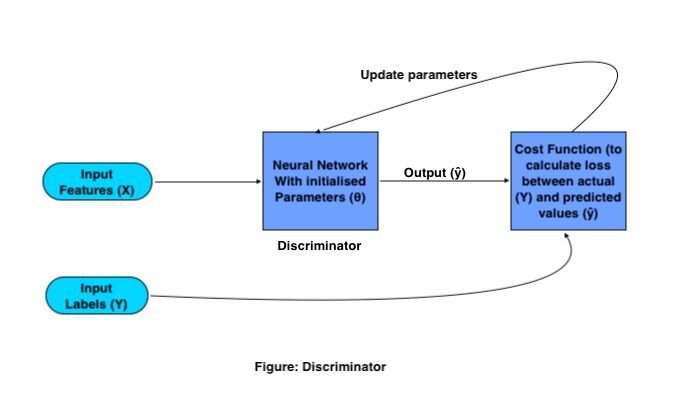
Wobei X und Y Eingabemerkmale bzw. Labels sind, die Ausgabe wird repräsentiert durch (ŷ) und das ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... von Netzwerk wird dargestellt mit (θ).
Die GANs von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... benötigen einen Satz von Trainingsbildern und deren jeweiligen Etiketten, diese Bilder gehen als Eingabefunktion an CNN, mit einem Satz initialisierter Parameter. Dieses CNN erzeugt eine Ausgabe durch Multiplizieren der Gewichtsmatrix (W) mit Eingangscharakteristik (x) und Hinzufügen eines Bias (B) darin und wandeln sie in eine nichtlineare Matrix um, indem sie sie an eine WeckfunktionDie Aktivierungsfunktion ist eine Schlüsselkomponente in neuronalen Netzen, da es den Output eines Neurons auf der Grundlage seiner Eingabe bestimmt. Sein Hauptzweck besteht darin, Nichtlinearitäten in das Modell einzuführen, Ermöglicht das Erlernen komplexer Muster in Daten. Es gibt verschiedene Aktivierungsfunktionen, wie das Sigmoid, ReLU und tanh, jedes mit besonderen Eigenschaften, die sich auf die Leistung des Modells in verschiedenen Anwendungen auswirken.....
Diese Ausgabe wird als vorhergesagte Ausgabe bezeichnet., dann wird der Verlust basierend auf den Gewichtsparametern berechnet, die im Netzwerk angepasst werden, um den Verlust zu minimieren.
Mathematische Funktionsweise des Generators:
Das Ziel des Generators ist es, ein falsches Bild aus der gegebenen Verteilung zu erzeugen (Bildersatz), es tut es mit dem folgenden Verfahren:
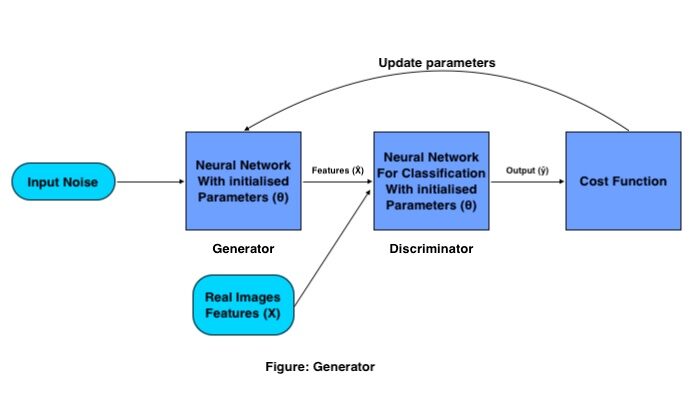
Ein Satz von Eingabevektoren wird übergeben (zufälliges Geräusch) durch das rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. des Generators, was ein ganz neues Bild erzeugt, indem die Generator-Gewichtsmatrix mit dem Eingangsrauschen multipliziert wird.
Dieses erzeugte Bild dient als Eingabe für den Diskriminator, der darauf trainiert ist, gefälschte und echte Bilder zu klassifizieren.. Dann wird der Verlust für die erzeugten Bilder berechnet, basierend darauf, welche Parameter für den Generator aktualisiert werden, bis wir eine gute Genauigkeit erhalten.
Sobald wir mit der Genauigkeit des Generators zufrieden sind, Wir speichern die Generatorgewichte und eliminieren den Diskriminator aus dem Netzwerk, und wir verwenden diese Gewichtsmatrix, um mehr neue Bilder zu erzeugen, indem wir ihr jedes Mal eine andere zufällige Rauschmatrix übergeben.
Binärer Kreuzentropieverlust für GAN:
Um GAN-Parameter zu optimieren, Wir brauchen eine Kostenfunktion, die dem Netzwerk mitteilt, wie stark es sich verbessern muss, indem wir einfach die Differenz zwischen dem tatsächlichen und dem prognostizierten Wert berechnen. Das Verlust-FunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und... die in den GANs verwendet wird, wird als binäre Kreuzentropie bezeichnet und dargestellt als:
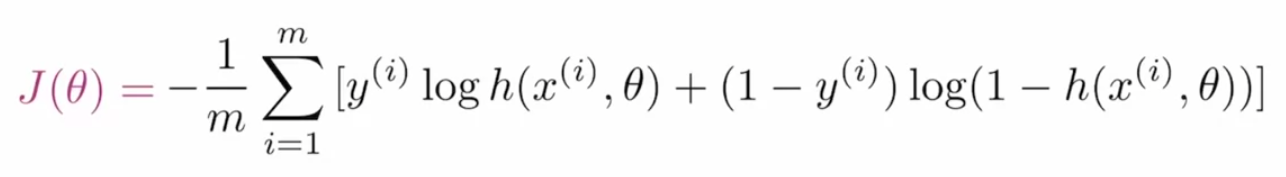
Wobei m die Chargengröße ist, Ja(ich) ist der tatsächliche Tag-Wert, h ist der vorhergesagte Labelwert, x(ich) ist die Eingangskennlinie und θ steht für den Parameter.
Lassen Sie uns diese Kostenfunktion in Unterteile aufteilen, um sie besser zu verstehen. Die angegebene Formel ist die Kombination von zwei Begriffen, wobei einer verwendet wird, wenn er wirksam ist, wenn das Label . ist „0“ und das andere ist wichtig, wenn das Etikett ist „1“. Der erste Term ist:
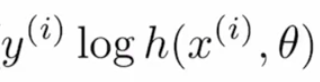
wenn der reale Wert . ist „1“ und der vorhergesagte Wert ist „~ 0“ in diesem Fall, seit log (~ 0) neigt zu negativ unendlich oder sehr hoch, und wenn der vorhergesagte Wert auch „~ 1“, dann das log ( ~ 1) wäre nah dran „0“ oder sehr weniger, Dieser Term hilft also, den Verlust für die Labelwerte zu berechnen „1“.
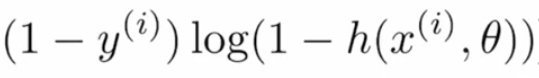
Ist der tatsächliche Wert „0“ und der vorhergesagte Wert ist „~ 1“, dann logge dich ein (1- (~ 1)) würde zu negativ unendlich oder sehr hoch führen, und wenn der vorhergesagte Wert ist „~ 0“, dann würde der Begriff Ergebnisse "~ 0" oder viel weniger Verlust liefern, dieser Begriff wird also für die tatsächlichen Tag-Werte „0“ verwendet.
Jeder der Verlustterme würde negative Werte zurückgeben, falls die Vorhersage falsch ist, die Kombination dieser Begriffe heißt Entropie (logarithmischer Verlust). Aber da es negativ ist, um es größer als "1" zu machen, wenden wir ein negatives Vorzeichen an (ist in der Hauptformel zu sehen), Anwenden dieses negativen Vorzeichens ist das, was es bewirkt Kreuzentropie (negativer logarithmischer Verlust).
Trainieren wir das erste GAN-Modell:
Wir werden ein GAN-Modell erstellen, das mit dem PyTorch-Modul handschriftliche Ziffern aus der MNIST-Datenverteilung generieren könnte.
Zuerst, Lassen Sie uns die erforderlichen Module importieren:
%matplotlib inline
numpy als np importieren
Taschenlampe importieren
import matplotlib.pyplot als plt
Dann würden wir die Daten aus dem von PyTorch bereitgestellten Submodul namens Datensätze lesen.
# Anzahl der zum Laden von Daten zu verwendenden Unterprozesse
num_workers = 0
# wie viele Proben pro Batch geladen werden sollen
batch_size = 64
# Konvertieren Sie Daten in eine Taschenlampe.FloatTensor
transform = transformiert.ToTensor()
# Holen Sie sich die Trainingsdatensätze
train_data = datasets.MNIST(Wurzel="Daten", train=Wahr,
                                   herunterladen=Wahr, transformieren=transformieren)
# Datenlader vorbereiten
train_loader = Torch.utils.data.DataLoader(train_data, batch_size=batch_size,
                                           num_workers=num_workers)
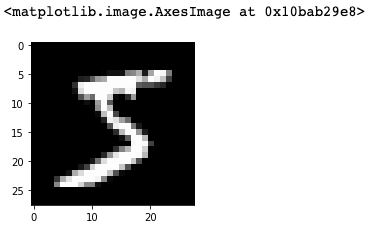
Visualisieren Sie die Daten
Da wir unser Modell im PyTorch-Framework erstellen würden, das Tensoren verwendet, wir würden unsere Daten in Brennerspanner verwandeln. Wenn Sie die Daten anzeigen möchten, Sie können fortfahren und den folgenden Codeausschnitt verwenden:
# Holen Sie sich einen Stapel Trainingsbilder
dataiter = iter(train_loader)
Bilder, Labels = dataiter.next()
images = images.numpy()
# Holen Sie sich ein Bild aus dem Stapel
img = np.squeeze(Bilder[0])
fig = plt.figur(Feigengröße = (3,3))
ax = fig.add_subplot(111)
ax.imshow(img, cmap='gray')
Diskriminiert
Jetzt ist es an der Zeit, das Discriminator-Netzwerk zu definieren, das ist die Kombination aus mehreren Schichten von CNN.
brenner.nn als nn importieren
brenner.nn.funktional als F importieren
Klasse Diskriminator(nn.Modul):
    def __init__(selbst, input_size, versteckt_dim, Ausgabegröße):
        Super(Diskriminator, selbst).__drin__()
        # Definieren Sie versteckte lineare Schichten
        self.fc1 = nn.Linear(input_size, versteckt_dim*4)
        self.fc2 = nn.Linear(versteckt_dim*4, versteckt_dim*2)
        self.fc3 = nn.Linear(versteckt_dim*2, versteckt_dim)
        # letzte vollständig verbundene Schicht
        self.fc4 = nn.Linear(versteckt_dim, Ausgabegröße)
        # Dropout-Schicht
        self.dropout = nn.Dropout(0.3)
    def vorwärts(selbst, x):
        # Bild glätten
        x = x.Ansicht(-1, 28*28)
        # alle versteckten Ebenen
        x = F.leaky_relu(self.fc1(x), 0.2) # (Eingang, negative_steigung=0.2)
        x = selbst.Ausfall(x)
        x = F.leaky_relu(self.fc2(x), 0.2)
        x = selbst.Ausfall(x)
        x = F.leaky_relu(self.fc3(x), 0.2)
        x = selbst.Ausfall(x)
        # letzte Schicht
        out = self.fc4(x)
        kehre zurück
Der obige Code folgt der traditionellen objektorientierten Python-Architektur. fc1, fc2, fc3, fc3 sind die vollständig verbundenen Schichten. Wenn wir unsere Eingabeentitäten übergeben, geht durch alle diese Schichten, beginnend mit fc1, Am Ende, Wir haben eine Abbruchschicht, die verwendet wird, um das Problem der Überanpassung zu beheben.
Im gleichen Code, Sie sehen eine Funktion namens forward (selbst, x), Diese Funktion ist die Implementierung des eigentlichen Vorwärtsausbreitungsmechanismus, bei dem jede Schicht (fc1, fc2, fc3 und fc4) folgt eine Triggerfunktion (jumping_relu ) um die Liner-Ausgabe in nichtlinear umzuwandeln.
Generatormodell
Nachdem, Wir werden das Generatorsegment von GAN . überprüfen:
Klasse Generator(nn.Modul):
    def __init__(selbst, input_size, versteckt_dim, Ausgabegröße):
        Super(Generator, selbst).__drin__()
        # Definieren Sie versteckte lineare Schichten
        self.fc1 = nn.Linear(input_size, versteckt_dim)
        self.fc2 = nn.Linear(versteckt_dim, versteckt_dim*2)
        self.fc3 = nn.Linear(versteckt_dim*2, versteckt_dim*4)
        # letzte vollständig verbundene Schicht
        self.fc4 = nn.Linear(versteckt_dim*4, Ausgabegröße)
        # Dropout-Schicht
        self.dropout = nn.Dropout(0.3)
    def vorwärts(selbst, x):
        # alle versteckten Ebenen
        x = F.leaky_relu(self.fc1(x), 0.2) # (Eingang, negative_steigung=0.2)
        x = selbst.Ausfall(x)
        x = F.leaky_relu(self.fc2(x), 0.2)
        x = selbst.Ausfall(x)
        x = F.leaky_relu(self.fc3(x), 0.2)
        x = selbst.Ausfall(x)
        # letzte Schicht mit aufgetragenem Tanh
        aus = F.tanh(self.fc4(x))
        kehre zurück
Auch das Generatornetz wird aus den vollständig verbundenen Schichten aufgebaut, die Aktivierungsfunktionen von LebenslaufDie Aktivierungsfunktion von ReLU (Gleichgerichtete Lineareinheit) Es wird aufgrund seiner Einfachheit und Effektivität häufig in neuronalen Netzen verwendet. Definiert als ( F(x) = max(0, x) ), ReLU lässt Neuronen nur dann feuern, wenn die Eingabe positiv ist, Dies hilft, das Problem des Gradientenverblassens zu mildern. Es hat sich gezeigt, dass seine Verwendung die Leistung bei verschiedenen Deep-Learning-Aufgaben verbessert, ReLU zu einer Option machen.. mit Leckage und Dropout. Der einzige Unterschied zu Discriminator besteht darin, dass er abhängig vom Parameter output_size ausgibt (Wie groß ist das zu generierende Bild?).
Hyperparameter-Tuning
Die Hyperparameter, die wir zum Trainieren der GANs verwenden werden, sind:
# Diskriminator-Hyperparameter
# Größe des Eingangsbilds zum Diskriminator (28*28)
input_size = 784
# Größe des Diskriminatorausgangs (echt oder Fälschung)
d_output_size = 1
# Größe der letzten versteckten Schicht im Diskriminator
d_hidden_size = 32
# Generator-Hyperparameter
# Größe des latenten Vektors, der dem Generator übergeben werden soll
z_größe = 100
# Größe des Diskriminatorausgangs (generiertes Bild)
g_output_size = 784
# Größe der ersten versteckten Schicht im Generator
g_hidden_size = 32
Erstellen Sie eine Instanz der Modelle
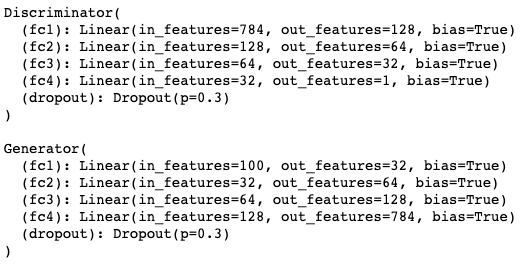
Und schlussendlich, das gesamte netzwerk würde so aussehen:
# instanziieren Sie Diskriminator und Generator
D = Diskriminator(input_size, d_hidden_size, d_output_size)
G = Generator(z_größe, g_hidden_size, g_output_size)
# Überprüfen Sie, ob sie so sind, wie Sie es erwarten
drucken(D)
drucken( )
drucken(g)
Verluste berechnen
Wir haben den Generator und den Diskriminator definiert, jetzt ist es an der Zeit, Ihre Verluste zu definieren, damit sich diese Netzwerke im Laufe der Zeit verbessern. Für das GAN hätten wir zwei echte Verluste der Verlustfunktion und einen falschen Verlust, die so definiert würden:
# Verluste berechnen
def real_loss(D_out, glatt=Falsch):
    batch_size = D_out.size(0)
    # Etikettenglättung
    wenn glatt:
        # glatt, echte etiketten = 0.9
        Labels = fackel.ones(batch_size)*0.9
    anders:
        Labels = fackel.ones(batch_size) # echte etiketten = 1
    # numerisch stabiler Verlust
    Kriterium = nn.BCEWithLogitsLoss()
    # Verlust berechnen
    Verlust = Kriterium(D_out.squeeze(), Etiketten)
    Rückflussdämpfung
auf jeden Fall fake_loss(D_out):
    batch_size = D_out.size(0)
    Labels = fackel.null(batch_size) # gefälschte Etiketten = 0
    Kriterium = nn.BCEWithLogitsLoss()
    # Verlust berechnen
    Verlust = Kriterium(D_out.squeeze(), Etiketten)
    Rückflussdämpfung
Optimierer
Sobald die Verluste definiert sind, wir würden einen geeigneten Optimierer für das Training auswählen:
brenner.optim als optim importieren
# Optimierer
lr = 0.002
# Optimierer für den Diskriminator und Generator erstellen
d_optimizer = optim.Adam(D.Parameter(), lr)
g_optimizer = optim.Adam(G.Parameter(), lr)
Modelltraining
Da wir Generator und Diskriminator definiert haben, sind beide Netzwerke, seine Verlustfunktionen als Optimierer, Jetzt würden wir die Zeiten und andere Merkmale nutzen, um das gesamte Netzwerk zu trainieren.
Essiggurke als pkl . importieren
# Hyperparameter trainieren
num_epochen = 100
# Verfolgen Sie den Verlust und die generierten, "gefälscht" Proben
Proben = []
Verluste = []
print_every = 400
# Holen Sie sich einige feste Daten für die Probenahme. Dies sind Bilder, die gehalten werden
# konstant während des Trainings, and allow us to inspect the model's performance
sample_size=16
fixed_z = np.random.uniform(-1, 1, Größe=(Beispielgröße, z_größe))
fixed_z = fackel.from_numpy(fixed_z).schweben()
# das Netzwerk trainieren
D.Zug()
G.Zug()
für Epoche in Reichweite(Anzahl_Epochen):
    für Batch_i, (real_images, _) aufzählen(train_loader):
        batch_size = real_images.size(0)
        ## Wichtiger Schritt zur Neuskalierung ##
        reale_images = reale_images*2 - 1  # Eingabebilder neu skalieren von [0,1) zu [-1, 1)
        # ============================================
        #            SCHULE DEN DISKRIMINATOR
        # ============================================
        d_optimizer.zero_grad()
        # 1. Trainiere mit echten Bildern
        # Berechnen Sie die Diskriminatorverluste auf realen Bildern
        # glätten Sie die echten Etiketten
        D_real = D(real_images)
        d_real_loss = real_loss(D_real, glatt=wahr)
        # 2. Trainiere mit gefälschten Bildern
        # Gefälschte Bilder erstellen
        # gradients don't have to flow during this step
        with torch.no_grad():
            z = np.zufällig.gleichmäßig(-1, 1, Größe=(batch_size, z_größe))
            z = fackel.from_numpy(Mit).schweben()
            fake_images = G(Mit)
        # Berechnen Sie die Diskriminatorverluste bei gefälschten Bildern
        D_fake = D(fake_images)
        d_fake_loss = fake_loss(D_fake)
        # Verluste aufsummieren und Backprop durchführen
        d_loss = d_real_loss + d_fake_loss
        d_loss.backward()
        d_optimizer.step()
        # =========================================
        #            TRAINIEREN SIE DEN GENERATOR
        # =========================================
        g_optimizer.zero_grad()
        # 1. Trainiere mit gefälschten Bildern und umgedrehten Etiketten
        # Gefälschte Bilder erstellen
        z = np.zufällig.gleichmäßig(-1, 1, Größe=(batch_size, z_größe))
        z = fackel.from_numpy(Mit).schweben()
        fake_images = G(Mit)
        # Berechnen Sie die Diskriminatorverluste bei gefälschten Bildern
        # mit umgedrehten Etiketten!
        D_fake = D(fake_images)
        g_loss = echter_verlust(D_fake) # Verwenden Sie echten Verlust, um Etiketten umzudrehen
        # Backprop durchführen
        g_loss.backward()
        g_optimizer.step()
        # Drucken Sie einige Verluststatistiken
        wenn batch_i % print_every == 0:
            # Druckdiskriminator und Generatorverlust
            drucken('Epoche [{:5D}/{:5D}] | d_loss: {:6.4F} | Glanz: {:6.4F}'.format(
                    Epoche+1, Anzahl_Epochen, d_loss.item(), g_loss.item()))
    ## NACH JEDER EPOCHE##
    # Diskriminatorverlust und Generatorverlust anhängen
    Verluste.anhängen((d_loss.item(), g_loss.item()))
    # Probe generieren und speichern, gefälschte Bilder
    G.eval() # eval mode zum Generieren von Samples
    Proben_z = G(fixed_z)
    proben.anhängen(Proben_z)
    G.Zug() # zurück zum Zugmodus
# Beispiele für Trainingsgeneratoren speichern
mit offen('train_samples.pkl', 'wb') als f:
    pkl.dump(Proben, F)
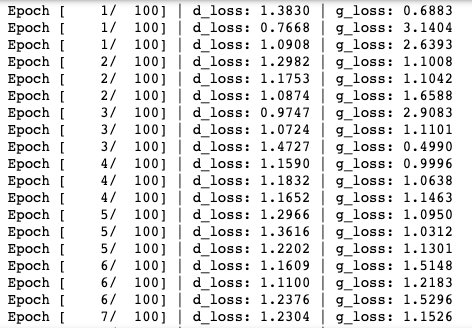
Sobald Sie das obige Code-Snippet ausführen, der Ausbildungsprozess würde so beginnen:
Bilder erstellen
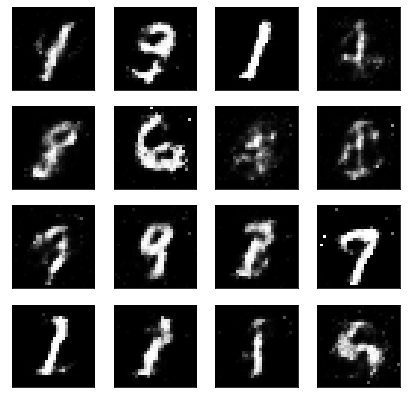
Schließlich, wenn das Modell trainiert ist, Sie können den trainierten Generator verwenden, um die neuen handschriftlichen Bilder zu erzeugen.
# zufällig generiert, neue latente Vektoren
sample_size=16
rand_z = np.random.uniform(-1, 1, Größe=(Beispielgröße, z_größe))
rand_z = fackel.from_numpy(rand_z).schweben()
G.eval() # Bewertungsmodus
# generierte Samples
rand_images = G(rand_z)
# 0 zeigt den ersten Satz von Mustern in der Liste der übergebenen an
# und wir haben nur eine Charge von Mustern, Hier
view_samples(0, [rand_images])
Die mit dem folgenden Code generierte Ausgabe würde in etwa so aussehen:
Dann, Jetzt haben Sie Ihr eigenes trainiertes GAN-Modell, Sie können dieses Modell verwenden, um Sie an einem anderen Satz von Bildern zu trainieren, um neue unsichtbare Bilder zu erzeugen.
Verweise:
1. Tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... von Udacity: https://www.udacity.com/
2. Künstliche Intelligenz mit tiefem Lernen: https://www.deeplearning.ai/
Danke, dass du diesen Artikel gelesen hast. Wenn Sie etwas Neues gelernt haben, Kommentieren Sie gerne! Wir sehen uns beim nächsten Mal! !!! ️
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





