
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Clusteranalyse oder Clusterbildung ist ein unüberwachter Machine-Learning-Algorithmus, der unbeschriftete Datensätze gruppiert. Ihr Ziel ist es, Cluster oder Gruppen zu bilden, indem die Datenpunkte in einem Datensatz so verwendet werden, dass eine hohe Ähnlichkeit innerhalb der Cluster und eine geringe Ähnlichkeit zwischen den Clustern besteht. In einfachen Worten, Clusterbildung zielt darauf ab, Teilmengen oder Gruppen innerhalb eines Datensatzes zu bilden, die aus Datenpunkten bestehen, die wirklich ähnlich zueinander sind, und die gebildeten Gruppen oder Teilmengen oder Cluster können sich deutlich voneinander unterscheiden.
Warum clustern?
Supongamos que tenemos un conjunto de datos y no sabemos nada al respecto. Dann, un algoritmo de GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. puede descubrir grupos de objetos donde las distancias promedio entre los miembros / puntos de datos de cada grupo están más cerca que a los miembros / puntos de datos en otros grupos.
Algunas de las aplicaciones prácticas de Clustering en la vida real como:
1) SegmentierungDie Segmentierung ist eine wichtige Marketingtechnik, bei der ein breiter Markt in kleinere, homogenere Gruppen unterteilt wird. Diese Praxis ermöglicht es Unternehmen, ihre Strategien und Botschaften an die spezifischen Merkmale jedes Segments anzupassen, So verbessern Sie die Effektivität Ihrer Kampagnen. Das Targeting kann auf demografischen Kriterien basieren, psychografisch, geografisch oder verhaltensbezogen, Erleichterung einer relevanteren und persönlicheren Kommunikation mit der Zielgruppe.... von Kunden: Encontrar un grupo de clientes con un comportamiento similar dada una gran DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... von Kunden (se da un ejemplo práctico usando la segmentación de clientes bancarios)
2) Clasificación del tráfico de la red: Agrupación de características de las fuentes de tráfico. Los tipos de tráfico se pueden clasificar fácilmente mediante clústeres.
3) Filtro de correo no deseado: Los datos se agrupan en diferentes secciones (Header, remitente y contenido) und dann können sie helfen, welche von ihnen Spam sind, zu klassifizieren.
4)Stadtplanung: Gruppierung von Häusern nach ihrem geografischen Standort, Wert und Art des Hauses.
Verschiedene Arten von Clustering-Algorithmen
1) Gruppierung von K-Strümpfen – Mit diesem Algorithmus, klassifizieren wir einen gegebenen Datensatz durch eine bestimmte Anzahl vorgegebener Cluster oder „k“ Cluster.
2) Hierarchische Gruppierung – Es folgen zwei Ansätze: Divisiv und Agglomerativ.
Agglomerativ betrachtet jede Beobachtung als einzelne Gruppe und gruppiert dann ähnliche Datenpunkte, bis sie zu einer einzigen Gruppe verschmolzen sind, und Divisiv funktioniert genau umgekehrt.
3) Fuzzy C bedeutet Clustering – Die Funktionsweise des FCM-Algorithmus ist fast identisch mit dem k-Mittelwert-Clustering-Algorithmus, la principal diferencia es que en FCM un punto de datos se puede colocar en más de un grupo.
4) Agrupación espacial basada en densidad – Útil en las áreas de aplicación donde requerimos estructuras de ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... no lineales, basadas puramente en la densidad.
Jetzt, aquí en este artículo, nos centraremos profundamente en el algoritmo de agrupamiento de k-medias, explicaciones teóricas del funcionamiento de k-medias, Vorteile und Nachteile, y un problema de agrupamiento práctico resuelto que mejorará la comprensión teórica y le dará una visión adecuada. de cómo funciona la agrupación en clústeres de k-medias.
Dass es ist k-halb Clustering?
La agrupación de K-Means es un algoritmo de Unüberwachtes LernenUnüberwachtes Lernen ist eine Technik des maschinellen Lernens, die es Modellen ermöglicht, Muster und Strukturen in Daten ohne vordefinierte Beschriftungen zu identifizieren. Durch Algorithmen wie k-means und Hauptkomponentenanalyse, Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, wie z. B. Kundensegmentierung, Anomalieerkennung und Datenkomprimierung. Seine Fähigkeit, verborgene Informationen preiszugeben, macht es zu einem wertvollen Werkzeug in der..., que se utiliza para agrupar el conjunto de datos sin etiquetar en diferentes grupos / Teilmengen.
Ahora debe estar preguntándose qué significa ‚k‘ Ja ‚es bedeutet‘ en el k-means Clustering significa ??
Dejando de lado todas sus suposiciones aquí, ‚k‘ define el número de grupos predefinidos que deben crearse en el proceso de agrupación, digamos que si k = 2, habrá dos grupos, y para k = 3, habrá tres grupos y así sucesivamente. Como es un algoritmo basado en centroide, ‚Medien‘ en el agrupamiento de k-medias está relacionado con el centroide de los puntos de datos donde cada grupo está asociado con un centroide. El concepto de un algoritmo basado en centroide se explicará en la explicación de trabajo de k-medias.
Hauptsächlich, el algoritmo de agrupación en clústeres de k-means realiza dos tareas:
- Determina el valor más óptimo para K puntos centrales o centroides mediante un proceso repetitivo.
- Asigna cada punto de datos a su centro k más cercano. El clúster se crea con puntos de datos que están cerca del centro k particular.
¿Cómo funciona la agrupación en clústeres de k-means?
Supongamos que tenemos dos variables X1 y X2, AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen.... dann:
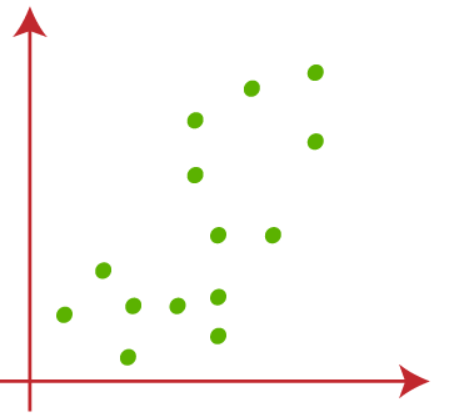
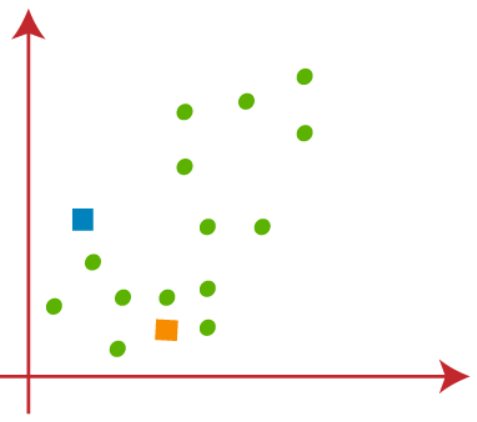
(1) Supongamos que el valor de k, que es el número de grupos predefinidos, es ist 2 (k = 2), por lo que aquí agruparemos nuestros datos en 2 Gruppen.
Es necesario elegir k puntos aleatorios para formar los grupos. No pueden existir restricciones en la selección de k puntos aleatorios desde el interior de los datos ni desde el exterior. Dann, aquí estamos considerando 2 puntos como k puntos (que no forman parte de nuestro conjunto de datos) die im Folgenden gezeigt werden Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen....:
(2) Der nächste Schritt besteht darin, jeden Datenpunkt des Datensatzes im Streudiagramm dem nächstgelegenen K-Punkt zuzuordnen, dies wird durch Berechnung der euklidischen Entfernung zwischen jedem Punkt und einem K-Punkt und durch Zeichnen einer MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... zwischen beiden Zentroiden, die in der folgenden Abbildung gezeigt wird-
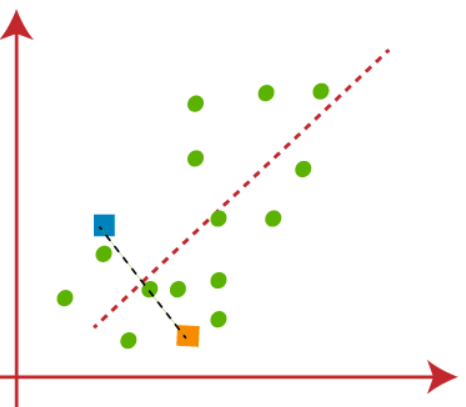
Wir können deutlich erkennen, dass der Punkt links von der roten Linie in der Nähe von K1 oder dem blauen Zentroiden liegt und die Punkte rechts von der roten Linie in der Nähe von K2 oder dem orangefarbenen Zentroiden liegen.
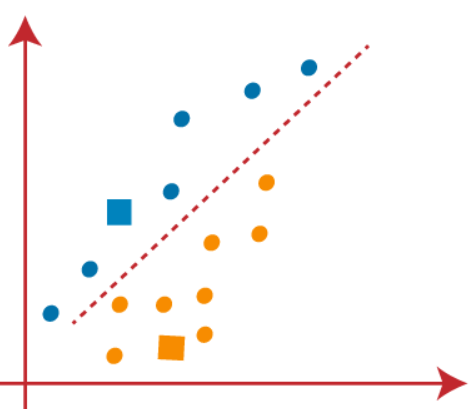
(3) Da wir den nächstgelegenen Punkt finden müssen, wiederholen wir den Vorgang, indem wir einen neuen Zentroiden wählen. So wählen Sie die neuen Schwerpunkte, Wir werden das Schwerpunkt dieser Zentroiden berechnen und neue Zentroiden wie unten gezeigt finden:
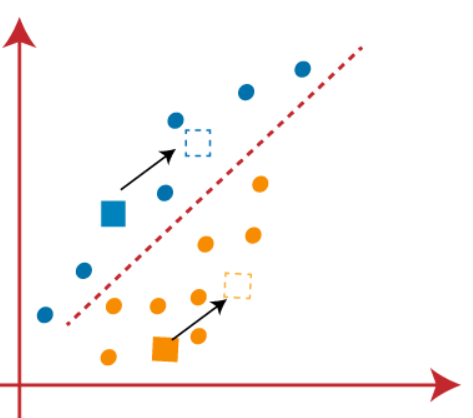
(4) Jetzt, Wir müssen jeden Datenpunkt einem neuen Zentroid zuweisen. Dafür, Wir müssen denselben Vorgang zur Bestimmung einer Mittellinie wiederholen. Die Mittellinie wird wie folgt aussehen:
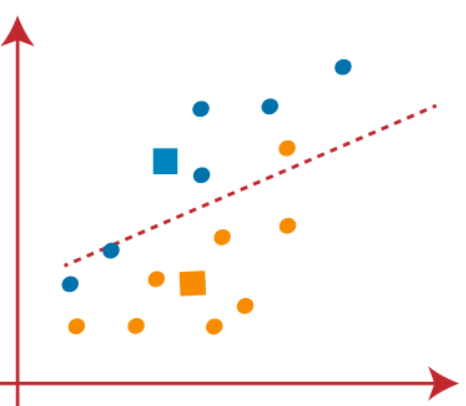
Im Bild oben, Wir sehen, Ein orangefarbener Punkt befindet sich auf der linken Seite der Linie und zwei blaue Punkte liegen direkt auf der Linie. Dann, Diese drei Punkte werden den neuen Zentroiden zugewiesen

Wir werden weiterhin neue Zentroiden finden, bis es keine unterschiedlichen Punkte auf beiden Seiten der Linie gibt.
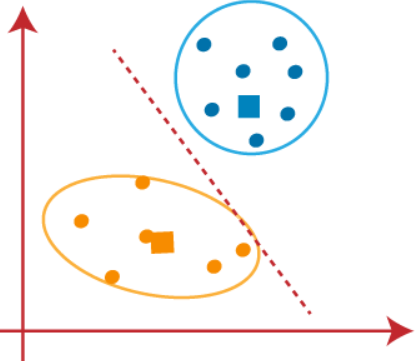
Jetzt können wir die angenommenen Zentroiden entfernen, Und die beiden endgültigen Gruppen werden wie auf dem Bild unten gezeigt sein
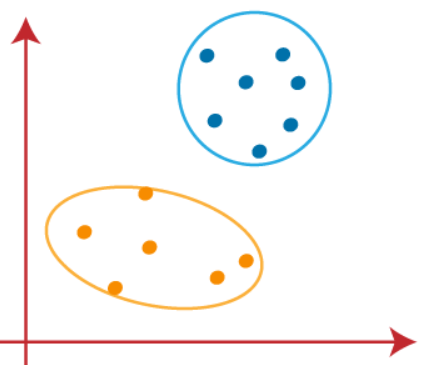
Hasta ahora hemos visto cómo funciona el algoritmo de k-medias y los distintos pasos involucrados para llegar al destino final de los clusters diferenciadores.
Ahora todos deben estar preguntándose cómo elegir el valor de k número de clusters.
El rendimiento del algoritmo de agrupación de K-means depende en gran medida de las agrupaciones que forma. Elegir el número óptimo de clústeres es una tarea difícil. Hay varias formas de encontrar el número óptimo de conglomerados, pero aquí estamos discutiendo dos métodos para encontrar el número de conglomerados o el valor de K que es el Método del codo y puntuación de la silueta.
Método del codo para encontrar ‚k‘ número de grupos:[1]
Die Elbow-Methode ist die beliebteste Methode, um eine optimale Anzahl von Clustern zu finden, Diese Methode verwendet WCSS (Summe der Quadrate innerhalb der Cluster) Die die gesamten Variationen innerhalb eines Clusters darstellt.
WCSS = ∑Pi im Cluster1 Distanz (Pich C1)2 + ΣPi im Cluster2Distanz (Pich C2)2+ ΣPi im Cluster3 Distanz (Pich C3)2
In der obigen Formel ist ∑Pi im Cluster1 Distanz (Pich C1)2 die Summe der Quadrate der Abstände zwischen jedem Datenpunkt und seinem Schwerpunkt innerhalb einer Gruppe1, ähnlich für die beiden anderen Terme in der obigen Formel.
Schritte, die in der Elbow-Methode enthalten sind:
- K- Bedeutet, dass das Clustering für verschiedene Werte von k durchgeführt wird (von 1 ein 10).
- WCSS wird für jedes Cluster berechnet.
- Es wird eine Kurve zwischen den WCSS-Werten und der Anzahl der Cluster k geplottet.
- Der scharfe Knickpunkt oder ein Punkt im Diagramm sieht wie ein Arm aus, dann wird dieser Punkt als der beste K-Wert betrachtet.
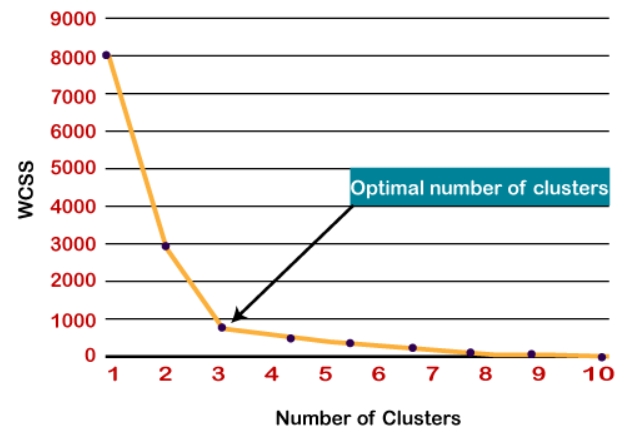
Also hier, wie wir sehen können, eine ausgeprägte Kurve liegt bei k = 3, daher ist die optimale Anzahl der Gruppen 3.
Silhouettenwert Methode zur Bestimmung ‚k‘ Anzahl der Cluster
Der Silhouettenwert ist ein Maß dafür, wie ähnlich ein Objekt seiner eigenen Gruppe ist (Kohäsion) im Vergleich zu anderen Gruppen (Trennung). Die Silhouette reicht von -1 ein +1, wobei ein hoher Wert anzeigt, dass das Objekt gut zu seiner eigenen Gruppe passt und nicht zu den benachbarten Gruppen. Wenn die meisten Objekte einen hohen Wert haben, dann ist die Cluster-Konfiguration geeignet. Wenn viele Punkte einen niedrigen oder negativen Wert haben, dann kann die Konfiguration des Clusterings entweder zu viele oder zu wenige Cluster haben.
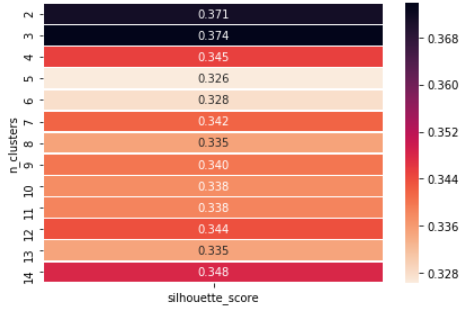
Beispiel, das zeigt, wie wir den Wert wählen können von ‚k‘, da wir sehen können, dass bei n = 3 haben wir den maximalen Silhouette-Score, Daher, wir wählen den Wert k = 3.
Vorteile der Verwendung von K-Means-Clustering
- Einfach zu implementieren.
- Bei einer großen Anzahl von Variablen, K-Means kann rechnerisch schneller sein als hierarchisches Clustering (wenn K klein ist).
- K-Means kann höhere Clusterqualität erzeugen als hierarchisches Clustering.
Nachteile der Verwendung von K-Means-Clustering
Es ist schwierig, die Anzahl der Cluster vorherzusagen (K-Wert).
Die anfänglichen Seed-Werte haben einen starken Einfluss auf die Endergebnisse.
Implementación práctica del algoritmo de agrupación en clústeres K-means utilizando Python (segmentación de clientes bancarios)
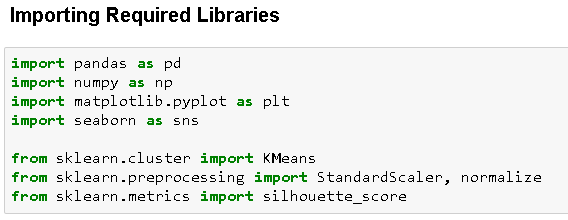
Aquí estamos importando las bibliotecas necesarias para nuestro análisis.
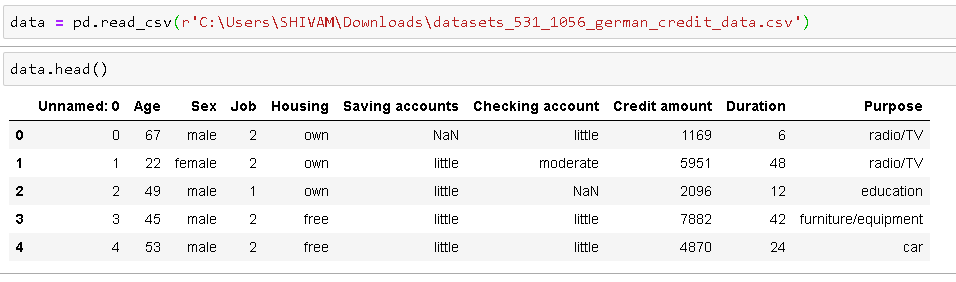
Leer los datos y obtener las 5 mejores observaciones para echar un vistazo al conjunto de datos
No se ha incluido el código para EDA (Explorative Datenanalyse), se realizó EDA con estos datos y se realizó un análisis de valores atípicos para limpiar los datos y hacerlos aptos para nuestro análisis.
Wie wir wissen, las K-medias se realizan solo en los datos numéricos, por lo que elegimos las columnas numéricas para nuestro análisis.
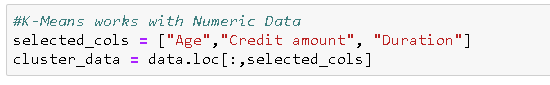
Jetzt, para realizar la agrupación de k-medias como se discutió anteriormente en este artículo, wir müssen den Wert der Anzahl der Gruppen finden ‚k‘ und wir können dies mit folgendem Code tun, hier verwenden wir mehrere k-Werte für die Gruppierung und wählen dann unter Verwendung des Ellbogenmethode.
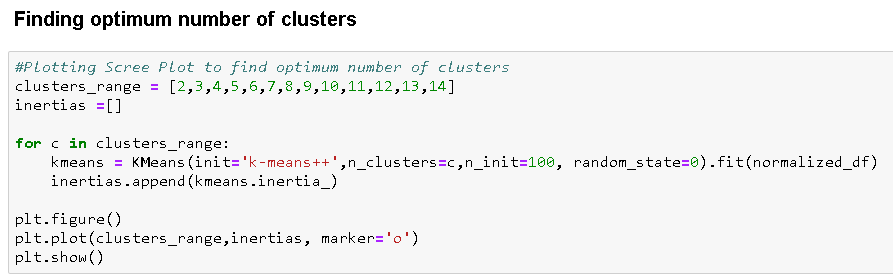
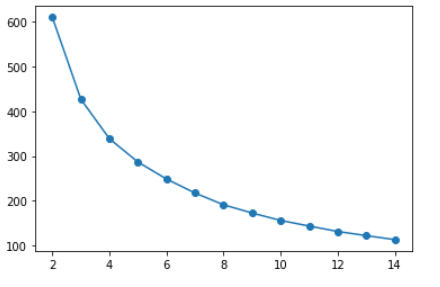
Wenn die Anzahl der Cluster zunimmt, die abweichung (Summe der Quadrate innerhalb des Clusters) nimmt ab. Der Knick bei 3 Ö 4 Gruppen stellt das ausgewogenste Verhältnis zwischen der Minimierung der Anzahl der Gruppen und der Minimierung der Varianz innerhalb jeder Gruppe dar, daher können wir einen k-Wert wählen, der 3 Ö 4
Jetzt wird gezeigt, wie wir die Silhouettenmethode verwenden können, um den Wert von zu finden ‚k‘.

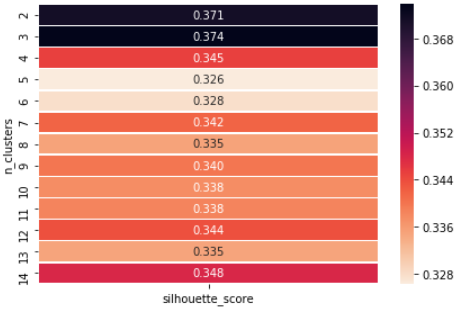
Wenn wir beobachten, erhalten wir die optimale Anzahl der Cluster bei n = 3, daher können wir schließlich den Wert von k = wählen 3.
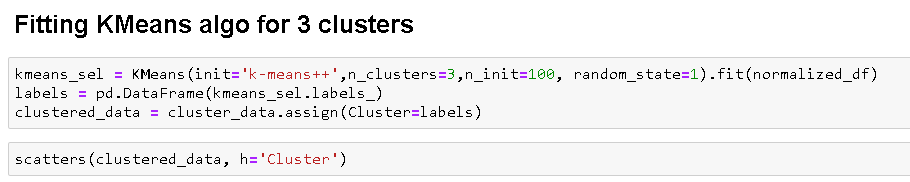
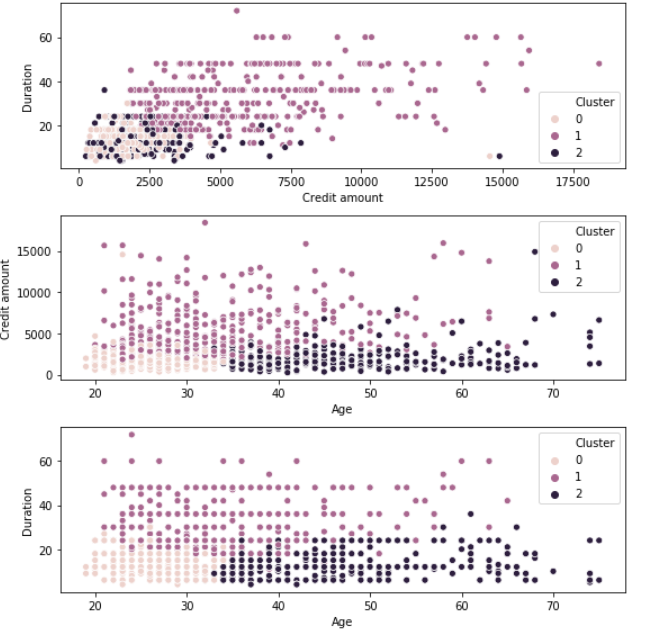
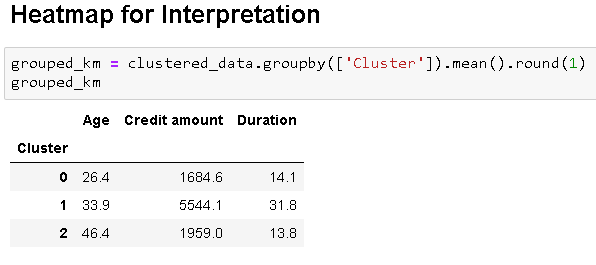
Jetzt, den k-Mittelwert-Algorithmus unter Verwendung des Wertes k = anpassen 3 und den Verlauf für die Cluster zeichnen Heatmapein "Heatmap" ist eine grafische Darstellung, die Farben verwendet, um die Dichte von Daten in einem bestimmten Bereich anzuzeigen. Häufig in der Datenanalyse verwendet, Marketing und Verhaltensstudien, Diese Art der Visualisierung ermöglicht es Ihnen, Muster und Trends schnell zu erkennen. Durch chromatische Variationen, Heatmaps erleichtern die Interpretation großer Informationsmengen, dabei helfen, fundierte Entscheidungen zu treffen.... für die Cluster.
Abschließende Analyse
Cluster 0: junge Kunden, die Kredite mit niedrigem Kreditwert über einen kurzen Zeitraum erhalten
Gruppe 1: mittlere Alterskunden, die Kredite mit hohem Kreditwert über einen längeren Zeitraum erhalten
Gruppe 2: ältere Kunden, die Kredite mittlerer Höhe über einen kurzen Zeitraum erhalten
Fazit
Wir haben besprochen, was Clusteranalyse ist, ihre Arten und ihre Anwendung in verschiedenen Branchen. Wir haben besprochen, was K-Means-Clustering ist, wie der K-Means-Clustering-Algorithmus funktioniert, zwei Methoden zur Auswahl der Anzahl ‚k‘ der Cluster, und deren Vor- und Nachteile. Später, pasamos por la implementación práctica del algoritmo de agrupación en clústeres de k-medias utilizando el problema de segmentación de clientes bancarios en Python.
Verweise:
(1) img (1) a img (8) Ja [1] , referencia tomada del „Algoritmo de agrupación en clústeres de K-medias“
https://www.javatpoint.com/k-means-clustering-algorithm-in-machine-learning





