
Notiz: Dieser Beitrag wurde ursprünglich veröffentlicht auf 13 September 2015 und aktualisiert die 11 September 2017
Überblick
- Verstehen Sie einen der beliebtesten und einfachsten Machine-Learning-Klassifikationsalgorithmen, der Naive-Bayes-Algorithmus
- Er basiert auf dem Bayes-Theorem, um Wahrscheinlichkeiten und bedingte Wahrscheinlichkeiten zu berechnen.
- Lernen Sie, wie Sie den Naive-Bayes-Klassifikator in R und Python anwenden
Einführung
Hier ist eine Situation, in der Sie sich befinden Datenwissenschaft Luftzug:
Sie arbeiten an einem Klassifikationsproblem und haben Ihren Hypothesensatz erstellt, Merkmale erstellt und die Relevanz der Variablen diskutiert. In einer Stunde, möchten die Stakeholder den ersten Entwurf des Modells sehen.
Was werden Sie tun? Sie haben Hunderte von Datenpunkten und ziemlich viele Variablen in Ihrem Datensatz AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen..... In solch einer Situation, wenn ich an Ihrer Stelle wäre, hätte verwendet ‚Bayes ingenuo‚, das extrem schnell sein kann, wenn es mit anderen verbunden wird Klassifikationsalgorithmen. Es arbeitet mit dem Bayes'schen Wahrscheinlichkeitsgesetz, um die Klasse unbekannter Datensätze vorherzusagen.
In diesem Beitrag, Ich werde die Grundlagen dieses Algorithmus erklären, damit Sie beim nächsten Mal, wenn Sie auf große Datensätze stoßen, diesen Algorithmus in Aktion setzen können. Zur selben Zeit, wenn Sie ein Anfänger in Python sind das R, Sie sollten sich nicht von den im Beitrag verfügbaren Codes überwältigt fühlen.
Wenn Sie es vorziehen, das Naive-Bayes-Theorem von den Grundlagen bis zur Implementierung strukturiert zu lernen, Sie können sich kostenlos in diesen Kurs einschreiben:
Sind Sie ein Anfänger im Machine Learning? Beabsichtigen Sie, maschinelle Lernalgorithmen wie Naive Bayes zu beherrschen? Hier ist ein vollständiger Kurs, der maschinelles Lernen und Algorithmen abdeckt tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... im Detail:
Projekt zur Anwendung von Naive BayesProblemstellungHR Analytics revolutioniert die Arbeitsweise von HR-Abteilungen, führt zu höherer Effizienz und insgesamt besseren Ergebnissen. Die Personalabteilung hat genutzt AnalyseAnalytics bezieht sich auf den Prozess des Sammelns, Messen und analysieren Sie Daten, um wertvolle Erkenntnisse zu gewinnen, die die Entscheidungsfindung erleichtern. In verschiedenen Bereichen, wie Business, Gesundheit und Sport, Analysen können Muster und Trends erkennen, Prozesse optimieren und Ergebnisse verbessern. Der Einsatz fortschrittlicher Werkzeuge und statistischer Techniken ist unerlässlich, um Daten in anwendbares und strategisches Wissen umzuwandeln.... im Laufe der Jahre. Trotz dieses, die Zusammenstellung, Die Datenverarbeitung und -analyse erfolgte weitgehend manuell und, Angesichts der Natur der Dynamik der Personalabteilung und der KPIKennzahlen, o Wichtige Leistungsindikatoren, Dabei handelt es sich um Kennzahlen, die von Organisationen verwendet werden, um ihren Erfolg beim Erreichen bestimmter Ziele zu bewerten. Diese Indikatoren ermöglichen es Ihnen, den Fortschritt zu überwachen und fundierte Entscheidungen zu treffen. Es gibt verschiedene Arten von KPIs, die je nach Branche und den strategischen Zielen des Unternehmens variieren kann. Die korrekte Umsetzung ist unerlässlich, um die Effizienz und Effektivität der Abläufe zu verbessern.... der Personalabteilung, der Fokus hat sich auf die Humanressourcen beschränkt. Deswegen, Es ist überraschend, dass die Personalabteilungen so spät im Spiel die Nützlichkeit von maschinellem Lernen erkannt haben. Dies ist eine Möglichkeit, Predictive Analytics zu testen, um die Mitarbeiter zu identifizieren, die am wahrscheinlichsten befördert werden. |
Inhaltsverzeichnis
- Was ist der Naive-Bayes-Algorithmus?
- Wie funktionieren die Naive-Bayes-Algorithmen?
- Was sind die Vor- und Nachteile der Verwendung von Naive Bayes?
- 4 Anwendungen des Naive-Bayes-Algorithmus
- Schritte zum Aufbau eines grundlegenden Naive-Bayes-Modells in Python
- Tipps zur Steigerung der Leistungsfähigkeit des Naive-Bayes-Modells
Was ist der Naive-Bayes-Algorithmus?
Es ist ein Klassifizierungstechnik Basierend auf dem Bayes-Theorem mit der Annahme der Unabhängigkeit zwischen Prädiktoren. In einfachen Worten, Ein Naive-Bayes-Klassifikator geht davon aus, dass das Vorhandensein eines bestimmten Merkmals in einer Klasse nicht mit dem Vorhandensein eines anderen Merkmals zusammenhängt.
Als Beispiel, Eine Frucht kann als Apfel betrachtet werden, wenn sie rot, rund ist und ungefähr 3 Zoll im Durchmesser misst. Auch wenn diese Merkmale voneinander oder von der Existenz anderer Merkmale abhängen, alle diese Eigenschaften unabhängig zur Wahrscheinlichkeit beitragen, dass diese Frucht ein Apfel ist, und deshalb wird sie als ‚Naive‘.
Das Naive-Bayes-Modell ist einfach zu erstellen und insbesondere für sehr große Datensätze nützlich. Zusammen mit der Einfachheit, ist bekannt, dass Naive Bayes sogar hochentwickelte Klassifikationsmethoden übertrifft.
El teorema de Bayes proporciona una forma de calcular la probabilidad posterior P (C | x) a partir de P (C), P (x) y P (x | C). Mira la próxima ecuación:
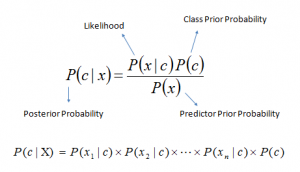 Über,
- PAG(C | x) es la probabilidad posterior de Klasse (C, Zielsetzung) Würfel vaticinador (x, Attribute).
- PAG(C) es la probabilidad previa de Klasse.
- PAG(x | C) es la probabilidad que es la probabilidad de vaticinador Würfel Klasse.
- PAG(x) es la probabilidad previa de vaticinador.
¿Cómo funciona el algoritmo Naive Bayes?
Lass es uns mit einem Beispiel verstehen. A continuación tengo un conjunto de datos de entrenamiento del clima y la VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... objetivo respectivo ‚Spiel‘ (que sugiere posibilidades de juego). Jetzt, debemos categorizar si los jugadores jugarán o no según las condiciones climáticas. Sigamos los pasos a continuación para realizarlo.
Paso 1: convierta el conjunto de datos en una tabla de frecuencias
Paso 2: Cree una tabla de probabilidad encontrando las probabilidades como la probabilidad de Nublado = 0.29 y la probabilidad de jugar es 0.64.
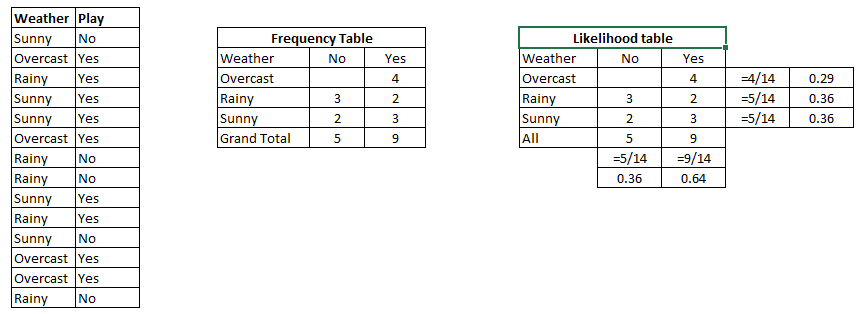
Paso 3: jetzt, Verwendet Ingenuo bayesiano ecuación para calcular la probabilidad posterior para cada clase. La clase con la probabilidad posterior más alta es el resultado de el pronóstico.
Ärger: Los jugadores jugarán si el clima es soleado. ¿Esta afirmación es correcta?
Podemos resolverlo usando el método de probabilidad posterior discutido previamente.
P (Jawohl | Soleado) = P (Soleado | Jawohl) * P (Jawohl) / P (Soleado)
Aquí tenemos P (Soleado | Jawohl) = 3/9 = 0.33, P (Soleado) = 5/14 = 0.36, P (Jawohl) = 9/14 = 0.64
Jetzt, P (Jawohl | Soleado) = 0.33 * 0.64 / 0.36 = 0.60, que tiene mayor probabilidad.
Naive Bayes utiliza un método equivalente para predecir la probabilidad de diferentes clases en función de varios atributos. Este algoritmo se utiliza principalmente en la clasificación de texto y con problemas que disponen múltiples clases.
¿Cuáles son los pros y los contras de Naive Bayes?
Vorteile:
- Es fácil y rápido predecir la clase de conjunto de datos de prueba. Es funktioniert auch gut bei der Vorhersage von Mehrklassenproblemen.
- Wenn die Unabhängigkeitsannahme erfüllt ist, funktioniert ein Naive-Bayes-Klassifikator besser im Vergleich zu anderen Modellen wie der logistischen Regression und benötigt weniger Trainingsdaten.
- Es funktioniert gut bei kategorischen Eingabevariablen im Vergleich zu numerischen Variablen. Für die numerische Variable, wird eine Normalverteilung angenommen (Glockenkurve, was eine solide Annahme ist).
Nachteile:
- Wenn die kategoriale Variable eine Kategorie enthält (die im Testdatensatz vorkommt), die im Trainingsdatensatz nicht beobachtet wurde, dann weist das Modell eine Wahrscheinlichkeit zu 0 (Null) und kann keine Vorhersage treffen. Dies ist oft bekannt als „Nullfrequenz“. Um dies zu beheben, Wir können die Glättungstechnik verwenden. Eine der einfachsten Glättungstechniken wird Laplace-Schätzung genannt.
- Außerdem, Naiver Bayes wird außerdem als eine schlechte Annäherung bezeichnet schätzerDas "Schätzer" ist ein statistisches Instrument, mit dem aus einer Stichprobe Merkmale einer Grundgesamtheit abgeleitet werden können. Es stützt sich auf mathematische Methoden, um genaue und zuverlässige Schätzungen zu liefern. Es gibt verschiedene Arten von Schätzern, wie die Unvoreingenommenheit und die konsequente, die je nach Kontext und Ziel der Studie ausgewählt werden. Seine korrekte Anwendung ist für die wissenschaftliche Forschung unerlässlich, Umfragen und Datenanalysen...., weshalb die Wahrscheinlichkeitsausgaben von predict_proba nicht zu ernst genommen werden sollten.
- Eine weitere Einschränkung von Bayes ingenuo ist die Annahme unabhängiger Prädiktoren. Im echten Leben, es ist nahezu unmöglich, ein Set von Prädiktoren zu erhalten, das völlig unabhängig ist.
4 Anwendungen von naiven Bayes-Algorithmen
- Echtzeitvorhersage: Naive Bayes ist ein gieriger und stabiler Klassifikator, der schnell ist. Deswegen, könnte verwendet werden, um Vorhersagen in Echtzeit zu treffen.
- Mehrklassen-Vorhersage: Dieser Algorithmus ist zudem bekannt für seine Funktion zur Vorhersage mehrerer Klassen. Hier können wir die Wahrscheinlichkeit mehrerer Zielklassen vorhersagen.
- Textklassifizierung / Spam-Filterung / Meinungsanalyse: Die Naive-Bayes-Klassifikatoren, die hauptsächlich in der Textklassifikation verwendet werden (aufgrund besserer Ergebnisse bei Problemen mit mehreren Klassen und der Unabhängigkeitsregel) haben sie eine höhere Erfolgsquote im Vergleich zu anderen Algorithmen. Während, werden weit verbreitet in der Filterung unerwünschter E-Mails verwendet (identifizieren unerwünschte E-Mails) und die Sentiment-Analyse (bei der Analyse von sozialen Netzwerken, um positive und negative Kundenstimmungen zu identifizieren).
- Empfehlungssystem: Naive-Bayes-Klassifikator und Kollaboratives Filtern zusammen ein Empfehlungssystem aufbauen, das Techniken des maschinellen Lernens und Data Mining verwendet, um unsichtbare Informationen zu filtern und vorherzusagen, ob ein Benutzer eine bestimmte Ressource wünscht oder nicht
Wie man ein einfaches Modell mit Naive Bayes in Python und R erstellt?
Nochmal, scikit lernen (Python-Bibliothek) Hier wird es helfen, ein Naive-Bayes-Modell in Python zu erstellen. Es gibt drei Arten von Naive-Bayes-Modellen in der Bibliothek scikit-learn:
-
Gaussian: Es wird in der Klassifikation verwendet und geht davon aus, dass die Merkmale einer Normalverteilung folgen.
-
Multinomial: Es wird für diskrete Zählungen verwendet. Als Beispiel, Angenommen, wir haben ein Textklassifikationsproblem. Hier können wir Bernoulli-Versuche in Betracht ziehen, das ist ein weiterer Schritt und anstelle von „Wort, das im Dokument erscheint“, haben „zählen, wie oft das Wort im Dokument erscheint“, man kann es sich vorstellen wie „Anzahl der Male, dass das Ergebnis Nummer x_i während der n Versuche beobachtet wird.
-
Bernoulli: Das binomiale Modell ist nützlich, wenn Ihre Merkmalsvektoren binär sind (Mit anderen Worten, Nullen und Einsen). Eine Anwendung wäre die Textklassifikation mit dem Modell von ‚Sack voller Worte‘ wo die 1 Ja 0 Sohn „das Wort im Dokument erscheint“ Ja „das Wort im Dokument nicht erscheint“, beziehungsweise.
Python-Code:
Probieren Sie den folgenden Code im Codierungsfenster aus und überprüfen Sie Ihre Ergebnisse unterwegs!
R-Code:
benötigen(e1071) #Holds the Naive Bayes Classifier
Train <- lesen.csv(Datei.wählen())
Prüfen <- lesen.csv(Datei.wählen())

#Make sure the target variable is of a two-class classification problem only

levels(Train$Item_Fat_Content)

Modell <- naiveBayes(Item_Fat_Content~., data = Train)
Klasse(Modell)
pred <- Vorhersagen(Modell,Prüfen)
Tisch(pred)
Vorher, analyse des grundlegenden Naive-Bayes-Modells, puede mejorar la potencia de este modelo básico ajustando los ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... y manejando las suposiciones de manera inteligente. Veamos los métodos para impulsar el rendimiento del modelo Naive Bayes. Te sugiero que pases por este documento para obtener más detalles sobre la clasificación de texto usando Naive Bayes.
Tipps zur Steigerung der Leistungsfähigkeit des Naive-Bayes-Modells
Dann, se ofrecen algunos consejos para impulsar la potencia de Bayes ingenuo Modell:
- Si las entidades continuas no disponen distribución normal, deberíamos utilizar transformación o diferentes métodos para convertirlas en distribución normal.
- Si el conjunto de datos de prueba tiene un obstáculo de frecuencia cero, aplique técnicas de suavizado “Corrección de Laplace” para predecir la clase de conjunto de datos de prueba.
- Elimine las características correlacionadas, puesto que las características altamente correlacionadas se votan dos veces en el modelo y pueden dar lugar a una relevancia exagerada.
- Los clasificadores Naive Bayes disponen opciones limitadas para el ajuste de parámetros como alpha = 1 para suavizar, fit_prior =[Wahr|Falsch] para aprender las probabilidades previas de la clase o no y algunas otras opciones (ver detalles hier). Recomendaría centrarse en el procesamiento previo de datos y la selección de funciones.
- Podrías pensar en aplicar algunos técnica de combinación de clasificador como einstellen, ensacado y refuerzo, pero estos métodos no ayudarían. In Wirklichkeit, „ensamblar, impulsar, embolsar“ wird nicht helfen, puesto que su objetivo es reducir la variación. Naive Bayes no tiene ninguna variación que minimizar.
Abschließende Anmerkungen
In diesem Beitrag, Analizamos uno de los algoritmos de aprendizaje automático supervisados “Naive Bayes“ que se utiliza principalmente para la clasificación. Glückwunsch, si ha entendido bien este post, ya ha dado el primer paso para dominar este algoritmo. Von jetzt an, todo lo que necesitas es practicar.
Zur selben Zeit, le sugiero que se centre más en el preprocesamiento de datos y la selección de características antes de aplicar el algoritmo Naive Bayes.0 En una publicación futura, hablaré sobre la clasificación de textos y documentos usando bayes ingenuos con más detalle.
Hat dir dieser Beitrag geholfen? Teile deine Meinung / Gedanken im Kommentarbereich unten.
Puede usar el siguiente recurso sin costes para aprender- Naive Bayes-





