
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Esto ha estado trabajando convencionalmente con el plan comercial y las tendencias de noticias. Con la llegada de la ciencia de datos y el aprendizaje automático, se han diseñado varios enfoques de investigación para automatizar este proceso manual. Este proceso de negociación automatizado ayudará a dar sugerencias en el momento adecuado con mejores cálculos. Una estrategia de negociación automatizada que ofrezca el máximo beneficio es muy deseable para los fondos mutuos y los fondos de cobertura. El tipo de rendimiento rentable que se espera conllevará cierto riesgo potencial. Diseñar una estrategia comercial automatizada rentable es una tarea compleja.
Todo ser humano quiere ganar su máximo potencial en el mercado de valores. Es muy importante diseñar una estrategia equilibrada y de bajo riesgo que pueda beneficiar a la mayoría de las personas. Uno de estos enfoques habla sobre el uso de agentes de VerstärkungslernenReinforcement Learning ist eine Technik der künstlichen Intelligenz, die es einem Agenten ermöglicht, durch Interaktion mit einer Umgebung zu lernen, Entscheidungen zu treffen. Durch Feedback in Form von Belohnungen oder Bestrafungen, Der Agent optimiert sein Verhalten, um die kumulierten Belohnungen zu maximieren. Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, Von Videospielen über Robotik bis hin zu Empfehlungssystemen, Er zeichnet sich durch seine Fähigkeit aus, komplexe Strategien zu erlernen.... para proporcionarnos estrategias comercialas automatizadas basadas en datos históricos.
Verstärktes Lernen
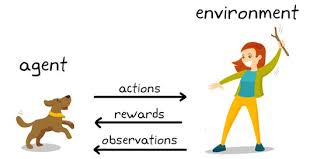
El aprendizaje por refuerzo es un tipo de aprendizaje automático en el que hay entornos y agentes. Estos agentes toman acciones para maximizar las recompensas. El aprendizaje por refuerzo tiene un potencial enorme cuando se utiliza para simulaciones para entrenar un modelo de IA. No hay una etiqueta asociada con ningún dato, el aprendizaje por refuerzo puede aprender mejor con muy pocos puntos de datos. Todas las decisiones, in diesem Fall, se toman de forma secuencial. El mejor ejemplo se encontraría en Robótica y Juegos.
Q – Aprendizaje
Q-learning es un algoritmo de aprendizaje por refuerzo sin modelos. Informa al agente qué acción emprender según las circunstancias. Es un método basado en valores que se utiliza para proporcionar información a un agente para la acción inminente. Se considera un algoritmo fuera de la política, ya que la función q-learning aprende de acciones que están fuera de la política actual, como tomar acciones aleatorias y, Daher, no se necesita una política.
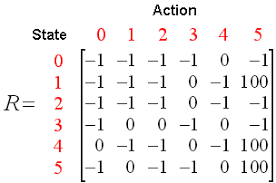
Q aquí significa Calidad. La calidad se refiere a la calidad de la acción en cuanto a qué tan beneficiosa será esa recompensa de acuerdo con la acción tomada. Se crea una Q-table con dimensiones [Zustand,Aktion]Un agente interactúa con el medio ambiente en cualquiera de las dos formas: explotar y explorar. Una opción de explotación sugiere que se consideren todas las acciones y se tome la que le dé el máximo valor al medio ambiente. Una opción de exploración es aquella en la que se considera una acción aleatoria sin considerar la recompensa máxima futura.
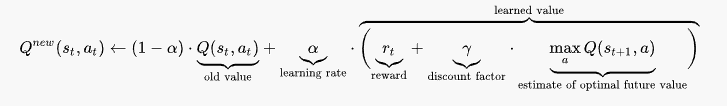
Q de st y at está representado por una fórmula que calcula la recompensa futura descontada máxima cuando se realiza una acción en un estado s.
La función definida nos proporcionará la recompensa máxima al final del número n de ciclos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... o iteraciones.
Der Handel kann die folgenden Aktionen haben: kaufen, verkaufen oder behalten
Q-Learning bewertet jede einzelne Aktion und es wird diejenige ausgewählt, die den höchsten Wert hat. Q-Learning basiert darauf, die Werte der Q-Tabelle zu lernen. Es funktioniert gut ohne Belohnungsfunktionen und Zustandsübergangswahrscheinlichkeiten.
Verstärkendes Lernen im Aktienhandel
Verstärkendes Lernen kann verschiedene Arten von Problemen lösen. Handel ist eine kontinuierliche Aufgabe ohne definierten Endpunkt. Handeln ist auch ein teilweise beobachtbarer Markow-Entscheidungsprozess, da wir keine vollständigen Informationen über die Händler auf dem Markt haben. Da wir die Belohnungsfunktion und die Übergangswahrscheinlichkeit nicht kennen, wir verwenden modellfreies Reinforcement Learning, was Q-Learning ist.
Schritte zur Ausführung eines RL-Agenten:
-
Bibliotheken installieren
-
Holen Sie sich die Daten
-
Definieren Sie den Q-Learning-Agenten
-
Den Agenten ausbilden
-
Testen Sie den Agenten
-
Signale darstellen
Bibliotheken installieren
Installieren und importieren Sie die erforderlichen Finanzbibliotheken von NumPy, Pandas, matplotlib, seaborn und yahoo.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
!pip install yfinance --upgrade --no-cache-dir
from pandas_datareader import data as pdr
import fix_yahoo_finance as yf
from collections import deque
import random
Import tensorflow.compat.v1 as tf
tf.compat.v1.disable_eager_execution()
Holen Sie sich die Daten
Verwenden Sie die Yahoo Finance-Bibliothek, um die Daten einer bestimmten Aktie zu erhalten. Die hier für unsere Analyse verwendeten Aktien sind die Aktien von Infosys.
yf.pdr_override()
df_full = pdr.get_data_yahoo("INFY", start="2018-01-01").reset_index()
df_full.to_csv(‘INFY.csv',index=Falsch)
df_full.head()
Dieser Code erstellt einen DataFrame namens df_full, der die Aktienkurse von INFY im Verlauf enthält 2 Jahre.
Definieren Sie den Q-Learning-Agenten
Die erste Funktion ist die Agentenklasse, die die Größe des Zustands definiert, Fenstergröße, Losgröße, deque, das als verwendeter Speicher dient, Inventar als Liste. Es werden auch einige statische Variablen wie Epsilon definiert, Abnahme, Gamma, etc. Es werden zwei Schichten definiert rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. für Kauf, Halten und Verkauf von Optionen. GradientDescentOptimizer wird auch verwendet.
Der Agent hat definierte Funktionen für Kauf- und Verkaufsoptionen. Die Funktion get_state und act verwendet das neuronale Netzwerk, um den nächsten Zustand des neuronalen Netzes zu erzeugen. Die Belohnungen werden anschließend berechnet, indem der Wert, der bei der Ausführung der Call-Option erzeugt wurde, addiert oder subtrahiert wird. Die im nächsten Zustand getroffene Handlung wird von der im vorherigen Zustand getroffenen Handlung beeinflusst. 1 bezieht sich auf einen Kaufaufruf, während 2 bezieht sich auf einen Verkaufsaufruf. In jeder Iteration, Der Zustand wird auf Grundlage bestimmt, auf deren Basis eine Handlung getroffen wird, die einige Aktien kaufen oder verkaufen wird. Die allgemeinen Belohnungen werden in der gespeichert VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... vom Gesamtgewinn.
df = df_full.copy()
name="Q-Learning-Agent"
Klasse Agent:
    def __init__(selbst, state_size, window_size, Trend, überspringen, batch_size):
        self.state_size = state_size
        self.window_size = window_size
        self.half_window = window_size // 2
        self.trend = trend
        self.skip = skip
        self.action_size = 3
        self.batch_size = batch_size
        self.memory = deque(maxlen = 1000)
        self.inventory = []
        self.gamma = 0.95
        self.epsilon = 0.5
        self.epsilon_min = 0.01
        self.epsilon_decay = 0.999
        tf.reset_default_graph()
        self.sess = tf. InteractiveSession()
        selbst. X = tf.platzhalter(tf.float32, [Keiner, self.state_size])
        selbst. Y = tf.placeholder(tf.float32, [Keiner, self.action_size])
        feed = tf.layers.dense(self. X, 256, Aktiverung = tf.nn.relu)
        self.logits = tf.layers.dense(feed, self.action_size)
        self.cost = tf.reduce_mean(tf.square(self. Y - self.logits))
        self.optimizer = tf.train.GradientDescentOptimizer(1e-5).minimize(
            self.cost
        )
        self.sess.run(tf.global_variables_initializer())
    def act(selbst, Zustand):
        if random.random() <= self.epsilon:
            return random.randrange(self.action_size)
        np.argmax zurückgeben(
            self.sess.run(self.logits, feed_dict = {self. X: Zustand})[0]
        )
    def get_state(selbst, T):
        window_size = self.window_size + 1
        d = t - window_size + 1
        block = self.trend[D : T + 1] wenn d >= 0 else -d * [self.trend[0]] + self.trend[0 : T + 1]
        res = []
        für mich in Reichweite(window_size - 1):
            res.append(Block[ich + 1] - Block[ich])
        np.array zurückgeben([res])
    def replay(selbst, batch_size):
        mini_batch = []
        l = len(self.memory)
        für mich in Reichweite(l - batch_size, l):
            mini_batch.append(self.memory[ich])
        replay_size = len(mini_batch)
        X = np.empty((replay_size, self.state_size))
        Y = np.empty((replay_size, self.action_size))
        states = np.array([ein[0][0] für a in mini_batch])
        new_states = np.array([ein[3][0] für a in mini_batch])
        Q = self.sess.run(self.logits, feed_dict = {self. X: Zustände})
        Q_new = selbst.sess.run(self.logits, feed_dict = {self. X: new_states})
        für mich in Reichweite(len(mini_batch)):
            Zustand, Aktion, Belohnung, next_state, fertig = mini_batch[ich]
            Ziel = Q[ich]
            Ziel[Aktion] = reward
            if not done:
                Ziel[Aktion] += selbst.gamma * np.amax(Q_new[ich])
            x[ich] = state
            Y[ich] = target
        cost, _ = self.sess.run(
            [self.cost, self.optimizer], feed_dict = {self. X: x, self. Y: Ja}
        )
        if self.epsilon > self.epsilon_min:
            self.epsilon *= self.epsilon_decay
        return cost
    def buy(selbst, anfängliches_Geld):
        starting_money = initial_money
        states_sell = []
        Zustände_kaufen = []
        Inventar = []
        Zustand = self.get_state(0)
        für T im Bereich(0, len(self.trend) - 1, self.überspringen):
            Aktion = self.act(Zustand)
            nächster_Zustand = self.get_state(T + 1)
            wenn Aktion == 1 und anfängliches_Geld >= self.Trend
                Inventar.append(self.Trend
                anfängliches_Geld -= self.Trend
                Zustände_kaufen.append
                drucken('Tag %d: kaufen 1 Einheit zum Preis %f, Gesamtsaldo %f'% (T, self.Trend
            elif Aktion == 2 und len(Inventar):
                gekaufter_Preis = Inventar.pop(0)
                initial_money += self.trend
 states_sell.append
 try:
                    invest = ((close
 except:
                    invest = 0
                drucken(
                    'Tag %d, sell 1 Einheit zum Preis %f, investment %f %%, Gesamtsaldo %f,'
                    % (T, schließen
                )
            state = next_state
        invest = ((anfängliches_Geld - starting_money) / starting_money) * 100
        total_gains = initial_money - starting_money
        return states_buy, states_sell, total_gains, invest
    def train(selbst, Iterationen, Kontrollpunkt, anfängliches_Geld):
        für mich in Reichweite(Iterationen):
            total_profit = 0
            Inventar = []
            Zustand = self.get_state(0)
            starting_money = initial_money
            for t in range(0, len(self.trend) - 1, self.überspringen):
                Aktion = self.act(Zustand)
                nächster_Zustand = self.get_state(T + 1)
                wenn Aktion == 1 und starting_money >= selbst.trend
 Inventar.append(self.trend
 starting_money -= self.trend
 elif action == 2 und len(Inventar) > 0:
                    gekaufter_Preis = Inventar.pop(0)
                    total_profit += self.trend
 starting_money += self.trend
 invest = ((starting_money - anfängliches_Geld) / anfängliches_Geld)
                self.memory.append((Zustand, Aktion, invest,
                                    next_state, starting_money < anfängliches_Geld))
                state = next_state
                batch_size = min(self.batch_size, len(self.memory))
                cost = self.replay(batch_size)
            Wenn (ich+1) % checkpoint == 0:
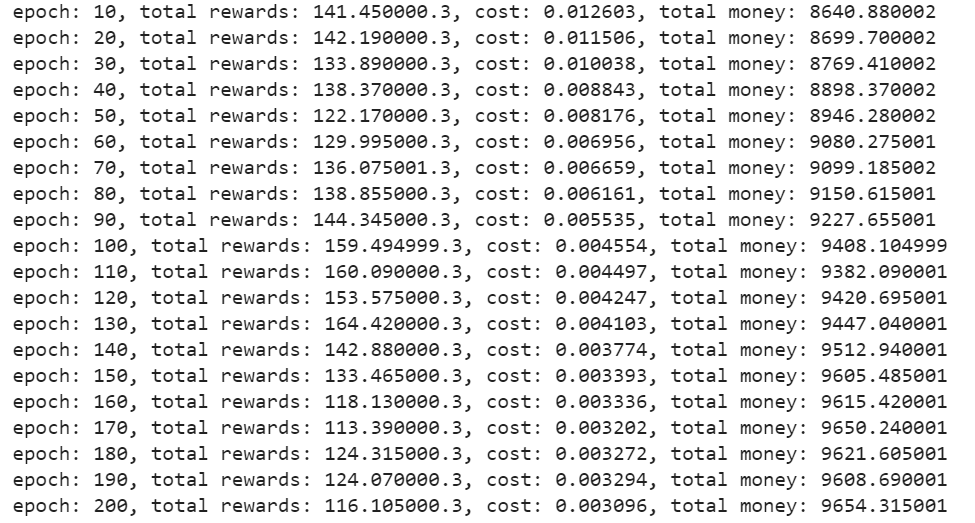
                drucken('epoch: %D, total rewards: %f.3, Kosten: %F, total money: %f'%(ich + 1, total_profit, Kosten,
                                                                                  starting_money))
Den Agenten ausbilden
Una vez definido el agente, inicialícelo. Especifique el número de iteraciones, dinero inicial, etc. para capacitar al agente para que decida las opciones de compra o venta.
Nahe = DF. Close.values.tolist()
initial_money = 10000
window_size = 30
skip = 1
batch_size = 32
Agent = Agent(state_size = window_size,
              window_size = window_size,
              trend = close,
              skip = skip,
              batch_size = batch_size)
agent.train(Iterationen = 200, checkpoint = 10, initial_money = initial_money)
Produktion –
Testen Sie den Agenten
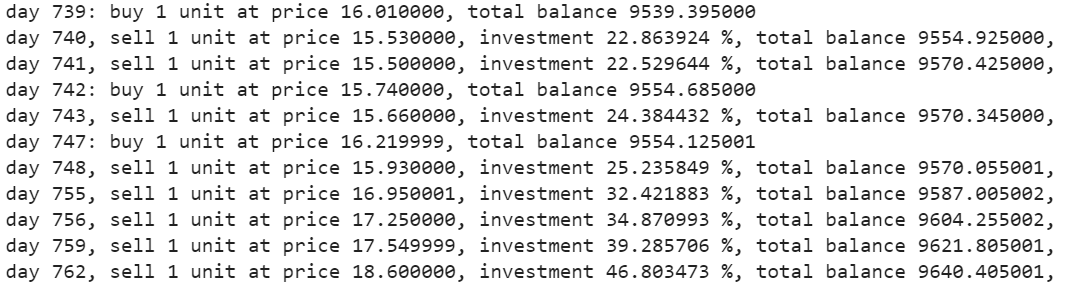
La función de compra devolverá las cifras de compra, Verkauf, beneficio e inversión.
states_buy, states_sell, total_gains, investieren = agent.buy(initial_money = initial_money)
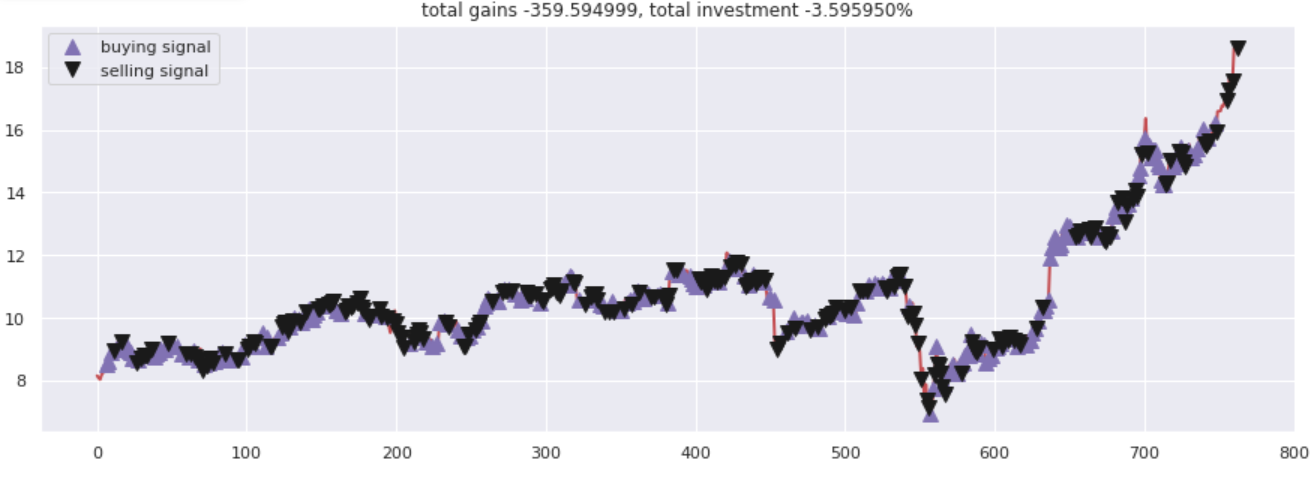
Trazar las llamadas
Grafique las ganancias totales frente a las cifras invertidas. Todas las llamadas de compra y venta se han marcado adecuadamente de acuerdo con las opciones de compra / venta sugeridas por la red neuronal.
fig = plt.figur(Feigengröße = (15,5))
plt.plot(schließen, Farbe="R", lw=2.)
plt.plot(schließen, '^', markersize=10, Farbe="m", Etikett="Buying Signal", Markevery = states_buy)
plt.plot(schließen, 'v', markersize=10, Farbe="k", Etikett="Selling Signal", Markevery = states_sell)
plt.titel('Total Gains %f, Total Investment %f%%'%(total_gains, invest))
plt.legende()
plt.savefig(name+'.png')
plt.zeigen()
Produktion –
Abschließende Anmerkungen
Q-Learning es una técnica que le ayuda a desarrollar una estrategia comercial automatizada. Se puede utilizar para experimentar con las opciones de compra o venta. Hay muchos más agentes comerciales de aprendizaje por refuerzo con los que se puede experimentar. Intente jugar con los diferentes tipos de agentes de RL con diferentes acciones.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





