
Die Herausforderung, Maschinen Text verstehen zu lassen
„Sprache ist ein wunderbares Kommunikationsmittel“
Sie und ich hätten diesen Satz im Bruchteil einer Sekunde verstanden. Aber Maschinen können einfach keine Textdaten in Rohform verarbeiten. Wir müssen den Text in ein numerisches Format zerlegen, das die Maschine leicht lesen kann (die idee dahinter Verarbeitung natürlicher Sprache!).
Hier kommen Bag-of-Words-Konzepte ins Spiel. (Sich beugen) y TF-IDF. Sowohl BoW als auch TF-IDF sind Techniken, die uns helfen, Textsätze in numerische Vektoren umzuwandeln.
Ich werde in diesem Artikel über Bag-of-Words und TF-IDF sprechen. Wir werden ein intuitives und allgemeines Beispiel verwenden, um jedes Konzept im Detail zu verstehen.
Neu in der Verarbeitung natürlicher Sprache (NLP)? Wir haben die perfekten Kurse für den Einstieg:
Nehmen wir ein Beispiel, um den Sack voller Worte zu verstehen (Sich beugen) y TF-IDF
Ich nehme ein beliebtes Beispiel, um Bag-of-Words zu erklären (Sich beugen) und TF-DF in diesem Artikel.
Wir alle schauen gerne Filme (in unterschiedlichen Graden). Normalerweise schaue ich mir immer die Kritiken zu einem Film an, bevor ich mich dazu verpflichte, ihn zu sehen.. Ich weiß, dass viele von euch das gleiche tun! Dann, Ich werde dieses Beispiel hier verwenden.
Hier ist ein Beispiel von Rezensionen zu einem bestimmten Horrorfilm:
- Revision 1: Dieser Film ist sehr gruselig und lang
- Revision 2: Dieser Film ist nicht gruselig und er ist langsam
- Revision 3: dieser film ist gruselig und gut
Sie können sehen, dass es einige gegensätzliche Kritiken über den Film gibt, sowie die Länge und der Rhythmus des Films. Stellen Sie sich vor, Sie sehen sich Tausende von Bewertungen wie diese an. Deutlich, Es gibt viele interessante Einsichten, die wir daraus ziehen und entwickeln können, um zu beurteilen, wie gut der Film abgeschnitten hat.
Aber trotzdem, wie wir schon gesehen haben, Wir können diese Sätze nicht einfach einem Modell für maschinelles Lernen übergeben und es bitten, uns mitzuteilen, ob eine Bewertung positiv oder negativ war. Wir müssen bestimmte Schritte zur Textvorverarbeitung durchführen.
Bag-of-Words und TF-IDF sind zwei Beispiele dafür. Lass uns im Detail verstehen.
Vektoren aus Text erstellen
Können Sie sich einige Techniken vorstellen, mit denen wir einen Satz am Anfang vektorisieren könnten?? Die Grundvoraussetzungen wären:
- Es sollte nicht zu einer dünnbesetzten Matrix führen, da dünnbesetzte Matrizen zu hohen Rechenkosten führen
- Wir sollten in der Lage sein, die meisten der im Satz enthaltenen sprachlichen Informationen zu behalten.
Das Einbetten von Wörtern ist eine dieser Techniken, bei denen wir Text mithilfe von Vektoren darstellen können. Die beliebtesten Formen von Worteinlagen sind:
- Sich beugen, was bedeutet wortschatz
- TF-IDF, Was bedeutet der Begriff Frequency-Reverse Document Frequency?
Jetzt, Sehen wir uns an, wie wir frühere Filmkritiken als Inlays rendern und für ein maschinelles Lernmodell vorbereiten können.
Wortbeutelmodell (Sich beugen)
El modelo Beutel voller Worte (Sich beugen) ist die einfachste Art, Text in Zahlen darzustellen. Wie der Begriff selbst, wir können einen Satz als eine Tüte mit Wörtern darstellen Vektor (eine Reihe von Zahlen).
Erinnern Sie sich an die drei Arten von Filmkritiken, die wir zuvor gesehen haben:
- Revision 1: Dieser Film ist sehr gruselig und lang
- Revision 2: Dieser Film ist nicht gruselig und er ist langsam
- Revision 3: dieser film ist gruselig und gut
Wir werden zuerst ein Vokabular aus allen einzigartigen Wörtern in den vorherigen drei Überarbeitungen aufbauen. Der Wortschatz besteht aus diesen 11 Wörter: ‚Dies‘, ‚Film‘, ‚es ist‘, ‚sehr‘, ‚erschreckend‘, ‚Ja‘, ‚lang‘, ‚Nein‘, ‚langsam‘, ‚gruselig‘, ‚gut ‚.
Jetzt können wir jedes dieser Wörter nehmen und ihr Erscheinen in den drei vorherigen Filmkritiken mit markieren 1 Ja 0. Das wird uns geben 3 Vektoren für 3 Bewertungen:
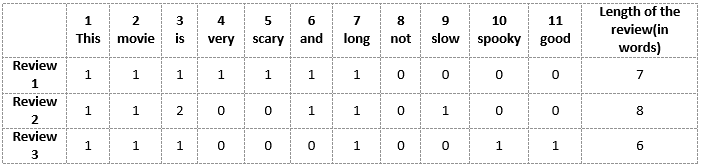
Bewertungsvektor 1: [1 1 1 1 1 1 1 0 0 0 0]
Bewertungsvektor 2: [1 1 2 0 0 1 1 0 1 0 0]
Bewertungsvektor 3: [1 1 1 0 0 0 1 0 0 1 1]
Und das ist die zentrale Idee des Bag of Words-Modells. (Sich beugen).
Nachteile der Verwendung eines Tüte-von-Wort-Modells (Sich beugen)
Im obigen Beispiel, wir können Vektoren der Länge haben 11. Aber trotzdem, Wir fangen an, uns Problemen zu stellen, wenn wir neue Gebete finden:
- Wenn die neuen Sätze neue Wörter enthalten, dann würde unser Wortschatz zunehmen und, Daher, die Länge der Vektoren würde auch zunehmen.
- Was ist mehr, die Vektoren würden auch viele Nullen enthalten, was zu einer dünnbesetzten Matrix führen würde (was wir vermeiden möchten)
- Wir speichern keine Informationen über die Grammatik von Sätzen oder die Reihenfolge der Wörter im Text.
Begriff Häufigkeit-Inverse Häufigkeit von Dokumenten (TF-IDF)
Lassen Sie uns zuerst eine formale Definition um TF-IDF legen. So formuliert es Wikipedia:
„Die Häufigkeit der Begriffe, die umgekehrte Häufigkeit von Dokumenten, ist eine numerische Statistik, die versucht, die Bedeutung eines Wortes für ein Dokument in einer Sammlung oder einem Korpus widerzuspiegeln“.
Begriffshäufigkeit (TF)
Lassen Sie uns zuerst Frequent Term verstehen (TF). Es ist ein Maß dafür, wie oft ein Begriff vorkommt, T, in einem Dokument, D:

Hier, im Zähler, n ist die Häufigkeit, mit der der Begriff vorkommt „T“ im Dokument „D“. Deswegen, jedes Dokument und jeder Begriff hätte seinen eigenen TF-Wert.
Wieder verwenden wir dasselbe Vokabular, das wir im Bag-of-Words-Modell erstellt haben, um zu zeigen, wie die TF für den Review berechnet wird # 2:
Revision 2: Dieser Film ist nicht gruselig und er ist langsam
Hier,
- Wortschatz: ‚Dies‘, ‚Film‘, ‚es ist‘, ‚sehr‘, ‚erschreckend‘, ‚Ja‘, ‚lang‘, ‚Nein‘, ‚langsam‘, ‚gruselig‘, ‚gut‘
- Anzahl der Wörter in der Rezension 2 = 8
- TF für das Wort ‚Das‘ = (Anzahl der Vorkommen ‚Das‘ im Rückblick 2) / (Anzahl der Begriffe in der Rezension 2) = 1/8
Ähnlich,
- TF (‚Film‘) = 1/8
- TF (‚es ist‘) = 2/8 = 1/4
- TF (‚sehr‘) = 0/8 = 0
- TF (‚erschreckend‘) = 1/8
- TF (‚Ja‘) = 1/8
- TF (‚lang‘) = 0/8 = 0
- TF (‚Nein‘) = 1/8
- TF (‚langsam‘) = 1/8
- TF (‚gruselig‘) = 0/8 = 0
- TF (‚gut‘) = 0/8 = 0
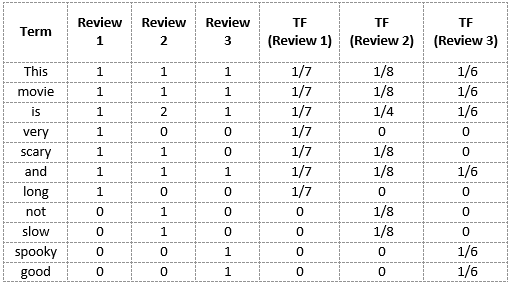
Auf diese Weise können wir die Termhäufigkeiten für alle Terme und alle Revisionen berechnen:
Beleghäufigkeit umkehren (IDF)
IDF ist ein Maß für die Bedeutung eines Begriffs. Wir brauchen den IDF-Wert, weil die Berechnung des TF allein nicht ausreicht, um die Bedeutung der Wörter zu verstehen:
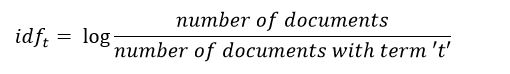
Wir können die IDF-Werte für alle Wörter im Review berechnen 2:
IDF (‚Das‘) = log (Anzahl der Dokumente / Anzahl der Dokumente, die das Wort enthalten ‚Das‘) = log (3/3) = log (1) = 0
Ähnlich,
- IDF (‚Film‘,) = log (3/3) = 0
- IDF (‚es ist‘) = log (3/3) = 0
- IDF (‚Nein‘) = log (3/1) = log (3) = 0.48
- IDF (‚erschreckend‘) = log (3/2) = 0.18
- IDF (‚Ja‘) = log (3/3) = 0
- IDF (‚langsam‘) = log (3/1) = 0.48
Auf diese Weise können wir die IDF-Werte für jedes Wort berechnen. Deswegen, die IDF-Werte für das gesamte Vokabular wären:
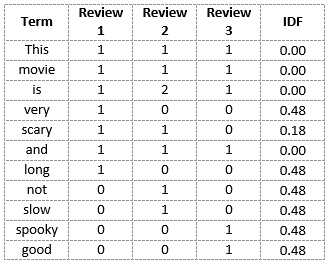
Deswegen, Wir sehen, dass Wörter wie "es", "Dies", "und", etc., sie werden reduziert auf 0 und sie haben wenig Bedeutung; während Wörter wie "beängstigend", "lang", "Gut", etc. sie sind Wörter mit größerer Bedeutung und haben daher einen höheren Wert.
Jetzt können wir den TF-IDF-Score für jedes Wort im Korpus berechnen. Wörter mit einer höheren Punktzahl sind wichtiger und Wörter mit einer niedrigeren Punktzahl sind weniger wichtig:
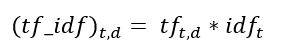
Jetzt können wir den TF-IDF-Score für jedes Wort im Review berechnen 2:
TF-IDF (‚Das‘, Revision 2) = TF (‚Das‘, Revision 2) * IDF (‚Das‘) = 1/8 * 0 = 0
Ähnlich,
- TF-IDF (‚Film‘, Revision 2) = 1/8 * 0 = 0
- TF-IDF (‚es ist‘, Revision 2) = 1/4 * 0 = 0
- TF-IDF (‚Nein‘, Revision 2) = 1/8 * 0.48 = 0.06
- TF-IDF (‚erschreckend‘, Revision 2) = 1/8 * 0.18 = 0.023
- TF-IDF (‚Ja‘, Revision 2) = 1/8 * 0 = 0
- TF-IDF (‚langsam‘, Revision 2) = 1/8 * 0.48 = 0.06
Auf die gleiche Weise, wir können TF-IDF-Scores für alle Wörter gegen alle Bewertungen berechnen:
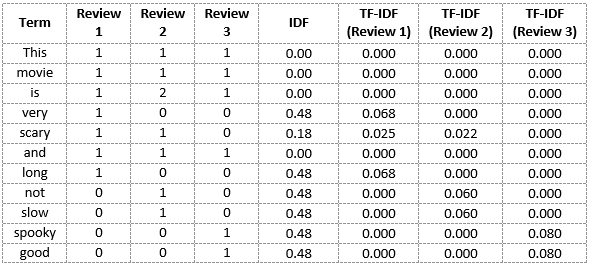
Wir haben jetzt die TF-IDF-Ergebnisse für unseren Wortschatz erhalten. TF-IDF liefert auch größere Werte für weniger häufige Wörter und ist hoch, wenn IDF- und TF-Werte hoch sind, nämlich, das Wort ist in allen Dokumenten zusammen selten, aber in einem einzigen Dokument häufig.
Abschließende Anmerkungen
Lassen Sie mich zusammenfassen, was wir in dem Artikel behandelt haben:
- Bag of Words erstellt einfach eine Reihe von Vektoren, die die Anzahl der Vorkommen von Wörtern im Dokument enthalten (Bewertungen), während das TF-IDF-Modell auch Informationen zu den wichtigsten und unwichtigsten Wörtern enthält.
- Bag of Words-Vektoren sind einfach zu interpretieren. Aber trotzdem, TF-IDF funktioniert normalerweise am besten in Modellen für maschinelles Lernen.
Während sowohl Bag-of-Words als auch TF-IDF in ihrem eigenen Sinne beliebt waren, es gab immer noch eine Lücke im Verständnis des Kontextes der Wörter. Ähnlichkeit zwischen den Wörtern erkennen ‚gruselig‘ Ja ‚erschreckend‘, oder übersetzen Sie unsere gegebenen Dokumente in eine andere Sprache, erfordert viel mehr Informationen in den Dokumenten.
Hier kommen Worteinbettungstechniken wie Word2Vec ins Spiel., Kontinuierlicher Beutel voller Wörter (CBOW), Skipgramm, etc. Eine detaillierte Anleitung zu diesen Techniken finden Sie hier:





