
Einführung
Bildanalyse und Kartierung in Earth Engine mit NDVI ", jetzt ist wieder ein Artikel zum Thema Bildanalyse. Im Gegensatz zum vorherigen Artikel, dieser Artikel analysiert Allgemeines Bildanalyse, Nein Satellitenbild Analyse. Das Ziel dieser Diskussion besteht darin zu erkennen, ob zwei Produkte gleich sind oder nicht.. Jedes der beiden Produkte hat Bild- und Textnamen. Wenn das Produktpaar ähnliche oder gleiche Bilder oder Textnamen hat, das bedeutet, dass die beiden Produkte gleich sind. Die Daten stammen aus einem Wettbewerb in Kaggle.
Es gibt 4 Basispakete, die in diesem Skript verwendet werden: NumPy, Pandas, matplotlib und seaborn. Es gibt auch andere spezifische Pakete. „Bild“ Bilddaten laden und anzeigen. „Imagehash“ berechnet die Ähnlichkeit zweier Bilder. „Durcheinander“ erkennt die Ähnlichkeit zweier Texte. Das „Metriken“ Das Paket berechnet den Genauigkeitswert des wahren Etiketts und des vorhergesagten Etiketts.
# Pakete importieren
numpy als np importieren
Pandas als pd importieren
import matplotlib.pyplot als plt
Seegeboren als sns importieren
aus PIL-Import Bild
Imagehash importieren
von fuzzywuzzy importieren fuzz
aus sklearn.tree import DecisionTreeClassifier
von sklearn Importmetriken
Bildähnlichkeit
Die Ähnlichkeit der beiden Bilder wird vom Paket erkannt „Bildhash“. Wenn zwei Bilder identisch oder fast identisch sind, der Bild-Hash-Unterschied wird sein 0. Zwei Bilder sind ähnlicher, wenn der Bild-Hash-Unterschied näher bei . liegt 0.
Der Vergleich der Ähnlichkeit zweier Bilder mit Imagehash besteht aus 5 Schritte. (1) Bilder werden in Graustufen umgewandelt. (2) Bildgrößen werden verkleinert, zum Beispiel, ein 8 × 8 Pixel standardmäßig. (3) Der Mittelwert der 64 Pixel. (4) Es wird geprüft, ob die 64 Pixel sind größer als der Mittelwert. Jetzt, jedes von den 64 Pixel hat einen booleschen Wert von true oder false. (5) Der Unterschied zwischen Bildern ist die Anzahl der unterschiedlichen Werte zwischen den beiden Bildern. Schauen Sie sich die folgende Abbildung an.
Bild_1 (Durchschnitt: 71,96875)
|
48 |
20 |
34 |
40 |
40 |
32 |
30 |
32 |
|
34 |
210 |
38 |
50 |
42 |
41 |
230 |
40 |
|
47 |
230 |
33 |
44 |
34 |
50 |
245 |
50 |
|
43 |
230 |
46 |
50 |
36 |
34 |
250 |
30 |
|
30 |
200 |
190 |
38 |
41 |
240 |
39 |
39 |
|
38 |
7 |
200 |
210 |
220 |
240 |
50 |
48 |
|
48 |
8 |
45 |
43 |
47 |
37 |
37 |
47 |
|
10 |
8 |
6 |
5 |
6 |
6 |
5 |
5 |
|
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
|
FALSCH |
STIMMT |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
STIMMT |
FALSCH |
|
FALSCH |
STIMMT |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
STIMMT |
FALSCH |
|
FALSCH |
STIMMT |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
STIMMT |
FALSCH |
|
FALSCH |
STIMMT |
STIMMT |
FALSCH |
FALSCH |
STIMMT |
FALSCH |
FALSCH |
|
FALSCH |
FALSCH |
STIMMT |
STIMMT |
STIMMT |
STIMMT |
FALSCH |
FALSCH |
|
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
|
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
Bild_2 (Durchschnitt: 78,4375)
|
41 |
20 |
39 |
43 |
34 |
39 |
30 |
32 |
|
35 |
195 |
44 |
46 |
35 |
48 |
232 |
40 |
|
30 |
243 |
38 |
31 |
34 |
46 |
213 |
50 |
|
49 |
227 |
44 |
33 |
35 |
224 |
230 |
30 |
|
46 |
203 |
225 |
44 |
46 |
181 |
184 |
40 |
|
38 |
241 |
247 |
220 |
228 |
210 |
36 |
38 |
|
42 |
8 |
35 |
39 |
47 |
31 |
41 |
21 |
|
3 |
12 |
10 |
18 |
24 |
21 |
6 |
17 |
|
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
|
FALSCH |
STIMMT |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
STIMMT |
FALSCH |
|
FALSCH |
STIMMT |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
STIMMT |
FALSCH |
|
FALSCH |
STIMMT |
FALSCH |
FALSCH |
FALSCH |
STIMMT |
STIMMT |
FALSCH |
|
FALSCH |
STIMMT |
STIMMT |
FALSCH |
FALSCH |
STIMMT |
STIMMT |
FALSCH |
|
FALSCH |
STIMMT |
STIMMT |
STIMMT |
STIMMT |
STIMMT |
FALSCH |
FALSCH |
|
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
|
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
FALSCH |
Der Hash-Bild-Unterschied der beiden Bilder / über Matrizen ist 3. Es bedeutet, dass es 3 Pixel mit unterschiedlichen booleschen Werten. Die beiden Bilder sind relativ ähnlich.
Für mehr Klarheit, Lassen Sie uns den Bild-Hash untersuchen, der auf Folgendes angewendet wird: 3 Bildpaare. Das erste Paar besteht aus zwei gleichen Bildern und der Unterschied zwischen den Bildern ist 0. Das zweite Paar vergleicht zwei ähnliche Bilder. Das zweite Bild (image_b) es ist eigentlich eine bearbeitete Version des ersten Bildes (image_a). Der Unterschied zwischen Bildern ist 6. Das letzte Paar zeigt den Vergleich zweier völlig unterschiedlicher Bilder. Der Hash-Image-Unterschied ist 30, was ist am weitesten davon entfernt 0.
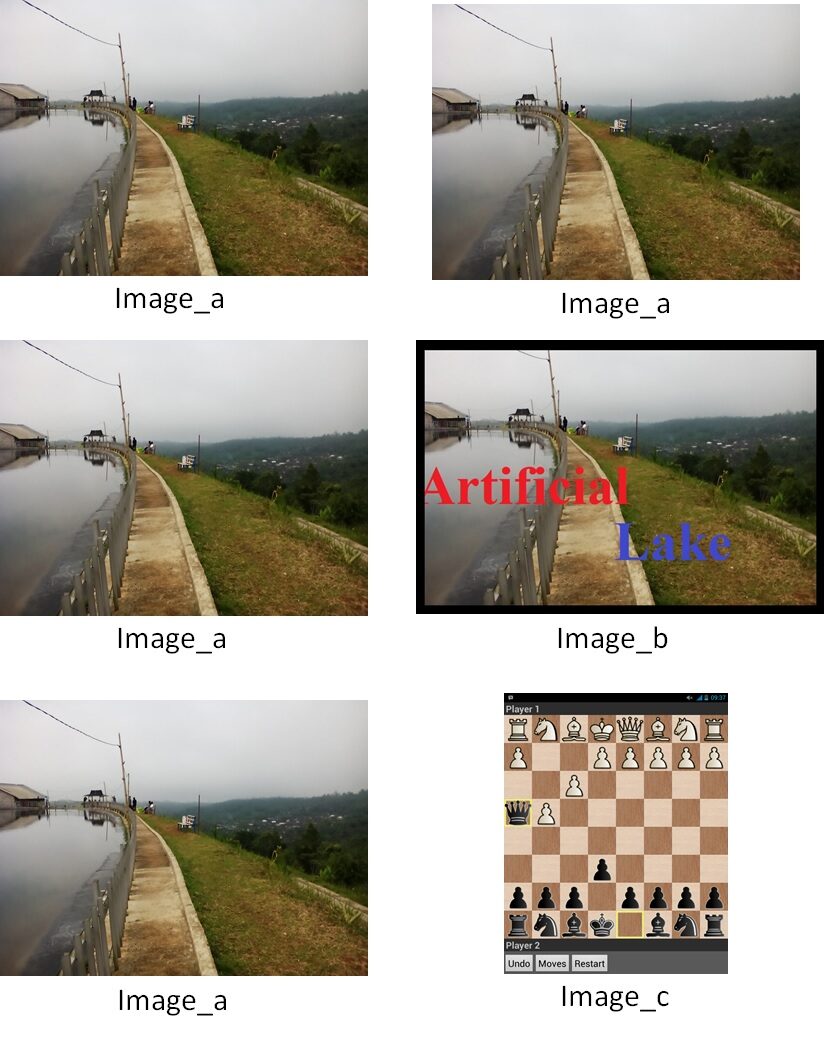
# Erstes Paar
hash1 = imagehash.average_hash(Bild.öffnen('D: /image_a.jpg'))
hash2 = imagehash.average_hash(Bild.öffnen('D:/ image_a.jpg'))
diff = hash1 - hash2
drucken(unterschied)
# 0
# Zweites Paar
hash1 = imagehash.average_hash(Bild.öffnen('D: /image_a.jpg'))
hash2 = imagehash.average_hash(Bild.öffnen('D:/ image_b.jpg'))
diff = hash1 - hash2
drucken(unterschied)
# 6
# Drittes Paar
hash1 = imagehash.average_hash(Bild.öffnen('D: /image_a.jpg'))
hash2 = imagehash.average_hash(Bild.öffnen('D:/ image_c.jpg'))
diff = hash1 - hash2
drucken(unterschied)
# 30
So sieht der durchschnittliche Bild-Hash aus
>imagehash.average_hash(Bild.öffnen('D:/image_a.jpg'))
Array([[ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [Falsch,  Wahr, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch],
       [ Wahr,  Wahr, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch],
       [Falsch, Falsch, Falsch,  Wahr, Falsch, Falsch, Falsch, Falsch],
       [Falsch, Falsch, Falsch,  Wahr, Falsch, Falsch, Falsch, Falsch],
       [Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch]])
>imagehash.average_hash(Bild.öffnen('D:/image_b.jpg'))
Array([[ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [Falsch,  Wahr,  Wahr,  Wahr,  Wahr, Falsch, Falsch, Falsch],
       [ Wahr,  Wahr,  Wahr, Falsch, Falsch, Falsch, Falsch, Falsch],
       [ Wahr,  Wahr, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch],
       [Falsch, Falsch, Falsch,  Wahr, Falsch, Falsch, Falsch, Falsch],
       [Falsch, Falsch, Falsch,  Wahr, Falsch, Falsch, Falsch, Falsch],
       [Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch]])
>imagehash.average_hash(Bild.öffnen('D:/image_c.png'))
Array([[Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [ Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr,  Wahr],
       [Falsch, Falsch, Falsch, Falsch,  Wahr, Falsch, Falsch, Falsch],
       [Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch, Falsch]])
Textähnlichkeit
Textähnlichkeit kann mithilfe natürlicher Sprachverarbeitung bewertet werden (PNL). Es gibt 4 Möglichkeiten, die Ähnlichkeit eines Textpaares zu vergleichen, das vom Paket bereitgestellt wird „Durcheinander“. Die Funktion in diesem Paket gibt einen ganzzahligen Wert von zurück 0 ein 100. Der höchste Wert bedeutet die höchste Ähnlichkeit.
1. Fuzz.-Verhältnis – ist der einfachste Vergleich von Texten. Der fuzz.ratio-Wert von „Blaues Shirt“ Ja „Blaues Shirt“. es ist 95. Es bedeutet, dass die beiden Texte ähnlich oder fast gleich sind, aber der Punkt macht sie ein bisschen anders
von fuzzywuzzy importieren fuzz
Fuzz.-Verhältnis('Blaues Hemd','Blaues Hemd.')
#95
Die Messung basiert auf der Levenshtein-Distanz (benannt nach Vladimir Levenshtein). Die Levenshtein-Distanz misst, wie ähnlich zwei Texte sind. Messen Sie die Mindestanzahl von Bearbeitungen, wie man einfügt, einen Text in einem anderen Text löschen oder ersetzen. Der Text „Blaues Shirt“ erfordert nur eine Bearbeitung, um zu sein „Blaues Shirt“. Sie brauchen nur einen einzigen Punkt, um gleich zu sein. Deswegen, die Levenshtein-Distanz ist „1“. Die Fuzz-Beziehung wird mit dieser Gleichung berechnet (len (ein) + len (B) – lev) / ((len (ein) + len (B), wo len (ein) und len (B) sind die Längen des ersten und zweiten Textes, und lev ist der Levenshtein-Abstand Die Beziehung ist (10 + 11 – 1) / (10 + 11) = 0,95 Ö 95%.
2. fuzz.partial_ratio: kann erkennen, ob ein Text Teil eines anderen Textes ist. Aber es kann nicht erkennen, ob der Text in einer anderen Reihenfolge ist. Das folgende Beispiel zeigt das „Blaues Shirt“ Es ist ein Teil von „sauberes blaues Hemd“, fuzz.partial_ratio ist also 100. fuzz.ratio gibt den Wert zurück 74 weil es nur erkennt, dass es große Unterschiede zwischen den beiden Texten gibt.
drucken(Fuzz.-Verhältnis('Blaues Hemd','Sauberes blaues Hemd.'))
#74
drucken(fuzz.partial_ratio('Blaues Hemd','Sauberes blaues Hemd.'))
#100
3. Token_Sort_Ratio: kann erkennen, ob ein Text Teil eines anderen Textes ist, auch wenn sie in einer anderen reihenfolge sind. Fuzz.token_sort_ratio devuelve 100 für Text „sauberer Hut und blaues Hemd“ Ja „blaues Hemd und sauberer Hut“ weil sie eigentlich dasselbe bedeuten, aber sie sind in umgekehrter reihenfolge.
drucken(Fuzz.-Verhältnis('Sauberer Hut und blaues Hemd','Blaues Hemd und sauberer Hut'))
#42
drucken(fuzz.partial_ratio('Sauberer Hut und blaues Hemd','Blaues Hemd und sauberer Hut'))
#42
drucken(fuzz.token_sort_ratio('Sauberer Hut und blaues Hemd','Blaues Hemd und sauberer Hut'))
#100
4. Token_Set_Ratio: kann Textähnlichkeit unter Berücksichtigung von Teiltexten erkennen, die Reihenfolge des Textes und unterschiedliche Textlängen. Sie können erkennen, dass der Text „sauberer Hut“ und „blaues Hemd“ Teil des Textes „Die Leute wollen blaues Hemd und sauberes Hemd tragen“ in einer anderen Reihenfolge sind. In diesem Studio, Wir verwenden nur "Token_Set_Ratio", da es am besten geeignet ist.
drucken(Fuzz.-Verhältnis('Sauberer Hut und blaues Hemd',Die Leute wollen blaues Hemd und sauberen Hut tragen'))
#53
drucken(fuzz.partial_ratio('Sauberer Hut und blaues Hemd',Die Leute wollen blaues Hemd und sauberen Hut tragen'))
#62
drucken(fuzz.token_sort_ratio('Sauberer Hut und blaues Hemd',Die Leute wollen blaues Hemd und sauberen Hut tragen'))
#71
drucken(fuzz.token_set_ratio('Sauberer Hut und blaues Hemd',Die Leute wollen blaues Hemd und sauberen Hut tragen'))
#100
La siguiente celda cargará el conjunto de datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... Y agregará características de hash, sowie der Anteil des Token-Pools.
# Trainingsset laden
trainingSet = pd.read_csv('D:/new_training_set.csv', index_col=0).reset_index()
# Image-Hash-Differenz berechnen
hashDiff = []
für ich In trainingSet.index:
    hash1 = imagehash.average_hash(Bild.öffnen(path_img + trainingSet.iloc[ich,2]))
    hash2 = imagehash.average_hash(Bild.öffnen(path_img + trainingSet.iloc[ich,4]))
    diff = hash1 - hash2
    hashDiff.append(unterschied)
trainingSet = trainingSet.iloc[:-1,:]
Trainingsset['Hash'] = hashDiff
# token_set_ratio berechnen
Token_test = []
für ich In trainingSet.index:
    TokenSet = fuzz.token_set_ratio(trainingSet.iloc[ich,1], trainingSet.iloc[ich,3])
    TokenSet = (ich, TokenSet)
    Token_tes.append(TokenSet)
dfToken = pd.DataFrame(token_test)
Trainingsset['Token'] = dfToken
Unten ist die Illustration des Trainingsdatensatzes. In Wirklichkeit, Es handelt sich nicht um den Originaldatensatz, da der Originaldatensatz nicht in englischer Sprache vorliegt. Ich erstelle weitere Daten auf Englisch, um sie zu verstehen. Jede Zeile enthält zwei Produkte. Die Säulen „Text 1“ e „Bild 1“ gehören zum ersten Produkt. Die Säulen „text_2“ e „Bild_2“ gehören zum zweiten Produkt. "Label" definiert, ob die passenden Produkte gleich sind (1) oder nicht (0). Beachten Sie, dass es zwei weitere Spalten gibt: „hash“ Ja „TokenSet“. Diese beiden Spalten werden generiert, nicht aus dem Originaldatensatz, aber aus dem Code oben.
| IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... | Text 1 | Bild_1 | text_2 | Bild_2 | Etikett | Hasch | TokenSet |
| 0 | Blaues Shirt | Gdsfdfs.jpg | Blaues Shirt. | Safsfs.jpg | 1 | 6 | 100 |
| 1 | Sauberer Hut | Fsdfsa.jpg | Saubere Hose | Yjdgfbs.jpg | 0 | 25 | 71 |
| 2 | Maus | Dfsdfasd.jpg | Maus | Fgasfdg.jpg | 0 | 30 | 100 |
| . . . | . . . | . . . | . . . | . . . | . . . | . . . | . . . |
Maschinelles Lernen anwenden
Jetzt, wir wissen, dass eine geringere Imagehash-Differenz und ein höheres Token_Set_Ratio darauf hindeuten, dass ein Produktpaar mit größerer Wahrscheinlichkeit gleich ist. Der niedrigste Wert von Imagehash ist 0 und der höchste Wert von Token_Set_Ratio ist 100. Aber, die frage ist wie hoch die schwellen sind. So legen Sie die Schwellenwerte fest, wir können den Entscheidungsbaum-Klassifikator verwenden.
Anhand des Trainingsdatensatzes wird ein Machine-Learning-Modell des Entscheidungsbaums erstellt. Der maschinelle Lernalgorithmus findet Bild-Hash-Differenzmuster und Token-Set-Verhältnis von identischen und unterschiedlichen Produkten. Der Entscheidungsbaum wird für das Titelbild dieses Artikels angezeigt. Der folgende Code erstellt ein Entscheidungsbaummodell mit Python. (Aber, die Anzeige des Titelbildes ist der mit R generierte Entscheidungsbaum, weil, meiner Meinung nach, R visualisiert den Entscheidungsbaum auf angenehmere Weise). Später, wird den Trainingsdatensatz neu vorhersagen. Schließlich, wir können die präzision bekommen.
# Entscheidungsbaum-Klassifikator erstellen: Hash- und Token-Set
Dtc = DecisionTreeClassifier(max_depth=4)
Dtc = Dtc.fit(trainingSet.loc[:,['Hash', 'Token']],
              trainingSet.loc[:,'Label'])
Vorhersage2 = Dtc.vorhersage(trainingSet.loc[:,['Hash', 'Token']])
metrics.accuracy_score(trainingSet.loc[:,'Label'], Vorhersage2)
Der Entscheidungsbaum wird verwendet, um die Klassifizierung des Trainingsdatensatzes erneut vorherzusagen. Präzision ist 0,728. Mit anderen Worten, das 72,8% des Trainingsdatensatzes wird richtig vorhergesagt.
Aus dem Entscheidungsbaum, Wir können die Information extrahieren, dass wenn die Imagehash-Differenz kleiner ist als 12, das Produktpaar wird als identisch eingestuft. Wenn die Imagehash-Differenz größer oder gleich ist 12, wir müssen den Token_Set_Ratio-Wert überprüfen. El Token_Set_Ratio minderwertig a 97 Bestätigen Sie, dass das Produktpaar unterschiedlich ist. Andernfalls, Überprüfen Sie erneut, ob der Differenzwert von Imagehash. Wenn die Hash-Image-Differenz größer oder gleich ist 22, dann sind die Produkte identisch. Andererseits, die produkte sind anders.
Bewerben Sie sich, um den Datensatz zu testen
Jetzt, Wir laden den Testdatensatz, wir generieren die Differenz Imagehash und Token_Set_Ratio, und schließlich werden wir vorhersagen, ob jedes Produktpaar übereinstimmt.
# Pfad zum Bild
path_img = 'D:/test_img/'
# Belastungstest-Set
test = pd.read_csv('D:/new_test_set.csv', index_col=0).reset_index()
# hashDiff-Liste
hashDiff = []
# Bildunterschied berechnen
für ich In test.index[:100]:
    hash1 = imagehash.average_hash(Bild.öffnen(path_img + test.iloc[ich,2]))
    hash2 = imagehash.average_hash(Bild.öffnen(path_img + test.iloc[ich,4]))
    diff = hash1 - hash2
    hashDiff.append(unterschied)
Prüfung['Hash'] = hashDiff
# Token_set-Liste
Token_set = []
# Textunterschied mit Token-Set berechnen
für ich In test.index:
    TokenSet = fuzz.token_set_ratio(test.iloc[ich,1], test.iloc[ich,3])
    Token_set.append(TokenSet)
Prüfung['token'] = Token_set
Nach der Berechnung der Differenz von Imagehash und Token_Set_ratio, Als nächstes müssen Sie den Entscheidungsbaum für die Erkennung von Produktübereinstimmungen anwenden.
# Produktübereinstimmung erkennen
Prüfung['labelPredict'] = np.wo(Prüfung['Hash']<12, 1,
                               np.wo(Prüfung['token']<97, 0,
                                        np.wo(Prüfung['Hash']>=22, 0, 1)))
# oder
Prüfung['labelPredict'] = Dtc.vorhersage(Prüfung[['Hash','token']])
| Index | Text 1 | Bild_1 | text_2 | Bild_2 | Hasch | TokenSet | labelPredict |
| 0 | Bleistift | Fdfgsdfhg.jpg | Kugelschreiber | Adxsee.jpg | 8 | 33 | 1 |
| 1 | HDD | Sgytueyuyt.jpg | eine gute Festplatte | Erewbva.jpg | 20 | 100 | 1 |
| 2 | Luftzug | Sadssadad.jpg | stationär | Safdfgs.jpg | 25 | 25 | 0 |
| . . . | . . . | . . . | . . . | . . . | . . . | . . . | . . . |
Die obige Tabelle ist die Illustration des Endergebnisses. Das Ziel dieses Artikels ist es zu zeigen, wie man vorhersagen kann, ob zwei Bilder und zwei Texte ähnlich oder gleich sind. Sie werden vielleicht feststellen, dass das verwendete Machine-Learning-Modell recht einfach ist und es keine Hyperparameter-Abstimmung oder Aufteilung von Trainings- und Testdaten gibt. Die andere App für maschinelles Lernen, wie baumbasierte Mengenmethoden, kann die Genauigkeit erhöhen. Aber es ist nicht unser Fokus der Diskussion hier. Wenn Sie daran interessiert sind, ein anderes baumbasiertes maschinelles Lernen zu erlernen, das genauer ist als der Entscheidungsbaum, suche hier nach einem Artikel.
Über den Autor
Verbinde dich hier mit mir https://www.linkedin.com/in/rendy-kurnia/
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





