
Einführung
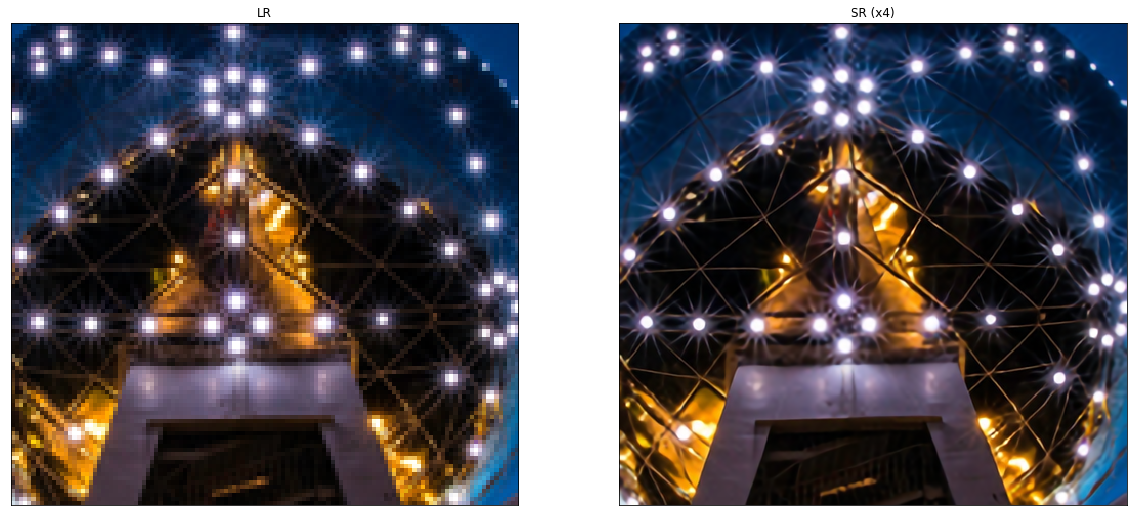
(SR) ist der Wiederherstellungsprozess hoch AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist.... (STUNDE) Bilder von niedrige Auflösung (LR) Bilder. Es ist eine wichtige Klasse von Bildverarbeitungstechniken in der Computer Vision und Bildverarbeitung und erfreut sich einer breiten Palette von realen Anwendungen., als medizinische Bilder, Satellitenbilder, Wachsamkeit und Sicherheit, astronomische Bilder, unter anderem.
Con el avance en las técnicas de tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... en los últimos años, Auf Deep Learning basierende RH-Modelle wurden aktiv erforscht und, häufig, erreichen State-of-the-Art-Performance in verschiedenen SR-Benchmarks. Zur Lösung von RH-Aufgaben wurden verschiedene Deep-Learning-Methoden angewendet, von der Methode auf Basis von Convolutional Neural Networks (CNN) auf neuere vielversprechende RH-Ansätze basierend auf ungünstigen generativen Netzwerken.
Ärger
Das Problem der Bildlöschung (SR), insbesondere die Superauflösung eines einzelnen Bildes (SISR), hat viel Aufmerksamkeit in der Forschungsgemeinschaft gewonnen. SISR zielt darauf ab, ein hochauflösendes Bild zu rekonstruieren ISR einzelnes Bild mit niedriger Auflösung ILR. Allgemein, die Beziehung zwischen mirLR und das hochauflösende Originalbild ISTUNDE kann je nach Situation variieren. Viele Studien gehen davon aus, dass ichLR ist eine reduzierte bikubische Version von ISTUNDE, aber andere erniedrigende Faktoren wie Unschärfe, Für praktische Anwendungen kommen auch Zerstörungen oder Geräusche in Betracht.
In diesem Artikel, wir konzentrieren uns auf überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in... Methoden für superauflösende Aufgaben. Bei Verwendung von HR-Bildern als Ziel und LR als Eingabe, wir können dieses Problem als überwachtes Lernproblem behandeln.
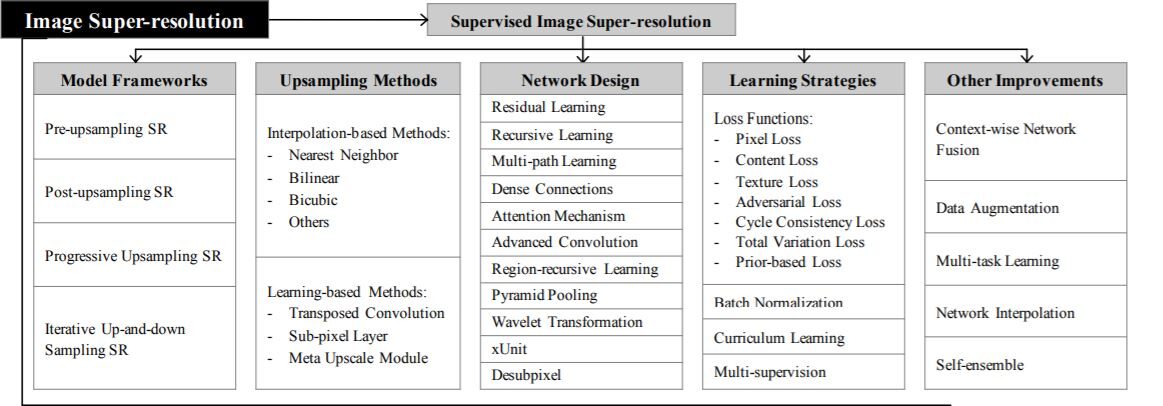
Überlegene Probenahmemethoden
Bevor Sie den Rest der Theorie hinter der Superauflösung verstehen, wir müssen verstehen Probenahme (Erhöhen Sie die räumliche Auflösung der Bilder oder erhöhen Sie einfach die Anzahl der Zeilen / Pixelspalten oder beides im Bild) und seine verschiedenen Methoden.
1. Interpolationsbasierte Methoden – Bildinterpolation (Bildskalierung) bezieht sich auf die Größenänderung digitaler Bilder und wird häufig von bildbezogenen Anwendungen verwendet. Herkömmliche Methoden umfassen die Nächster-Nachbar-Interpolation, lineare Interpolation, binaural, bikubisch, etc.
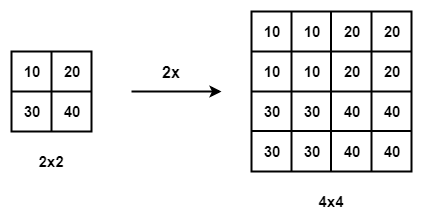
Nächster-Nachbar-Interpolation mit der Skala von 2
- Nächster Nachbar-Interpolation – Die Nearest Neighbour Interpolation ist ein einfacher und intuitiver Algorithmus. Wählt den nächstgelegenen Pixelwert für jede zu interpolierende Position unabhängig von jedem anderen Pixel.
- Bilineare Interpolation – Bilineare Interpolation (WERDEN) führt zuerst eine lineare Interpolation auf einer Achse des Bildes durch und dann auf der anderen Achse. Da es sich um eine quadratische Interpolation mit einem rezeptiven Feld von 2 × 2, zeigt eine viel bessere Leistung als die Interpolation mit dem nächsten Nachbarn, Beibehaltung einer relativ hohen Geschwindigkeit.
- Bikubische Interpolation – Ähnlich, bikubische Interpolation (BCI) führt kubische Interpolation auf jeder der beiden Achsen durch. Im Vergleich zu BLI, der BCI berücksichtigt 4 × 4 Pixel und führt zu glatteren Ergebnissen mit weniger Artefakten, aber viel geringerer Geschwindigkeit. Verweisen dazu für ein ausführliches Gespräch.
Mängel – Interpolationsbasierte Methoden führen oft zu einigen Nebenwirkungen wie der Rechenkomplexität, Rauschverstärkung, unscharfe Ergebnisse, etc.
2. Lernbasiertes Bottom-up-Sampling – Um die Unzulänglichkeiten interpolationsbasierter Methoden zu überwinden und End-to-End-Oversampling zu erlernen, die transponierte Faltungsschicht und die Subpixelschicht werden in das SR-Feld eingetragen.
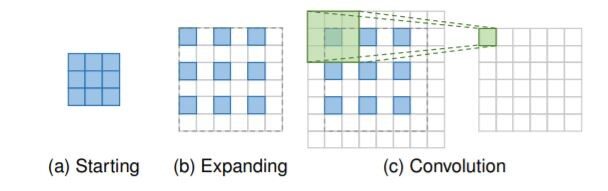
Transponierte Faltungsschicht: blaue Quadrate zeigen den Eingang an,
und die grünen Kästchen zeigen den Kernel und die Faltungsausgabe an.
- Transponierte Faltung: Schicht, auch als Dekonvolutionsschicht bekannt, versuche eine Transformation entgegen einer normalen Faltung durchzuführen, nämlich, Vorhersage möglicher Eingaben basierend auf Feature-Maps der Größe der Faltungsausgabe. Speziell, erhöht die Auflösung des Bildes durch Erweitern des Bildes durch Einfügen von Nullen und Durchführen einer Faltung.
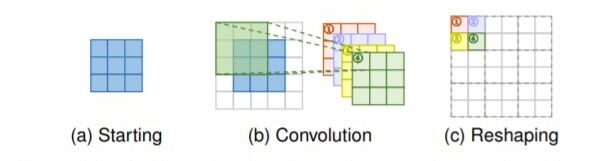
Subpixel-Ebene: blaue Kästchen zeigen die Eingabe an und Kästchen mit anderen Farben zeigen verschiedene Faltungsoperationen und verschiedene Ausgabe-Feature-Maps an.
- Subpixel-Ebene: Die Subpixel-Schicht, eine weitere Ebene des Upsampling, die von Ende zu Ende erlernt werden kann, führt Upsampling durch, indem eine Vielzahl von Kanälen durch Faltung erzeugt und dann die Programme umgeformt werden. Innerhalb dieser Schicht, eine Faltung wird zuerst angewendet, um Ausgaben mit zu erzeugen
S2 Zeitkanäle, wobei s der Skalierungsfaktor ist. Angenommen, die Eingabegröße ist h × b × c, die Ausgabegröße beträgt h × b × s2C. Danach, die Umformungsoperation wird durchgeführt, um Ausgaben mit der Größe sh × sw × c . zu erzeugen
Superresolution-Frameworks
Da die Bildsuperauflösung ein schlecht gestelltes Problem ist, wie man oversampling (nämlich, eine Herzfrequenzausgabe aus dem LR-Eingang generieren) ist das hauptproblem. Es gibt hauptsächlich vier Modellrahmen, die auf den verwendeten Top-Sampling-Operationen und ihren Positionen im Modell basieren (siehe Tabelle oben).
1. Super Pre-Sampling-Auflösung –
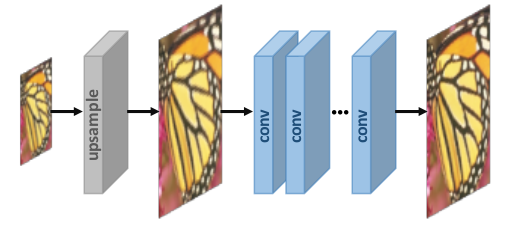
Wir führen kein direktes Mapping von LR-Bildern zu HR-Bildern durch, da dies als schwierige Aufgabe angesehen wird. Die Verwendung herkömmlicher Upsampling-Algorithmen zur Gewinnung von Bildern mit höherer Auflösung und deren anschließende Verfeinerung mit tiefen neuronalen Netzen ist eine einfache Lösung.. Zum Beispiel, LR-Bilder werden durch bikubische Interpolation zu dicken HR-Bildern mit der gewünschten Größe abgetastet. Später, tiefe CNNs werden auf diese Bilder angewendet, um qualitativ hochwertige Bilder zu rekonstruieren.
2. Superauflösung nach der Probenahme:
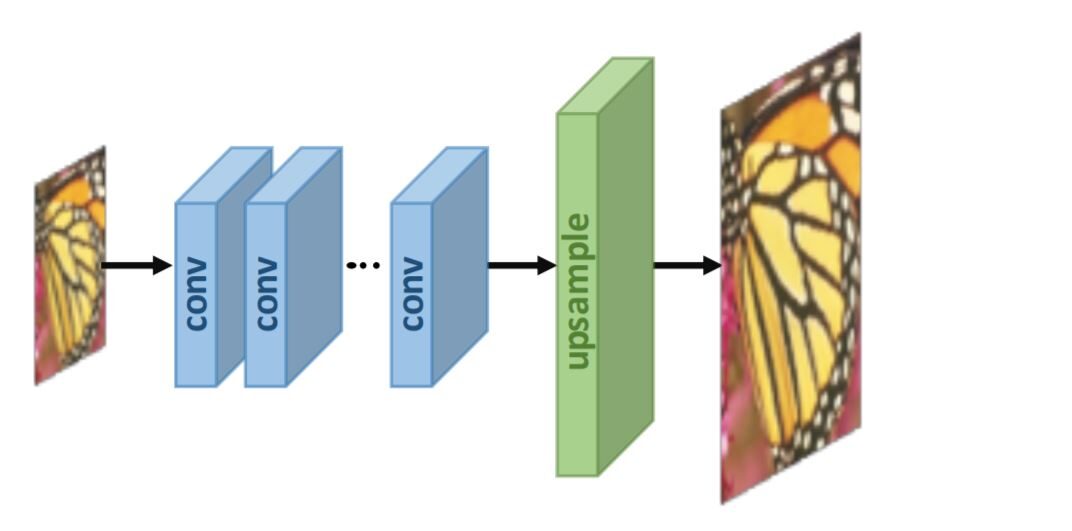
Um die Recheneffizienz zu verbessern und die Deep-Learning-Technologie vollständig zu nutzen, um die Auflösung automatisch zu erhöhen, los investigadores proponen realizar la mayoría de los cálculos en un espacio de baja Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und... reemplazando el muestreo predefinido con capas de aprendizaje de extremo a extremo integradas al final de los modelos. In der Pionierarbeit dieses Frameworks, nämlich, Nachbemusterung SR, LR-Eingangsbilder werden tief in das CNN eingespeist, ohne die Auflösung zu erhöhen, und die oberen Sampling-Schichten, die Ende-zu-Ende gelernt werden können, werden am Ende des Netzwerks angewendet.
Lernstrategien
Im Bereich der Superauflösung, Verlustfunktionen werden verwendet, um
Rekonstruktionsfehler messen und Modelloptimierung anleiten. Früher, Forscher verwenden normalerweise L2-Verlust pro Pixel (mittlerer quadratischer Fehler), aber dann stellt er fest, dass er das nicht messen kann
Rekonstruktionsqualität sehr genau. Deswegen, eine Auswahl
Verlustfunktionen (P. nicht., Inhaltsverlust, die GegnerS) werden übernommen, um den Wiederaufbau besser zu messen
Fehler und produzieren eine höhere Qualität und realistischere Ergebnisse.
- Verlust von Pixelwise L1 – Absolute Differenz zwischen den Pixeln des Ground-Truth-HR-Bildes und dem erzeugten.
- Verlust von Pixelwise L2 – Root-Mean-Square-Differenz zwischen den Pixeln des Ground-Truth-HR-Bildes und dem erzeugten.
- Verlust von Inhalten – Inhaltsverlust wird als euklidischer Abstand zwischen den High-Level-Renderings des Ausgabebilds und des Zielbilds gemeldet. High-Level-Funktionen werden erhalten, indem zuvor trainierte CNNs wie VGG und ResNet . durchlaufen werden.
- Gegnerverlust – Basierend auf GAN, wobei wir das SR-Modell als Generator behandeln und einen zusätzlichen Diskriminator definieren, um zu beurteilen, ob das Eingabebild erzeugt wird oder nicht.
- PSNR – Das Spitzensignal-Rausch-Verhältnis (PSNR) ist eine häufig verwendete objektive Metrik zur Messung der Rekonstruktionsqualität einer verlustbehafteten Transformation. PSNR ist umgekehrt proportional zum Logarithmus des mittleren quadratischen Fehlers (MSE) zwischen dem realen Bild des Geländes und dem generierten Bild.
In MSE, Ich bin ein ohne Lärm Metro×Norden monochromes Bild (grundlegende Wahrheit) und K ist das erzeugte Bild (laute Annäherung). Ein PSNR, MAXich stellt den maximal möglichen Pixelwert des Bildes dar.
Netzwerk-Layout
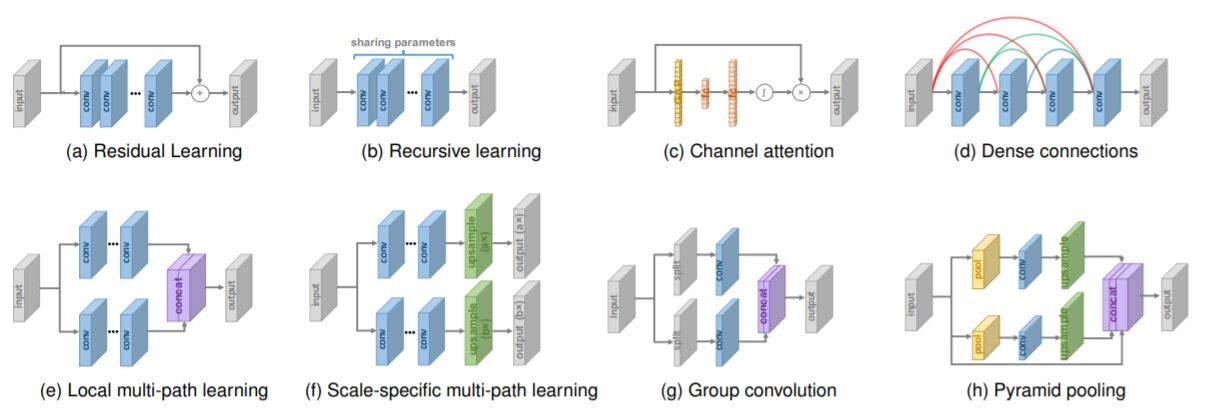
Verschiedene Netzwerkdesigns in Super-Resolution-Architektur
Genug der Grundlagen! Analysieren wir einige der Der letzte Stand der Technik Superauflösungsverfahren –
Superauflösungsverfahren
Super-Resolution Generative Adversary Network (SRGAN) – Verwenden Sie die Idee von GAN für Super-Resolution-Aufgabe, nämlich, der Generator versucht, aus dem Rauschen ein Bild zu erzeugen, das vom Diskriminator beurteilt wird. Ambos seguirán entrenando para que el generador pueda generar imágenes que puedan coincidir con los datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... reales.
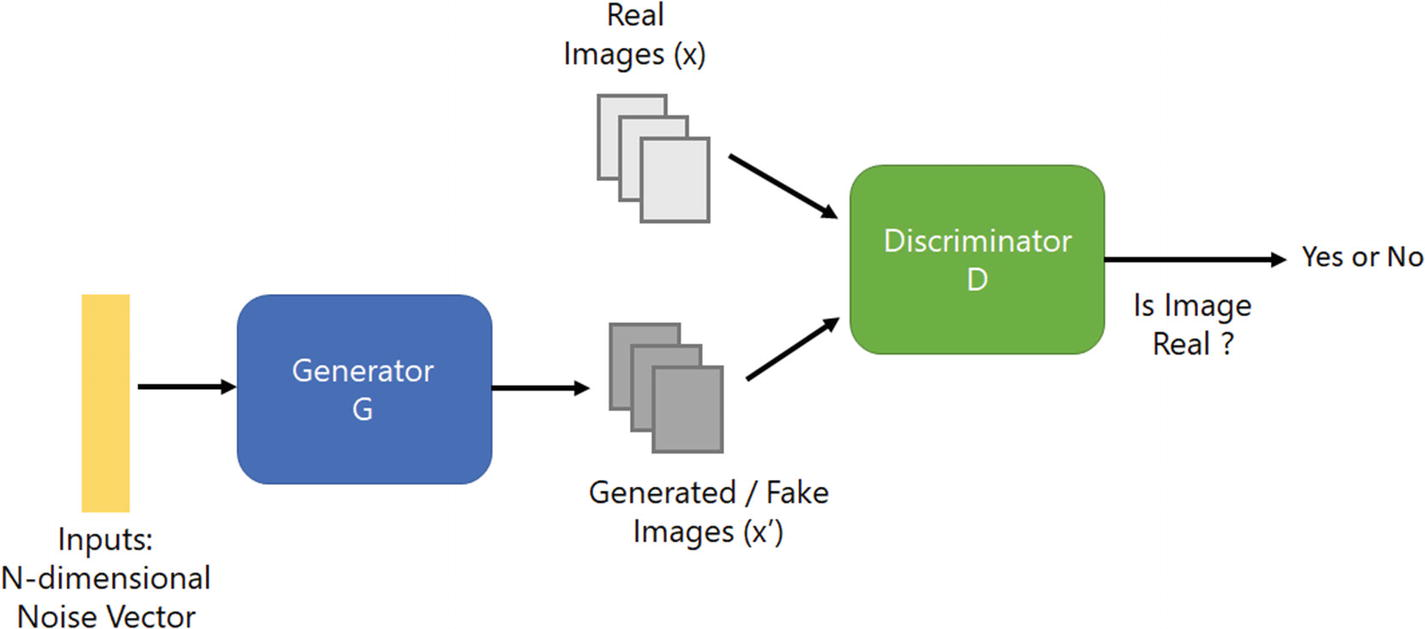
Architektur des Generative Adversary Network
Es gibt mehrere Formen der Superauflösung, aber es gibt ein Problem: Wie können wir feinere Texturdetails aus einem Bild mit niedriger Auflösung wiederherstellen, damit das Bild nicht verzerrt wird??
Die Ergebnisse haben ein hohes PSNR; die Medien haben qualitativ hochwertige Ergebnisse, aber oft fehlen hochfrequente Details.
Um dies in SRGAN . zu erreichen, wir nehmen das Verlust-FunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und... perceptiva que comprende la pérdida de contenido y de adversario.
Überprüf den Originalpapiere für detaillierte Informationen.
Schritte –
1. Wir verarbeiten HR (hochauflösende Bilder) für reduzierte Sampling-LR-Bilder. Wir haben jetzt HR- und LR-Bilder für den Trainingsdatensatz.
2. Wir leiten LR-Bilder durch einen Generator, der SR-Bilder abtastet und bereitstellt.
3. Wir verwenden den Diskriminator, um das HR-Bild zu unterscheiden und den Verlust von GAN zu propagieren, um den Diskriminator und Generator zu trainieren.
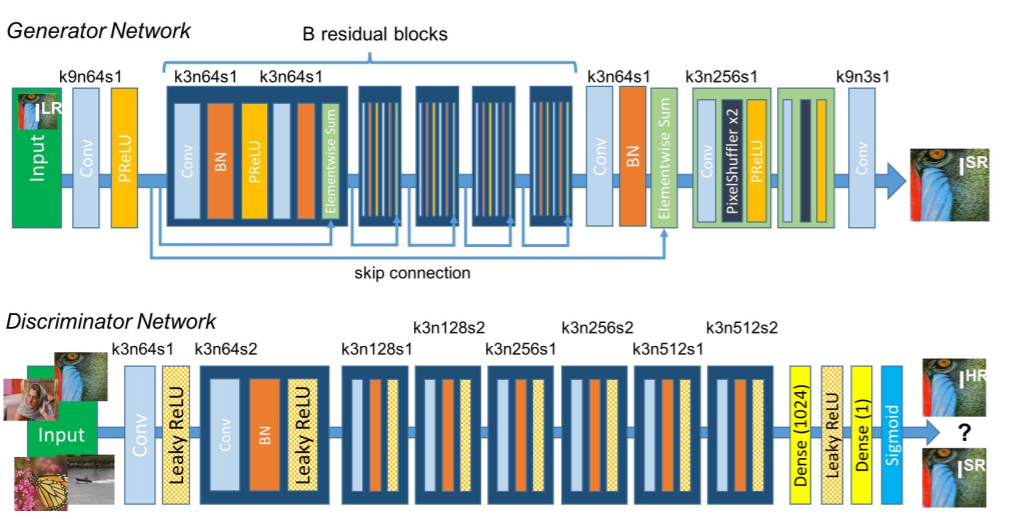
SRGAN-Netzwerkarchitektur
Hauptmerkmale der Methode:
- Rahmentyp nach der Stichprobenziehung
- Subpixel-Schicht für höheres Sampling
- Enthält Restblöcke
- Wahrnehmungsverlust nutzen
EDSR, MDSR – Ausstellung Restlerntechniken
verbesserte Super-Resolution-Leistung durch Deep Convolutional Neural Networks (DCNN). Single-Scale-Architektur Verbessertes tiefes Super-Resolution-Netzwerk (EDSR) handhabt eine bestimmte Super-Resolution-Skala und Multi-Scale Deep Super Resolution System (MDSR) rekonstruiert mehrere Maßstäbe hochauflösender Bilder in einem einzigen Modell. Deutliche Leistungssteigerung des Modells.
ist auf Optimierung durch Entfernen unnötiger Module in
konventionelle Restnetze.
Überprüf den Originalpapiere für detaillierte Informationen.
Einige der wichtigsten Merkmale der Methoden:
- Restblöcke – SRGAN hat die ResNet-Architektur erfolgreich auf Super-Resolution-Probleme mit SRResNet angewendet, weiter verbesserte Performance durch den Einsatz eines besseren ResNet-Frameworks. In der vorgeschlagenen Architektur –
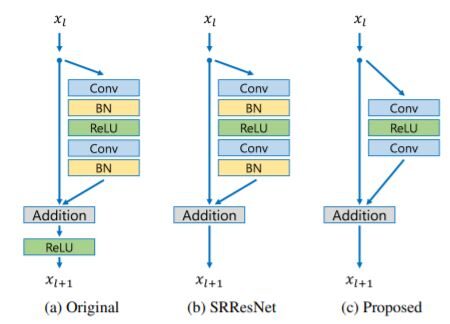
Vergleich von Restblöcken
- Quitaron las capas de StandardisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.... por lotes de la red como en SRResNets. Da Batch-Normalisierungsschichten Eigenschaften normalisieren, Eliminieren Sie die Flexibilität der Netzwerkreichweite durch die Standardisierung von Eigenschaften, es ist besser, sie zu beseitigen.
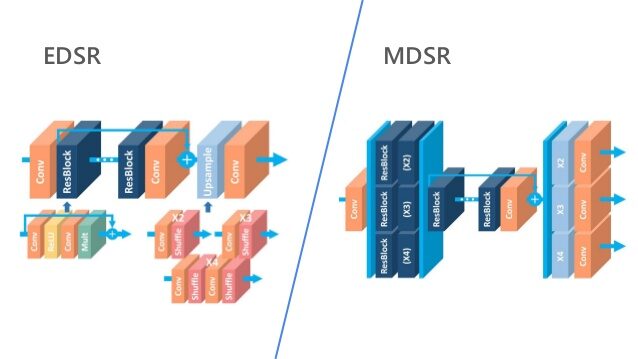
- Ein MDSR, propusieron una arquitectura multiescala que comparte la mayoría de los ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... en diferentes escalas. Das vorgeschlagene Multiskalenmodell verwendet deutlich weniger Parameter als mehrere einskalige Modelle, zeigt aber vergleichbare Leistung.
Damit sind wir nun am Ende des Blogs angelangt!! Weitere Informationen zu Superauflösung, prüfe diese Umfragejobs.
Bitte teilen Sie Ihre Kommentare zum Blog im Kommentarbereich. Viel Spaß beim Lernen
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





