
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Gradient Descent ist einer der am häufigsten verwendeten Algorithmen im maschinellen Lernen in der Industrie. Ja, aber trotzdem, verwirrt viele Neueinsteiger.
Ich verstehe es! Die Mathematik hinter der Steigerung SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... ist nicht einfach, wenn man gerade erst anfängt. Mein Ziel ist es, Ihnen in diesem Artikel eine Intuition für das Gradientenabstiegverfahren zu vermitteln.
Wir werden schnell die Rolle einer Kostenfunktion verstehen, die Erklärung des Gradientenabstiegs, wie man den Lernparameter wählt und die Auswirkungen des Überschreitens beim Gradientenabstieg. Lasst uns beginnen!
Was ist eine Kostenfunktion?
Es ist ein Funktion die die Leistung eines Modells für beliebige gegebene Daten misst. Kostenfunktion quantifiziert den Fehler zwischen den vorhergesagten Werten und den erwarteten Werten und stellt ihn als einzelne reelle Zahl dar.
Nachdem wir eine Hypothese mit ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Anfangsbuchstaben, berechnen wir die Kostenfunktion. Und mit dem Ziel, die Kostenfunktion zu reduzieren, passen wir die Parameter unter Verwendung des Gradientenabstiegsalgorithmus auf den gegebenen Daten an. Hier ist die mathematische Darstellung dafür:
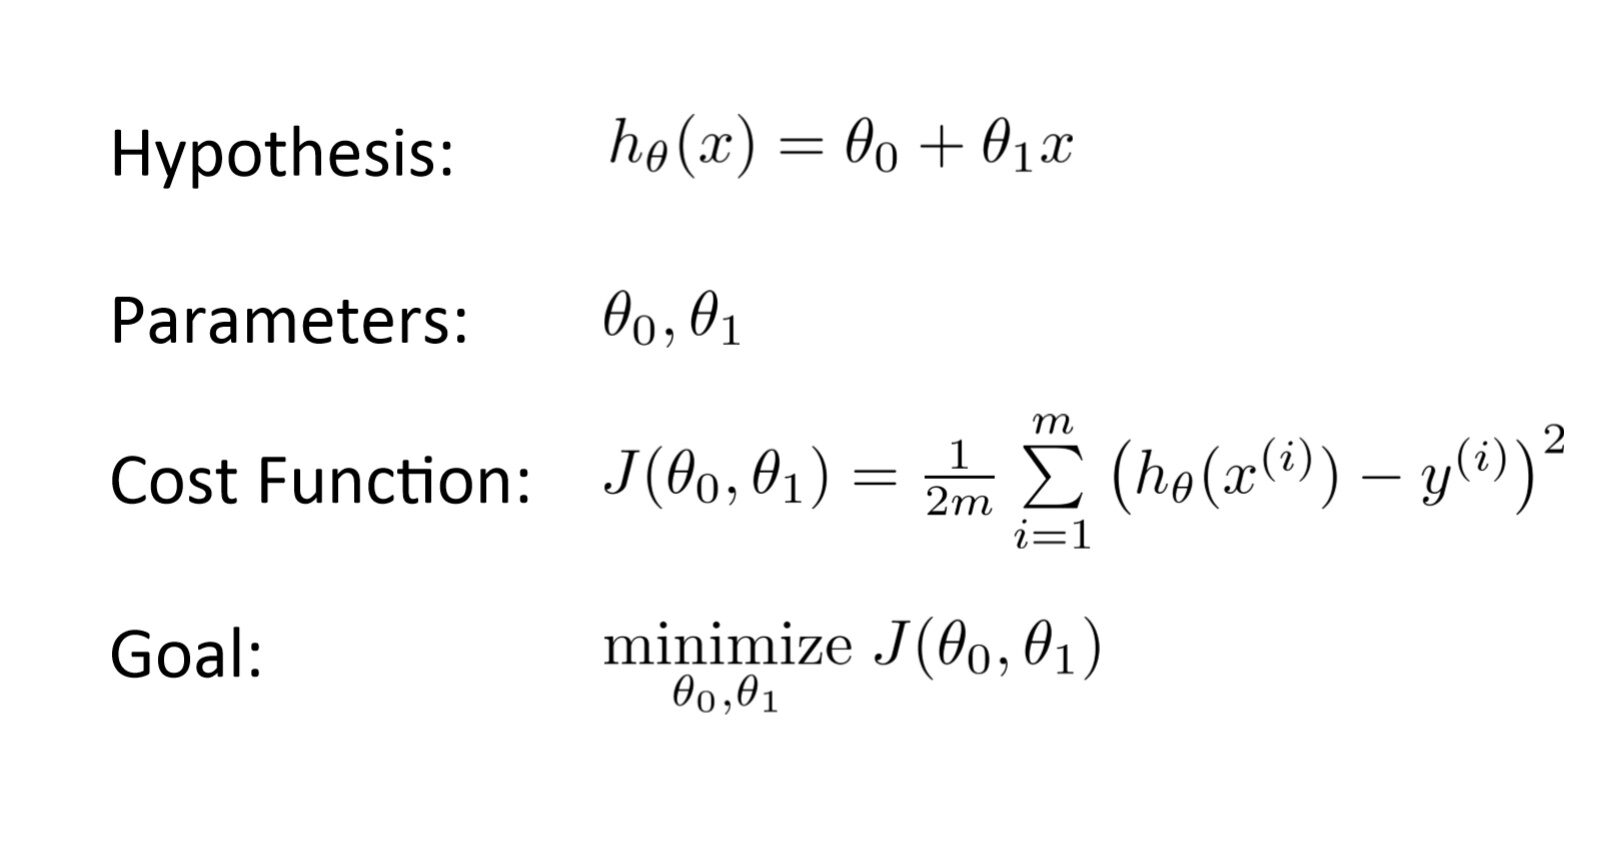
Was ist Gradient Descent?
Die Million-Dollar-Frage!
Angenommen, du spielst ein Spiel, bei dem die Spieler auf einem Berggipfel stehen und gebeten werden, den tiefsten Punkt des Berges zu erreichen. Was ist mehr, sie haben die Augen verbunden. Dann, welchen Ansatz würdest du wählen, um den See zu erreichen??
Tómate un momento para pensar en esto antes de seguir leyendo.
La mejor manera es observar el suelo y encontrar dónde desciende la tierra. Desde esa posición, da un paso en dirección descendente e itera este proceso hasta llegar al punto más bajo.
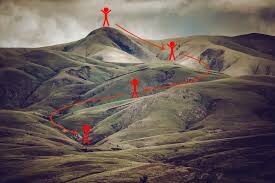 Encontrar el punto más bajo en un paisaje montañoso. (Quelle: Fisseha Berhane)
El descenso de gradiente es un Optimierungsalgorithmus machtEin Optimierungsalgorithmus ist eine Reihe von Regeln und Verfahren, die darauf ausgelegt sind, die beste Lösung für ein bestimmtes Problem zu finden, indem eine Zielfunktion maximiert oder minimiert wird. Diese Algorithmen sind in verschiedenen Bereichen grundlegend, wie zum Beispiel Ingenieurwesen, Wirtschaft und Künstliche Intelligenz, wo Effizienz verbessert und Kosten gesenkt werden sollen. Es gibt verschiedene Ansätze, einschließlich genetischer Algorithmen, Lineare Programmierung und kombinatorische Optimierungsmethoden.... iterativo para encontrar el mínimo local de una función.
Para encontrar el mínimo local de una función usando el descenso de gradiente, debemos dar pasos proporcionales al negativo del gradiente (alejarse del gradiente) de la función en el punto actual. Si damos pasos proporcionales al positivo del gradiente (moviéndonos hacia el gradiente), nos acercaremos a un máximo local de la función, und das Verfahren heißt Gradientenaufstieg.
Der Gradientabstieg wurde ursprünglich vorgeschlagen von CAUCHY In 1847. Es ist auch bekannt als steilster Abstieg.
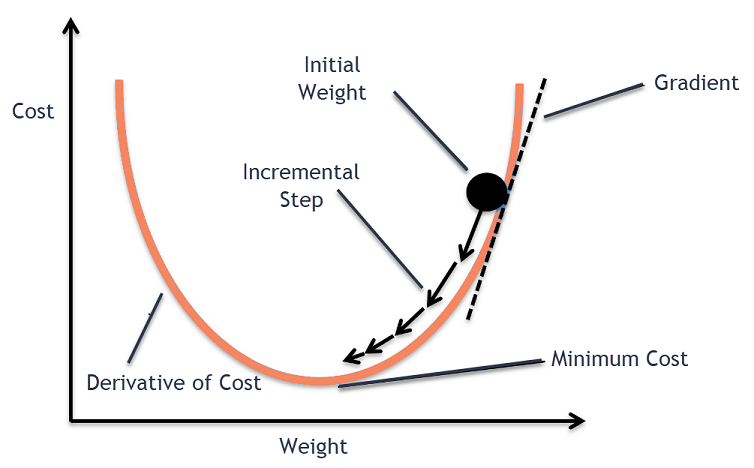
Ziel des Gradientenabstiegsalgorithmus ist es, die gegebene Funktion zu minimieren (zum Beispiel, Kostenfunktion). Um dieses Ziel zu erreichen, führt es zwei Schritte iterativ aus:
- Berechne den Gradienten (steht aus), die erste Ableitung der Funktion an diesem Punkt
- Mache einen Schritt (bewege dich) in die entgegengesetzte Richtung des Gradienten, die entgegengesetzte Richtung der Steigung vom aktuellen Punkt aus multipliziert mit Alpha mal dem Gradienten an diesem Punkt
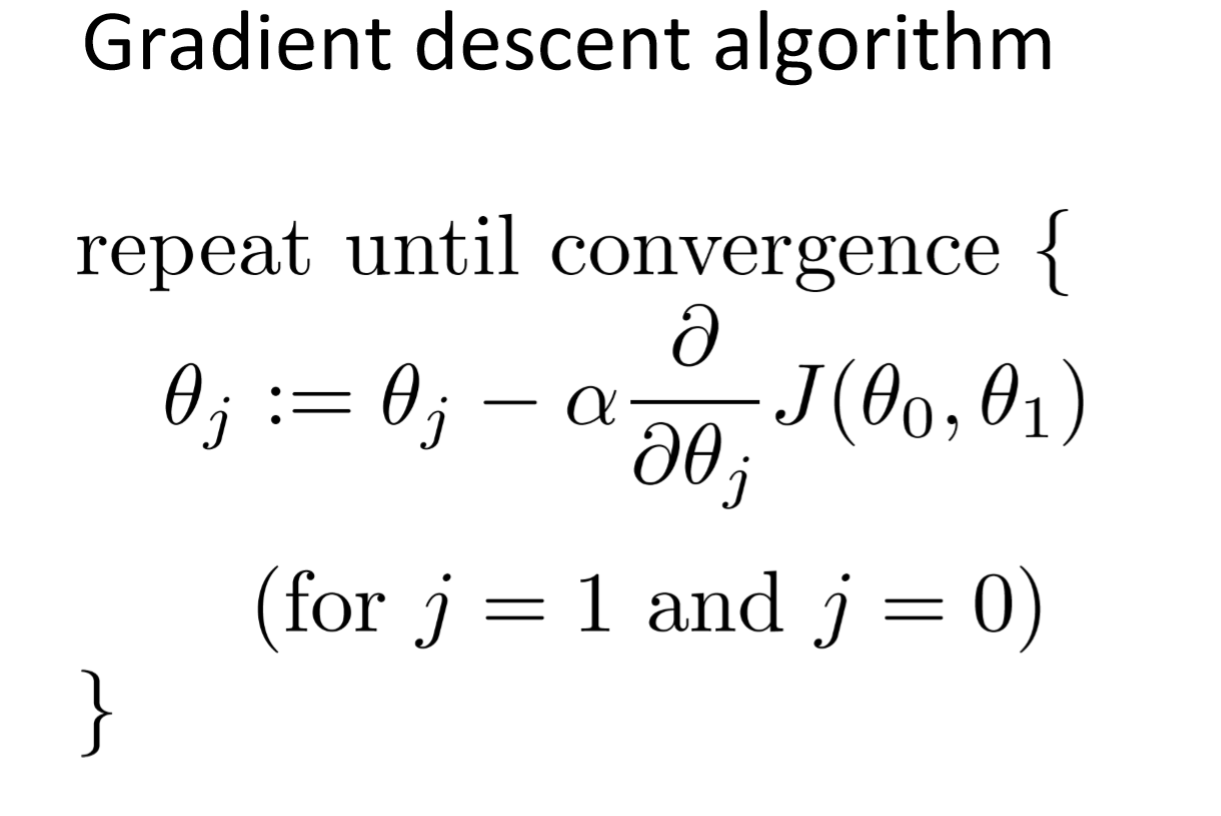
Alpha wird genannt Lernquote – ein Einstellparameter im Optimierungsprozess. Entscheidet über die Schrittgröße.
Diagramm des Gradientenabstiegsalgorithmus
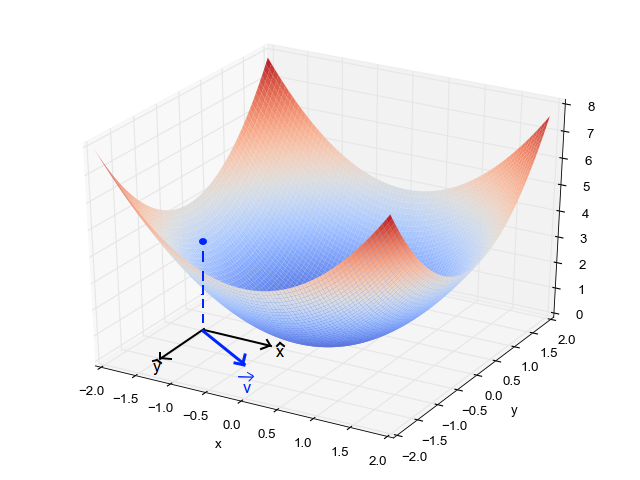
Wenn wir nur einen Parameter haben (theta), wir können die Kosten von der VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... abhängigen Variable auf der y-Achse und Theta auf der x-Achse darstellen. Wenn es zwei Parameter gibt, können wir uns für ein 3D-Diagramm entscheiden, mit den Kosten auf einer Achse und den zwei Parametern (Thetas) entlang der beiden anderen Achsen.
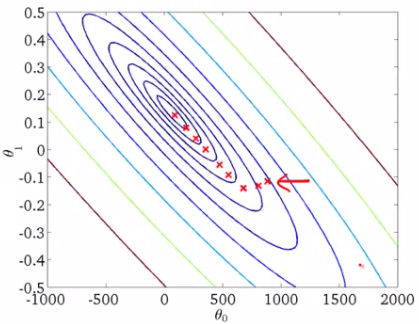
Es kann auch visualisiert werden unter Verwendung von Konturen. Dies zeigt ein 3D-Diagramm in zwei Dimensionen mit Parametern entlang beider Achsen und der Antwort als Kontur. Der Wert der Antwort steigt mit zunehmender Entfernung vom Zentrum und hat denselben Wert zusammen mit den Ringen. Die Antwort ist direkt proportional zur Entfernung eines Punktes vom Zentrum (entlang einer Richtung).
Alpha – La tasa de aprendizaje
Wir haben die Richtung, in die wir uns bewegen wollen, jetzt müssen wir die Schrittgröße bestimmen, die wir nehmen sollen.
* Sie muss sorgfältig gewählt werden, um an lokalen Minima zu enden.
- Wenn die Lernrate zu hoch ist, könnten wir ÜBERSCHREITEN die Minima und weiter prallen, ohne die Minima zu erreichen
- Wenn die Lernrate zu niedrig ist, kann das Training zu lange dauern.
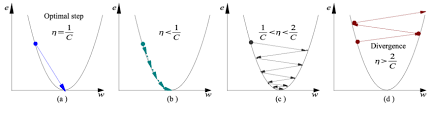
- ein) Die Lernrate ist optimal, das Modell konvergiert zum Minimum
- B) Die Lernrate ist zu niedrig, dauert länger, aber das Modell konvergiert zum Minimum
- C) Die Lernrate ist größer als der optimale Wert, es wird überschritten, aber konvergiert (1 / C <η <2 / C)
- D) Die Lernrate ist sehr hoch, es wird überschritten und divergiert, geht von den Minima weg, Die Leistung nimmt beim Lernen ab
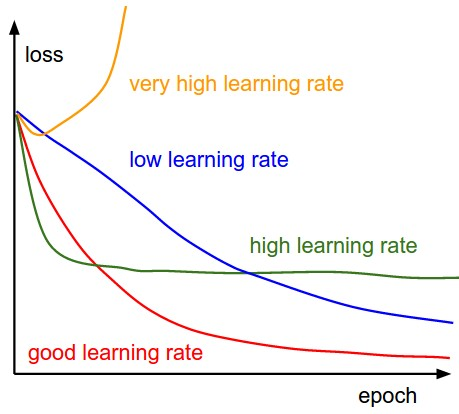
Notiz: Wenn der Gradient abnimmt, während er sich zu den lokalen Minima bewegt, die Schrittgröße nimmt ab. Deswegen, die Lernrate (alfa) kann während der Optimierung konstant sein und muss nicht iterativ variiert werden.
Lokale Minima
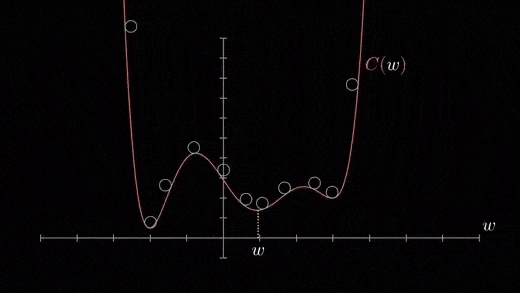
Die Kostenfunktion kann aus vielen Minimalpunkten bestehen. Der Gradient kann sich an einem der Minima einpendeln, was vom Startpunkt abhängt (nämlich, die Anfangsparameter (theta)) und die Lernrate. Deswegen, Die Optimierung kann an unterschiedlichen Punkten konvergieren, je nach Startpunkt und Lernrate.
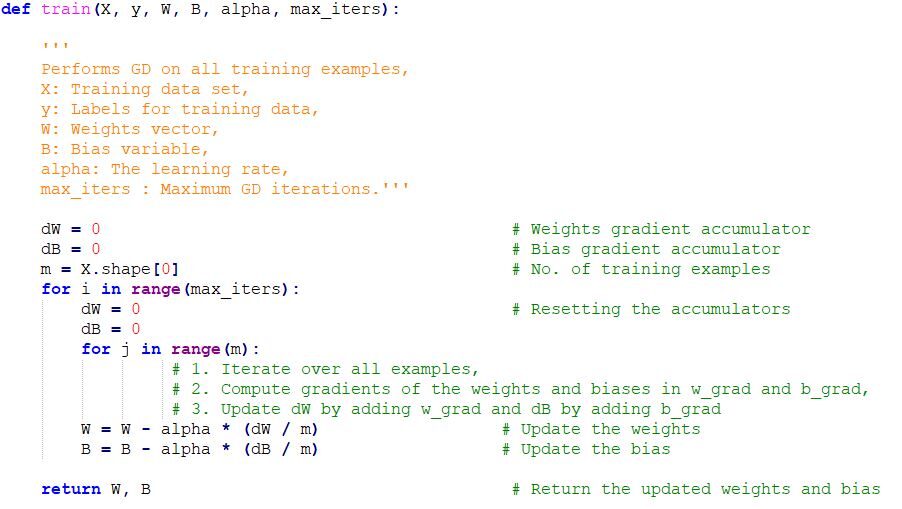
Implementierung des Gradient Descent Codes in Python
Abschließende Anmerkungen
Sobald wir den Lernparameter abgestimmt (alfa) und die optimale Lernrate erhalten, beginnen wir zu iterieren, bis wir zu den lokalen Minima konvergieren.





