
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von Analytics Vidhya und werden nach Ermessen des Autors verwendet.
Einführung
Grundsätzlich trainieren wir Maschinen, um eine Art von Automatisierung in sie aufzunehmen. Beim maschinellen Lernen, Wir verwenden verschiedene Arten von Algorithmen, damit Maschinen die Beziehungen innerhalb der bereitgestellten Daten lernen und damit Vorhersagen treffen können. Dann, Der Vorhersagetyp des Modells, bei dem wir die vorhergesagte Ausgabe benötigen, ist ein kontinuierlicher numerischer Wert, das nennt man ein regressionsproblem.
Die Regressionsanalyse dreht sich um einfache Algorithmen, häufig im Finanzbereich verwendet, Investitionen und andere, und stellt die Beziehung zwischen einer einzelnen abhängigen Variablen her, die von mehreren unabhängigen Variablen abhängt. Zum Beispiel, den Preis eines Hauses oder das Gehalt eines Mitarbeiters vorhersagen, etc., sind die häufigsten Regressionsprobleme.
Wir werden zunächst kurz die Arten von Regressionsalgorithmen diskutieren und dann zu einem Beispiel übergehen. Diese Algorithmen können sowohl linear als auch nichtlinear sein.
Lineare ML-Algorithmen
Lineare Regression
Es ist ein häufig verwendeter Algorithmus und kann aus der Klasse Lineare Regression importiert werden. Ein einzelnes VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Eintrag (die bedeutenden) eine oder mehrere Ausgabevariablen vorhersagen, unter der Annahme, dass die Eingangsvariablen nicht miteinander korreliert sind. stell dich dar als:
y = b * x + C
wobei variabel abhängig von y, unabhängig von x, Steigung b der Linie der besten Anpassung, die eine genaue Ausgabe erhalten könnte und c – ihre Kreuzung. Es sei denn, es gibt eine genaue Linie, die die abhängigen und unabhängigen Variablen miteinander verbindet, es könnte zu einem Verlust bei der Leistung kommen, der normalerweise als Quadrat der Differenz zwischen der erwarteten und der tatsächlichen Leistung angenommen wird, nämlich, das Verlust-FunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und....
Wenn Sie mehr als eine unabhängige Variable verwenden, um Ergebnisse zu erhalten, es wird genannt Multiple lineare Regression. Dieser Modelltyp geht davon aus, dass zwischen der gegebenen Kennlinie und der Ausgabe ein linearer Zusammenhang besteht, was ist sein Einschränkung.
Ridge-Regression: la norma L2
Dies ist eine Art von Algorithmus, der eine Erweiterung einer linearen Regression ist, die versucht, den Verlust zu minimieren, verwendet auch mehrere Regressionsdaten. Seine Koeffizienten werden nicht durch gewöhnliche kleinste Quadrate geschätzt (MCO), aber für eine schätzerDas "Schätzer" ist ein statistisches Instrument, mit dem aus einer Stichprobe Merkmale einer Grundgesamtheit abgeleitet werden können. Es stützt sich auf mathematische Methoden, um genaue und zuverlässige Schätzungen zu liefern. Es gibt verschiedene Arten von Schätzern, wie die Unvoreingenommenheit und die konsequente, die je nach Kontext und Ziel der Studie ausgewählt werden. Seine korrekte Anwendung ist für die wissenschaftliche Forschung unerlässlich, Umfragen und Datenanalysen.... Wappen genannt, die verzerrt ist und eine geringere Varianz hat als der OLS-Schätzer, so erhalten wir eine Kontraktion der Koeffizienten. Bei dieser Art von Modell, Wir können auch die Komplexität des Modells reduzieren.
Obwohl hier die Kontraktion des Koeffizienten auftritt, werden nicht vollständig auf Null reduziert. Deswegen, Ihr endgültiges Modell enthält immer noch alles.
Schleifenregression: der L1-Standard
Es ist der absolute Mindestauswahl- und Schrumpfungsoperator. Dies bestraft die Summe der Absolutwerte der Koeffizienten, um den Vorhersagefehler zu minimieren. Lässt die Regressionskoeffizienten für einige der Variablen auf null sinken. Es kann mit der LASSO-Klasse gebaut werden. Einer der Vorteile der Schleife ist die gleichzeitige Auswahl von Funktionen. Dies trägt dazu bei, Vorhersageverluste zu minimieren. Zweitens, wir müssen bedenken, dass lasso keine gruppenauswahl treffen kann, wählt auch Funktionen vor der Sättigung aus.
Sowohl die Schlaufe als auch der Kamm sind Methoden zur RegulierungDie Regularisierung ist ein administrativer Prozess, der darauf abzielt, die Situation von Personen oder Organisationen zu formalisieren, die außerhalb des gesetzlichen Rahmens tätig sind. Dieses Verfahren ist unerlässlich, um Rechte und Pflichten zu gewährleisten, sowie zur Förderung der sozialen und wirtschaftlichen Inklusion. In vielen Ländern, Die Regularisierung wird in Migrationskontexten angewendet, Arbeit und Steuern, denjenigen, die sich in irregulären Situationen befinden, den Zugang zu Leistungen zu ermöglichen und sich vor möglichen Sanktionen zu schützen.....
Quelle: Unsplash
Gehen wir einige Beispiele durch:
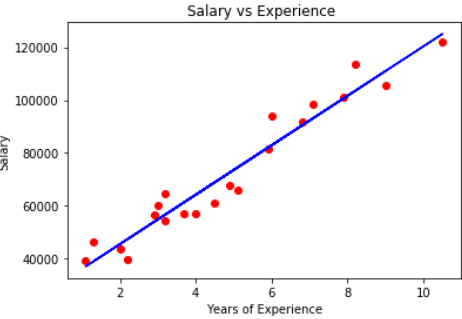
Nehmen wir an, Daten mit langjähriger Erfahrung und Gehalt von verschiedenen Mitarbeitern. Unser Ziel ist es, ein Modell zu schaffen, das prognostiziert das Gehalt des Mitarbeiters basierend auf jahrelanger Erfahrung. Da es eine unabhängige und eine abhängige Variable enthält, wir können für dieses Problem eine einfache lineare Regression verwenden.
Nichtlineare ML-Algorithmen
Entscheidungsbaumregression
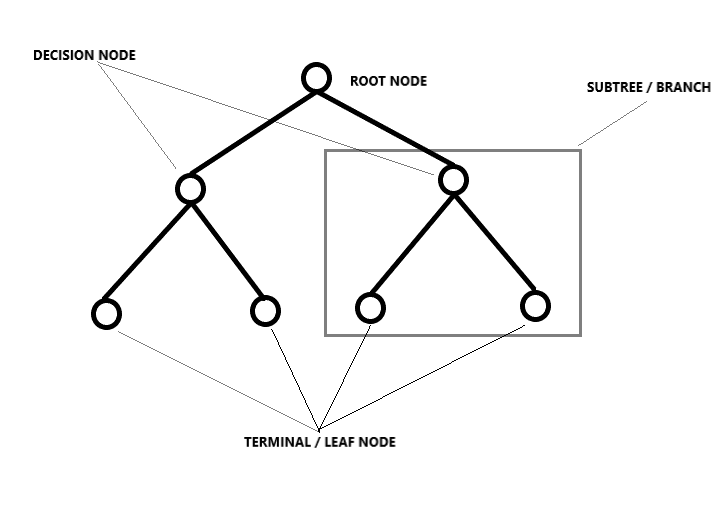
Zerlegt einen Datensatz in immer kleinere Teilmengen, indem er geteilt wird, Ergebnis ist ein Baum mit Entscheidungsknoten und Blattknoten. Die Idee hier ist, einen Wert für jeden neuen Datenpunkt zu zeichnen, der das Problem verbindet. Die Art und Weise, in der die Teilung durchgeführt wird, wird durch die ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... und der Algorithmus, und die Division stoppt, wenn die Mindestanzahl der hinzuzufügenden Informationen erreicht ist. Entscheidungsbäume zahlen sich oft aus, aber auch wenn sich die Daten leicht ändern, die ganze struktur ändert sich, was bedeutet, dass die Modelle instabil werden.
Quelle: entspritzen
Nehmen wir einen Fall von Hauspreisvorhersage, eine Reihe von gegeben 13 Funktionen und Umgebung 500 Reihen, hier müssen Sie den Hauspreis vorhersagen. Da Sie hier eine beträchtliche Anzahl von Proben haben, Sie müssen sich für Bäume oder andere Methoden entscheiden, um Werte vorherzusagen.
Zufälliger Wald
Die Idee hinter der Random Forest-Regression ist, dass, um das Ergebnis zu finden, mehrere Entscheidungsbäume verwenden. Die Schritte dazu sind:
– Wähle K zufällige Datenpunkte aus dem Trainingssatz.
– Erstellen Sie einen Entscheidungsbaum, der diesen Datenpunkten zugeordnet ist
– Wählen Sie die Anzahl der Bäume, die wir bauen müssen, und wiederholen Sie die obigen Schritte (als Argument angegeben)
– Für einen neuen Datenpunkt, lassen Sie jeden der Bäume Werte der abhängigen Variablen für die gegebene Eingabe vorhersagen.
– Weisen Sie den Mittelwert der prognostizierten Werte der tatsächlichen Endleistung zu.
Dies ist vergleichbar mit dem Erraten der Anzahl der Kugeln in einer Schachtel.. Angenommen, wir schreiben zufällig die von vielen Personen gegebenen Vorhersagewerte auf und berechnen dann den Durchschnitt, um eine Entscheidung über die Anzahl der Bälle in der Box zu treffen.. Der Random Forest ist ein Modell, das mehrere Entscheidungsbäume verwendet, die wir kennen, aber da es viele Bäume hat, erfordert auch viel Zeit zum Trainieren und Rechenleistung, was immer noch eine Unannehmlichkeit ist.
K Nächste Nachbarn (Modell KNN)
Es kann ab der Klasse KNearestNeighbors verwendet werden. Sie sind einfach und leicht zu implementieren. Für einen Eintrag im Datensatz, Der nächste Nachbar K hilft bei der Suche nach den ähnlichsten k Instanzen in der Menge von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen..... Jeder der Durchschnittswerte der MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... der Nachbarn wird als Wert für diesen Eingang.
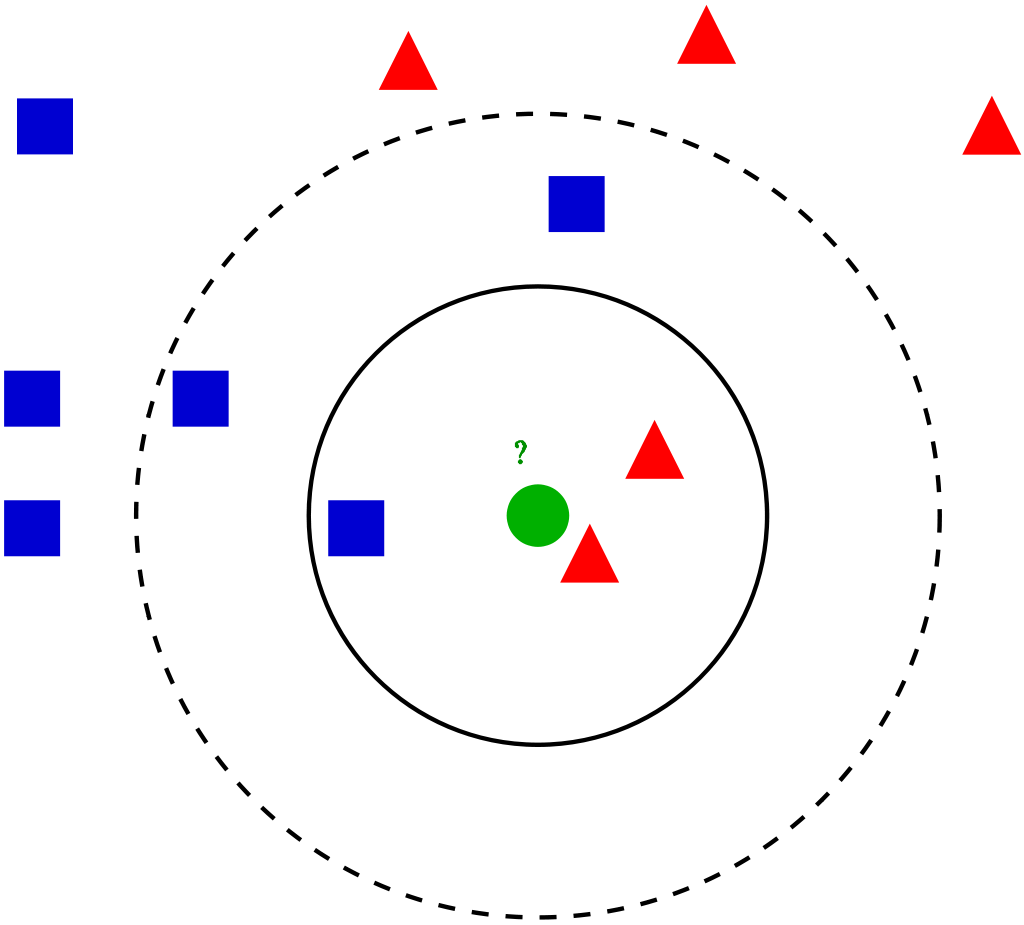
Quelle: entspritzen
Die Methode zum Finden des Wertes kann als Argument angegeben werden, dessen Standardwert ist „Minkowski“, eine Kombination von Entfernungen „Euklidisch“ Ja „Manhattan“.
Vorhersagen können langsam sein, wenn die Daten groß und von schlechter Qualität sind. Da die Vorhersage alle Datenpunkte berücksichtigen muss, das Modell nimmt während des Trainings mehr Platz ein.
Support-Vektor-Maschinen (SVM)
Kann lineare und nichtlineare Regressionsprobleme lösen. Wir erstellen ein SVM-Modell mit der SVR-Klasse. in einem mehrdimensionaler Raum, wenn wir mehr als eine Variable haben, um die Ausgabe zu bestimmen, dann ist jeder der Punkte kein Punkt mehr wie in 2D, aber es sind Vektoren. Die extremste Art der Wertzuweisung kann mit dieser Methode durchgeführt werden. Sie trennen Klassen und geben ihnen Werte. Die Trennung erfolgt nach dem Konzept von Max-Margin (eine Hyperebene). Zu beachten ist, dass SVMs nicht geeignet sind, Werte für große Trainingssätze vorherzusagen.. SVM Versagen wenn Daten lauter sind.
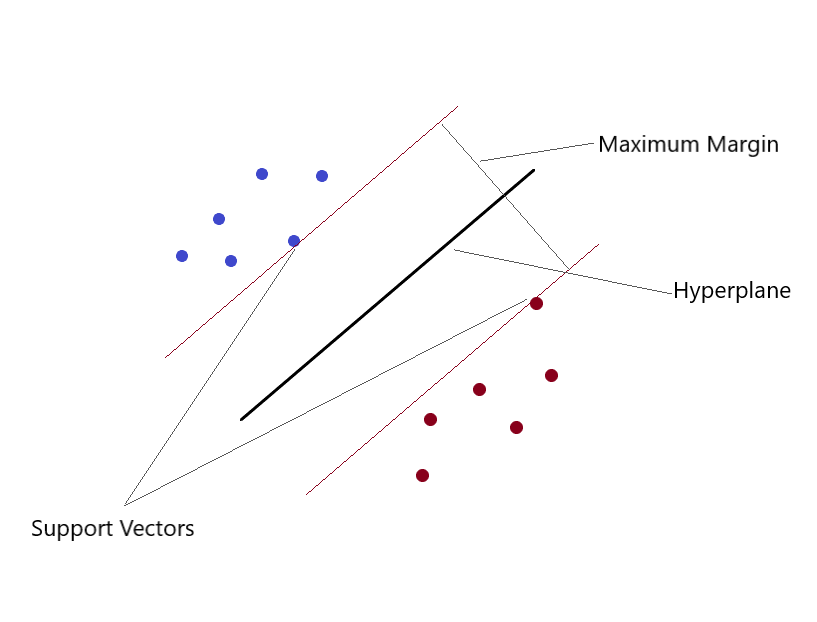
Quelle: entspritzen
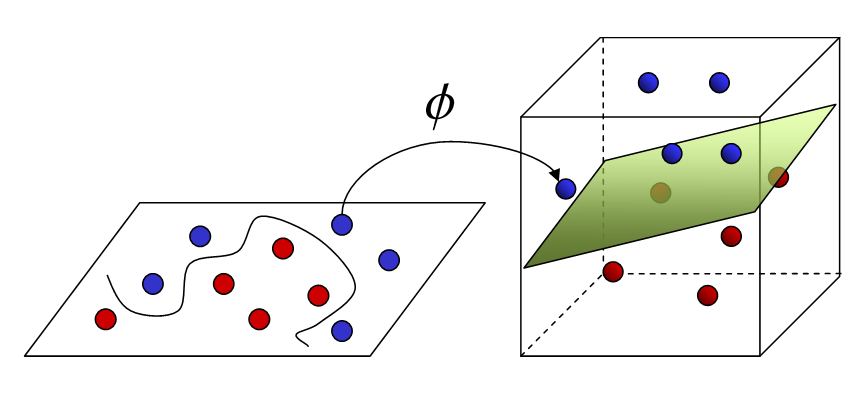
Quelle: entspritzen
Wenn die Trainingsdaten viel größer sind als die Anzahl der Funktionen, KNN ist besser als SVM. SVM übertrifft KNN, wenn es größere Funktionen und weniger Trainingsdaten gibt.
Gut, wir sind am ende dieses artikels angelangt, wir haben kurz die Arten von Regressionsalgorithmen diskutiert (Theorie). Este es Surabi, Ich habe einen Abschluss in Technik. Schau mich an LinkedIn Profil und verbinden. Ich hoffe es hat dir Spaß gemacht das zu lesen. Vielen Dank.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von Analytics Vidhya und werden nach Ermessen des Autors verwendet.





