
Beginnen wir mit einer kurzen Beschreibung des Problems.
Problemstellung: Erstellen Sie ein einfaches lineares Regressionsmodell, um eine Gehaltserhöhung anhand jahrelanger Erfahrung vorherzusagen.
Beginnen Sie mit dem Importieren der erforderlichen Bibliotheken
erforderliche Bibliotheken sind Pandas, NumPy zum Arbeiten mit Datenrahmen, matplotlib, seaborn für Visualisierungen und Sklearn, statsmodels zum Konstruieren von Regressionsmodellen.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline
import seaborn as sns
from scipy import stats
from scipy.stats import probplot
import statsmodels.api as sm
import statsmodels.formula.api as smf
from sklearn import preprocessing
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score
Sobald wir mit dem Importieren von Bibliotheken fertig sind, wir erstellen einen Pandas-Datenrahmen aus der CSV-Datei
df = pd.read_csv(„Gehaltsdaten.csv“)
EDA durchführen (explorative Datenanalyse)
Die grundlegenden Schritte von EDA sind:
- Identifizieren Sie die Anzahl der Funktionen oder Spalten
- Identifizieren Sie die Merkmale oder Spalten
- Identifizieren Sie die Größe des Datensatzes
- Identifizierung der Datentypen der Merkmale
- Prüfen, ob der Datensatz leere Zellen enthält
- Identifizieren Sie die Anzahl der leeren Zellen nach Merkmalen oder Spalten
- Umgang mit fehlenden Werten und Ausreißern
- Codierung kategorialer Variablen
- Univariate grafische Analyse, bivariado
- NormalisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.... und Skaliert
len(df.spalten) # Identifizieren Sie die Anzahl der Funktionendf.spalten # identifiziere die Funktionen
df.shape # identify the size of of the datasetUn "dataset" o conjunto de datos es una colección estructurada de información, que puede ser utilizada para análisis estadísticos, machine learning o investigación. Los datasets pueden incluir variables numéricas, categóricas o textuales, y su calidad es crucial para obtener resultados fiables. Su uso se extiende a diversas disciplinas, como la medicina, la economía y la ciencia social, facilitando la toma de decisiones informadas y el desarrollo de modelos predictivos....df.dtypes # identify the datatypes of the featuresdf.isnull().values.any() # checking if dataset has empty cellsdf.isnull().sum() # identify the number of empty cellsUnser Datensatz hat zwei Spalten: Langjährige Erfahrung, Gehalt. Und beide sind vom Datentyp Float. Verfügen über 30 Datensätze und wir haben keine Nullen oder Ausreißer in unserem Datensatz.
Univariate grafische Analyse
Für univariate Analyse, haben Histogramm, Dichtediagramm, Box-Plot Ö Geige, Ja Normales QQ-Diagramm. Sie helfen uns, die Verteilung von Datenpunkten und das Vorhandensein von Ausreißern zu verstehen.
ein Violin-DiagrammDas Geigendiagramm ist eine grafische Darstellung, die Merkmale eines Boxplots und eines Dichtediagramms kombiniert. Wird verwendet, um die Verteilung eines Datasets zu visualisieren, zeigt sowohl den Median als auch die Variabilität durch ihre Form, die einer Geige ähnelt. Diese Art von Diagramm ist sehr nützlich für die statistische Analyse, Da es ermöglicht, mehrere Verteilungen auf klare und effektive Weise zu vergleichen.... es un método para trazar datos numéricos. Es ähnelt einem Boxplot, unter Hinzufügung eines auf jeder Seite gedrehten Korndichtediagramms.
Python-Code:
# Histogram
# We can use either plt.hist or sns.histplot
plt.figure(figsize=(20,10))
plt.subplot(2,4,1)
plt.hist(df['YearsExperience'], density=False)
plt.title("Histogram of 'YearsExperience'")
plt.subplot(2,4,5)
plt.hist(df['Salary'], density=False)
plt.title("Histogram of 'Salary'")

# Density plot
plt.subplot(2,4,2)
sns.distplot(df['YearsExperience'], kde=True)
plt.title("Density distribution of 'YearsExperience'")
plt.subplot(2,4,6)
sns.distplot(df['Salary'], kde=True)
plt.title("Density distribution of 'Salary'")

# boxplot or violin plot
# A violin plot is a method of plotting numeric data. It is similar to a box plot,
# with the addition of a rotated kernel density plot on each side
plt.subplot(2,4,3)
# plt.boxplot(df['YearsExperience'])
sns.violinplot(df['YearsExperience'])
# plt.title("Boxlpot of 'YearsExperience'")
plt.title("Violin plot of 'YearsExperience'")
plt.subplot(2,4,7)
# plt.boxplot(df['Salary'])
sns.violinplot(df['Salary'])
# plt.title("Boxlpot of 'Salary'")
plt.title("Violin plot of 'Salary'")

# Normal Q-Q plot
plt.subplot(2,4,4)
probplot(df['YearsExperience'], plot=plt)
plt.title("Q-Q plot of 'YearsExperience'")
plt.subplot(2,4,8)
probplot(df['Salary'], plot=plt)
plt.title("Q-Q plot of 'Salary'")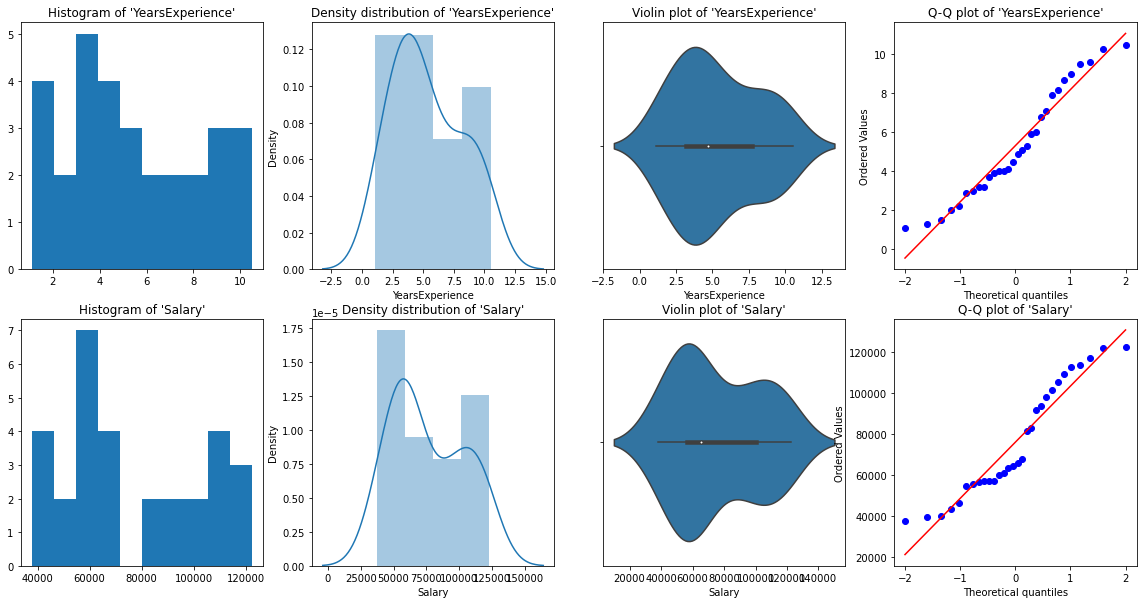
Aus den grafischen Darstellungen oben, Wir können sagen, dass es keine Ausreißer in unseren Daten gibt, Ja YearsExperience looks like normally distributed, and Salary doesn't look normal. Wir können dies überprüfen mit Shapiro Test.
Python-Code:
# Def a function to run Shapiro test

# Defining our Null, Alternate Hypothesis
Ho = 'Data is Normal'
Ha="Data is not Normal"

# Defining a significance value
alpha = 0.05
def normality_check(df):
    for columnName, columnData in df.iteritems():
        print("Shapiro test for {columnName}".format(columnName=columnName))
        res = stats.shapiro(columnData)
#         print(res)
        pValue = round(res[1], 2)

        # Writing condition
        if pValue > alpha:
            print("pvalue = {pValue} > {alpha}. We fail to reject Null Hypothesis. {Ho}".format(pValue=pValue, alpha=alpha, Ho=Ho))
        else:
            print("pvalue = {pValue} <= {alpha}. We reject Null Hypothesis. {Ha}".format(pValue=pValue, alpha=alpha, Ha=Ha))


# Drive code
normality_check(df)
Unser Grafikinstinkt war richtig. Jahre Erfahrung wird normal verteilt und Gehalt wird nicht normal verteilt.
Bivariate Anzeige
für numerische Daten vs. numerische Daten, Wir können die folgenden Graphen zeichnen
- Streudiagramm
- Liniendiagramm
- Heatmap für Korrelation
- Gemeinschaftsgrundstück
Python-Code für mehrere Pakete:
# Scatterplot & Line plots
plt.figure(figsize=(20,10))
plt.subplot(1,3,1)
sns.scatterplot(data=df, x="YearsExperience", y="Salary", hue="YearsExperience", alpha=0.6)
plt.title("Scatter plot")
plt.subplot(1,3,2)
sns.lineplot(data=df, x="YearsExperience", y="Salary")
plt.title("Line plot of YearsExperience, Salary")
plt.subplot(1,3,3)
sns.lineplot(data=df)
plt.title('Line Plot')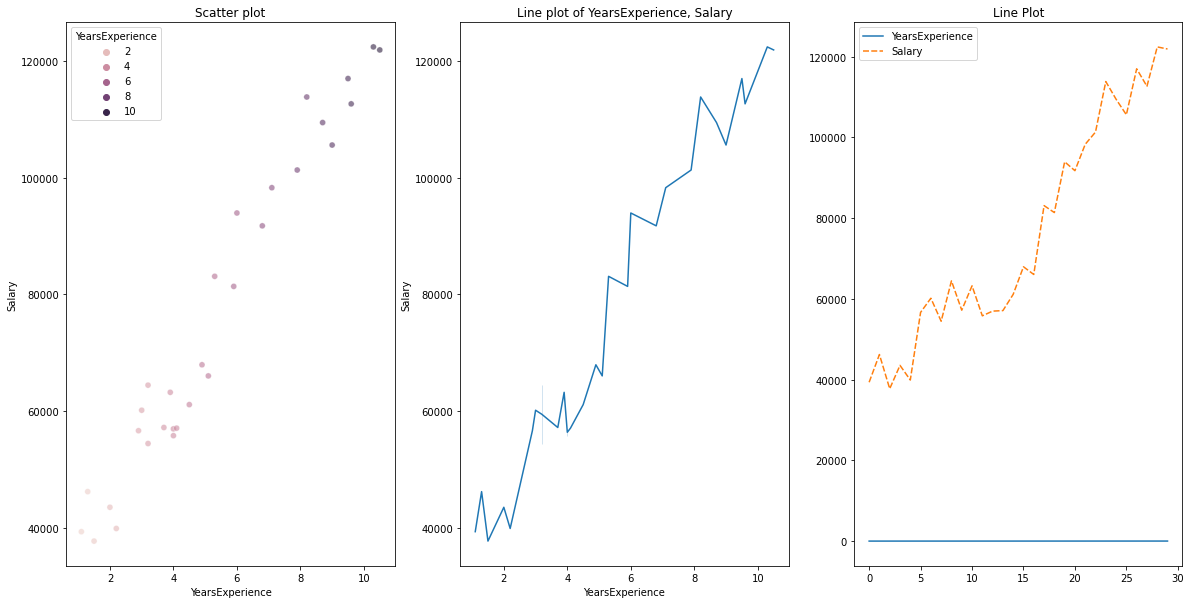
# heatmap
plt.figure(figsize=(10, 10))
plt.subplot(1, 2, 1)
sns.heatmap(data=df, cmap="YlGnBu", annot = True)
plt.title("Heatmap using seaborn")
plt.subplot(1, 2, 2)
plt.imshow(df, cmap ="YlGnBu")
plt.title("Heatmap using matplotlib")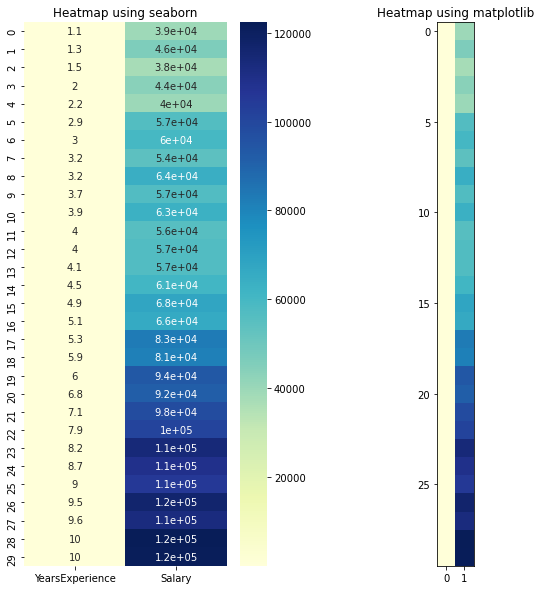
# Joint plot
sns.jointplot(x = "YearsExperience", y = "Salary", kind = "reg", data = df)
plt.title("Joint plot using sns")
# kind can be hex, kde, scatter, reg, hist. When kind='reg' it shows the best fit line.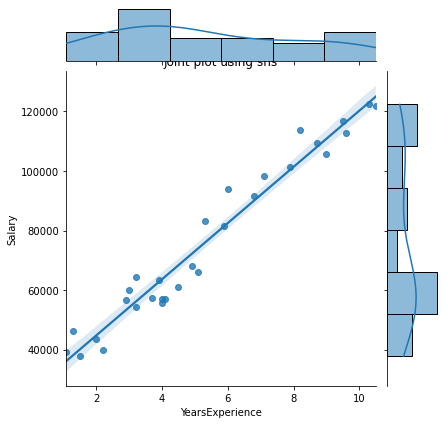
Überprüfen Sie mit df.corr, ob es eine Korrelation zwischen den Variablen gibt ()
print("Correlation: "+ 'n', df.corr()) # 0.978 which is high positive correlation
# Draw a heatmap for correlation matrix
plt.subplot(1,1,1)
sns.heatmap(df.corr(), annot=True)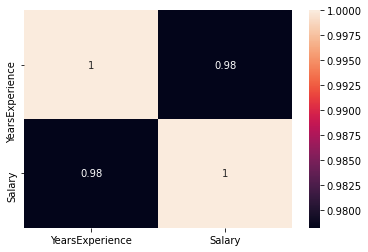
Korrelation = 0,98, was eine hohe positive Korrelation ist. Esto significa que la VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... dependiente aumenta a medida que aumenta la variable independiente.
Normalisierung
Wie wir sehen können, es gibt einen großen Unterschied zwischen den Werten der YearsExperience-Spalten, Gehalt. Wir können benutzen Normalization um die Werte numerischer Spalten im Datensatz zu ändern, um eine gemeinsame Skala zu verwenden, ohne Unterschiede in den Wertebereichen zu verfälschen oder Informationen zu verlieren.
Wir gebrauchen sklearn.preprocessing.Normalize um unsere Daten zu normalisieren. Gibt Werte zwischen . zurück 0 Ja 1.
# Create new columns for the normalized values
df['Norm_YearsExp'] = preprocessing.normalize(df[['YearsExperience']], axis=0)
df['Norm_Salary'] = preprocessing.normalize(df[['Salary']], axis=0)
df.head()
Lineare Regression mit scikit-learn
LinearRegression(): LinearRegression entspricht einem linearen Modell mit Koeffizienten β = (β1,…, βp) um die Restquadratsumme zwischen den beobachteten Zielen im Datensatz und den durch die lineare Näherung vorhergesagten Zielen zu minimieren.
def regression(df):
#     defining the independent and dependent features
    x = df.iloc[:, 1:2]
    y = df.iloc[:, 0:1]
    # print(x,y)

    # Instantiating the LinearRegression object
    regressor = LinearRegression()

    # Training the model
    regressor.fit(x,y)

    # Checking the coefficients for the prediction of each of the predictor
    print('n'+"Coeff of the predictor: ",regressor.coef_)

    # Checking the intercept
    print("Intercept: ",regressor.intercept_)

    # Predicting the output
    y_pred = regressor.predict(x)
#     print(y_pred)

    # Checking the MSE
    print("Mean squared error(MSE): %.2f" % mean_squared_error(y, y_pred))
    # Checking the R2 value
    print("Coefficient of determination: %.3f" % r2_score(y, y_pred)) # Evaluates the performance of the model # says much percentage of data points are falling on the best fit line

    # visualizing the results.
    plt.figure(figsize=(18, 10))
    # Scatter plot of input and output values
    plt.scatter(x, y, color="teal")
    # plot of the input and predicted output values
    plt.plot(x, regressor.predict(x), color="Red", linewidth=2 )
    plt.title('Simple Linear Regression')
    plt.xlabel('YearExperience')
    plt.ylabel('Salary')


# Driver code
regression(df[['Salary', 'YearsExperience']]) # 0.957 accuracy
regression(df[['Norm_Salary', 'Norm_YearsExp']]) # 0.957 accuracy
Wir erreichen eine Genauigkeit von 95,7% con scikit-lernen, pero no hay mucho RandMargin ist ein Begriff, der in einer Vielzahl von Zusammenhängen verwendet wird, wie z.B. Buchhaltung, Wirtschaft und Druck. In der Buchhaltung, bezieht sich auf die Differenz zwischen Umsatz und Kosten, die es ermöglicht, die Rentabilität eines Unternehmens zu bewerten. Im Bereich Publishing, Der Rand ist der Leerraum um den Text auf einer Seite, Das macht es gut lesbar und sorgt für eine ästhetische Darstellung. Die korrekte Verwaltung ist unerlässlich.. para comprender la información detallada sobre la relevancia de las características de este modelo. Erstellen wir also ein Modell mit statsmodels.api, statsmodels.formula.api
Lineare Regression mit statsmodel.formula.api (smf)
Prädiktoren in statsmodels.formula.api müssen einzeln aufgelistet werden. Und bei dieser Methode, den Daten wird automatisch eine Konstante hinzugefügt.
def smf_ols(df):
    # defining the independent and dependent features
    x = df.iloc[:, 1:2]
    y = df.iloc[:, 0:1]
#     print(x)
    # train the model
    model = smf.ols('y~x', data=df).fit()
    # print model summary
    print(model.summary())

    # Predict y
    y_pred = model.predict(x)
#     print(type(y), type(y_pred))
#     print(y, y_pred)

    y_lst = y.Salary.values.tolist()
#     y_lst = y.iloc[:, -1:].values.tolist()
    y_pred_lst = y_pred.tolist()

#     print(y_lst)

    data = [y_lst, y_pred_lst]
#     print(data)
    res = pd.DataFrame({'Actuals':data[0], 'Predicted':data[1]})
#     print(res)

    plt.scatter(x=res['Actuals'], y=res['Predicted'])
    plt.ylabel('Predicted')
    plt.xlabel('Actuals')

    res.plot(kind='bar',figsize=(10,6))

# Driver code
smf_ols(df[['Salary', 'YearsExperience']]) # 0.957 accuracy
# smf_ols(df[['Norm_Salary', 'Norm_YearsExp']]) # 0.957 accuracy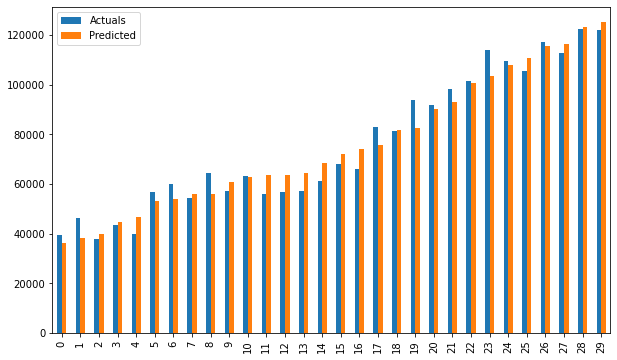
Regression mit statsmodels.api
Es ist nicht mehr notwendig, Prädiktoren einzeln aufzulisten.
statsmodels.regression.linear_model.OLS (sogar, exog)
endogist die abhängige Variableexogist die unabhängige Variable. Ein Abschnitt ist standardmäßig nicht enthalten und muss vom Benutzer hinzugefügt werden (mit add_constant).
# Create a helper function
def OLS_model(df):
    # defining the independent and dependent features
    x = df.iloc[:, 1:2]
    y = df.iloc[:, 0:1]
    # Add a constant term to the predictor
    x = sm.add_constant(x)
#     print(x)
    model = sm.OLS(y, x)
    # Train the model
    results = model.fit()
    # print('n'+"Confidence interval:"+'n', results.conf_int(alpha=0.05, cols=None)) #Returns the confidence interval of the fitted parameters. The default alpha=0.05 returns a 95% confidence interval.
    print('n'"Model parameters:"+'n',results.params)
    # print the overall summary of the model result
    print(results.summary())

# Driver code
OLS_model(df[['Salary', 'YearsExperience']]) # 0.957 accuracy
OLS_model(df[['Norm_Salary', 'Norm_YearsExp']]) # 0.957 accuracy
Wir erreichen eine Genauigkeit von 95,7%, das ist ziemlich gut
¿Qué dice la ZusammenfassungstabelleDas "Zusammenfassungstabelle" ist ein effektives Werkzeug, das Schlüsselinformationen zu einem bestimmten Thema in einem visuellen und zugänglichen Format verdichtet. In verschiedenen Bereichen verwendet, wie Bildung und Forschung, ermöglicht es das Verständnis und die Analyse von Daten. Ihre Struktur ermöglicht es den Nutzern, die wesentlichen Punkte schnell zu erkennen, promoviendo una mejor retención del conocimiento y una comparación más sencilla entre diferentes conceptos o variables.... des Modells? 😕
Es ist immer wichtig, bestimmte Begriffe in der zusammenfassenden Tabelle des Regressionsmodells zu verstehen, damit wir die Leistung unseres Modells und die Relevanz der Eingabevariablen kennen.
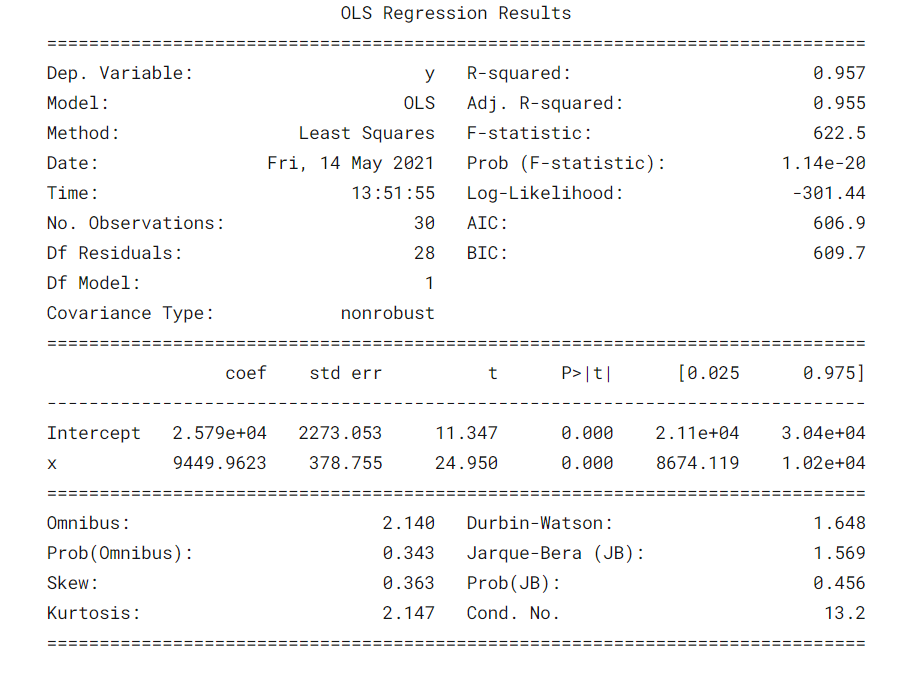
Manche ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... importantes que deben tenerse en cuenta son el valor de R cuadrado, Anpassung. R-Quadrat-Wert, F-Statistik, prob (F-Statistik), Intercept-Koeffizient und Eingabevariablen, P> | T |.
- R-Quadrat ist das Bestimmtheitsmaß. Ein statistisches Maß, das besagt, dass ein Großteil der Datenpunkte auf der Best-Fit-Linie liegt. Ein Wert von R quadriert näher an 1 damit ein Modell gut passt.
- Anpassung. R-squared bestraft den Wert von R-squared, wenn wir ständig neue Funktionen hinzufügen, die nicht zur Vorhersage des Modells beitragen. Si Adj. R quadrierter Wert <R-Quadrat-Wert, ist ein Zeichen dafür, dass wir im Modell irrelevante Prädiktoren haben.
- La estadística F o prueba F nos ayuda a aceptar o rechazar la NullhypotheseDie Nullhypothese ist ein grundlegendes Konzept in der Statistik, das eine anfängliche Aussage über einen Populationsparameter festlegt. Sein Zweck ist es,, falls widerlegt, ermöglicht es uns, die Alternativhypothese zu akzeptieren. Dieser Ansatz ist für die wissenschaftliche Forschung unerlässlich, da sie einen Rahmen für die Bewertung empirischer Evidenz und das Treffen datengestützter Entscheidungen bietet. Seine Formulierung und Analyse sind für statistische Studien von entscheidender Bedeutung..... Vergleichen Sie das Abfangmodell mit unserem Modell mit Funktionen. Die Nullhypothese lautet „alle Regressionskoeffizienten sind gleich Null und das bedeutet, dass beide Modelle gleich sind“. La hipótesis alternativa es ‚interceptar el único modelo es peor que nuestro modelo, was bedeutet, dass unsere hinzugefügten Koeffizienten die Leistung des Modells verbessert haben. Wenn prob (F-Statistik) <0.05 und die F-Statistik ist ein hoher Wert, wir verwerfen die Nullhypothese. Dies bedeutet, dass eine gute Beziehung zwischen den Eingangs- und Ausgangsvariablen besteht.
- coef zeigt die geschätzten Koeffizienten der entsprechenden Eingabemerkmale an
- T-Test spricht über die Beziehung zwischen der Ausgabe und jeder der Eingabevariablen einzeln. Die Nullhypothese lautet ‚el coeficiente de una característica de entrada es 0‘. La hipótesis alternativa es ‚el coeficiente de una característica de entrada no es 0‘. Wenn pWert 0.05.
Gut, jetzt wissen wir, wie man wichtige Schlussfolgerungen aus der Modellzusammenfassungstabelle ziehen kann, Schauen wir uns nun die Parameter unseres Modells an und bewerten unser Modell.
In unserem Fall, der Wert von R zum Quadrat (0,957) ist in der Nähe von Adja. Der Wert von R zum Quadrat (0,955) ist ein gutes Zeichen dafür, dass die Eingabemerkmale zum Prädiktormodell beitragen.
Die F-Statistik ist eine hohe Zahl und p (F-Statistik) ist fast 0, was bedeutet, dass unser Modell besser ist als das Einzelschnittpunktmodell.
Der p-Wert des t-Tests für die Eingangsvariable ist kleiner als 0.05, Es besteht also ein guter Zusammenhang zwischen der Eingangsgröße und der Ausgangsgröße.
Deswegen, Wir schließen mit der Feststellung, dass unser Modell gut funktioniert ✔😊
In diesem Blog, Wir haben die Grundlagen der einfachen linearen Regression gelernt (Spiegelreflexkamera), Erstellen eines linearen Modells mit verschiedenen Python-Bibliotheken und Ziehen von Schlussfolgerungen aus der Übersichtstabelle der OLS-Statistikmodelle.
Verweise:
Interpretieren der Übersichtstabelle aus dem OLS-Statistikmodell
Visualisierungen: Histogramm, Dichtediagramm, Violine Schuss, Box-Plot, Normales QQ-Diagramm, Streudiagramm, Liniendiagramm, Heatmap, gemeinsames Grundstück
Sehen Sie das vollständige Notizbuch von my GitHub Repository.
Ich hoffe, das ist ein informativer Blog für Anfänger. Bitte, Bitte stimmen Sie ab, wenn Sie dies nützlich finden 🙌 Ihre Kommentare sind sehr willkommen. Viel Spaß beim Lernen !! 😎
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





