
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Dieser Artikel wird Ihnen Klarheit darüber verschaffen, was Dimensionsreduktion ist, Ihr Bedarf und wie es funktioniert. Es gibt auch Python-Code zur Veranschaulichung und zum Vergleich zwischen PCA, ICA und t-SNE.
Was ist Dimensionsreduktion und warum brauchen wir i
Die Reduzierung der Dimensionalität reduziert einfach die Anzahl der Funktionen (Säulen) unter Beibehaltung maximaler Informationen. Die folgenden Gründe sind für eine Dimensionsreduzierung:
- Die Reduzierung der Dimensionalität hilft bei der Datenkomprimierung und, Daher, reduziert den Speicherplatz.
- Reduzieren Sie die Berechnungszeit.
- Es hilft auch, redundante Funktionen zu eliminieren, ja gibt es.
- Zugeordnete Funktionen entfernen.
- Durch die Reduzierung der Dimensionen der Daten auf 2D oder 3D können wir sie präzise darstellen und visualisieren. Dann, kann Muster deutlicher sehen.
- Es ist auch nützlich, um Rauschen zu entfernen und, dadurch dass, wir können uns verbessern
Es gibt viele Methoden zur Dimensionsreduktion wie PCA, ICA, t-SN, etc., wir werden PCA sehen (Hauptkomponentenanalyse).
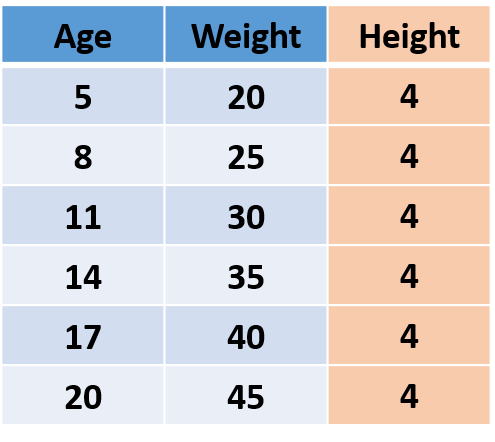
Lass uns zuerst verstehen, was es ist Information in Daten. Betrachten Sie die folgenden imaginären Daten, wer ist alt, Gewicht und Größe der Menschen.
Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... 1
Da die ‚Höhe‘ von allen menschen ist gleich, nämlich, die abweichung ist 0, es werden also keine Informationen hinzugefügt, damit wir die Spalte löschen können ‚Höhe‘ ohne Informationen zu verlieren.
Jetzt, da wir wissen, dass die Information Varianz ist, Lass uns verstehen, wie PCA funktioniert. In PCA, wir finden neue Dimensionen (Merkmale) die die maximale Varianz erfassen (nämlich, Information). Um dies zu verstehen, verwenden wir das vorherige Beispiel. Nach dem Löschen ‚Höhe‘, Wir haben immer noch ‚Alter‘ Ja ‚Gewicht‘. Diese beiden Eigenschaften kümmern sich um alle Informationen. Mit anderen Worten, wir können sagen, wir brauchen 2 Merkmale (Alter und Größe) die Informationen enthalten, und wenn wir ein neues Feature finden, das allein alle Informationen enthalten kann, wir können die Ursprungsmerkmale ersetzen 2 mit einem neuen einzigartigen Feature, Dimensionsreduktion erreichen!
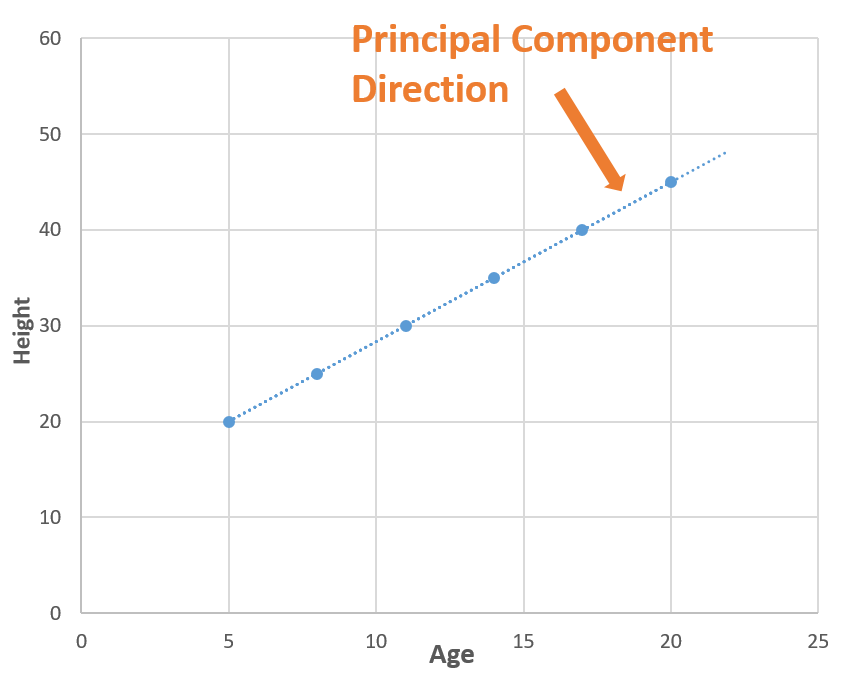
Betrachten Sie nun eine Linie (blaue gestrichelte Linie) was geht durch alle punkte. Die blau gepunktete Linie erfasst alle Informationen, damit wir ersetzen können ‚Alter‘ Ja ‚Gewicht‘ (2 Maße) mit blau gepunkteter Linie (1 Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und...) ohne Informationen zu verlieren, und in diesem w
Du fragst dich, wie wir die blaue gestrichelte Linie gefunden haben (Hauptbestandteil), Da steckt also viel Mathematik dahinter.. Du kannst lesen Dieser Beitrag was erklärt das?, aber in einfachen worten, wir finden die Richtungen, in denen wir können maximale Varianz erfassen unter Verwendung von Eigenwerten und Eigenvektoren.
Darstellung von PCA in Python
Sehen wir uns an einem Beispiel an, wie man PCA verwendet. Ich habe Weinqualitätsdaten verwendet, die 12 Eigenschaften wie Säure, Restzucker, Chloride, etc., und die Qualität des Weines für 1600 Proben. Sie können das Jupyter-Notizbuch herunterladen von hier und folge ihm.
Zuerst, lass uns die daten laden.
numpy als np importieren
Pandas als pd importieren
aus sklearn.decomposition importieren PCA
df = pd.read_csv('weinqualität-rot.csv')
df.kopf()
y = df.pop('qualität')
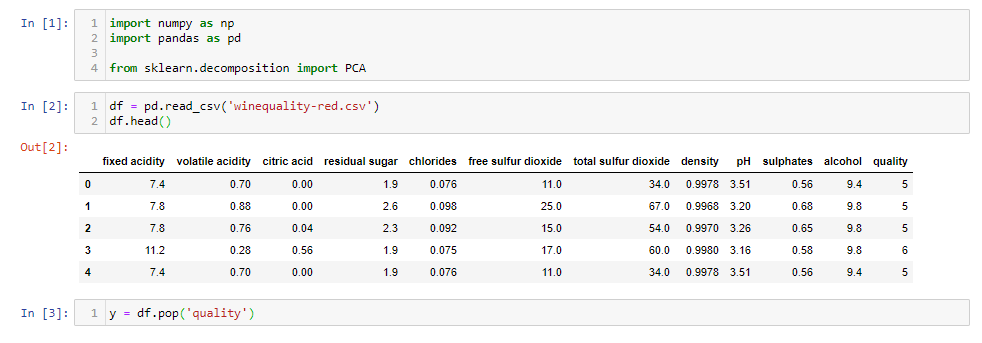
Nach dem Laden der Daten, Wir eliminieren die ‚Qualität‘ Vom Wein, da es das Zielmerkmal ist. Jetzt werden wir die Daten skalieren, denn wenn nicht, PCA wird nicht in der Lage sein, die optimalen Hauptkomponenten zu finden. Für ex. Wir haben ein Feature in ‚Meter‘ und ein weiterer in ‚Kilometer‘, Funktion mit Antrieb ‚Metro‘ wird eine größere Varianz aufweisen als ‚Kilometer‘ (1 km = 1000 m), daher wird PCA dem Merkmal mit hoher Varianz mehr Bedeutung beimessen . Dann, lass uns die Waage machen.
aus sklearn.preprocessing import StandardScaler
Skalar = StandardSkalierer()
df_scaled = pd.DataFrame(skalar.fit_transform(df), Spalten=df.Spalten)
df_skaliert
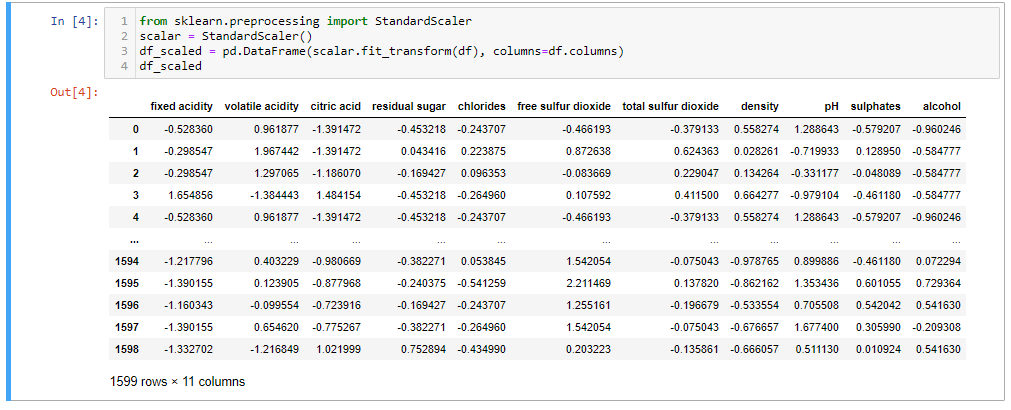
Jetzt wir
PCA = PCA()
df_pca = pd.DataFrame(pca.fit_transform(df_skaliert))
df_pca
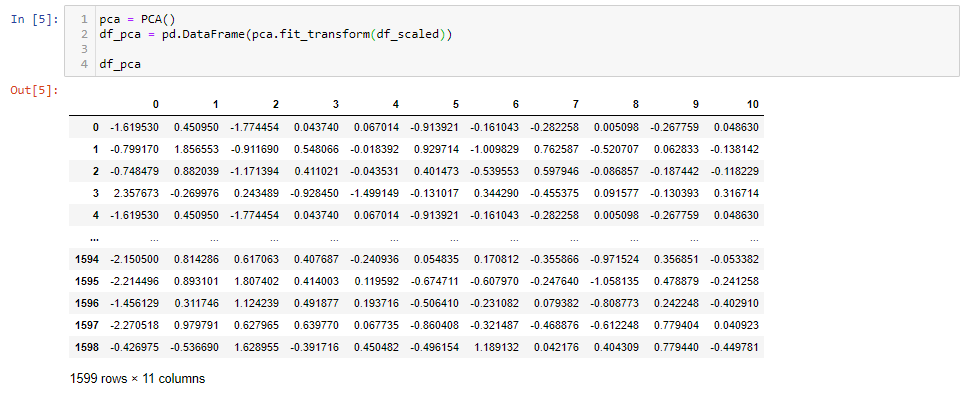
Nach der Anwendung von PCA, wir haben 11 Hauptbestandteile. Es ist interessant zu sehen, wie viel Varianz jede Hauptkomponente erfasst.
import matplotlib.pyplot als plt
pd.DataFrame(pca.explained_variance_ratio_).plot.bar()
plt.legende('')
plt.xlabel('Hauptkomponenten')
plt.ylabel('Erklärte Varianz');
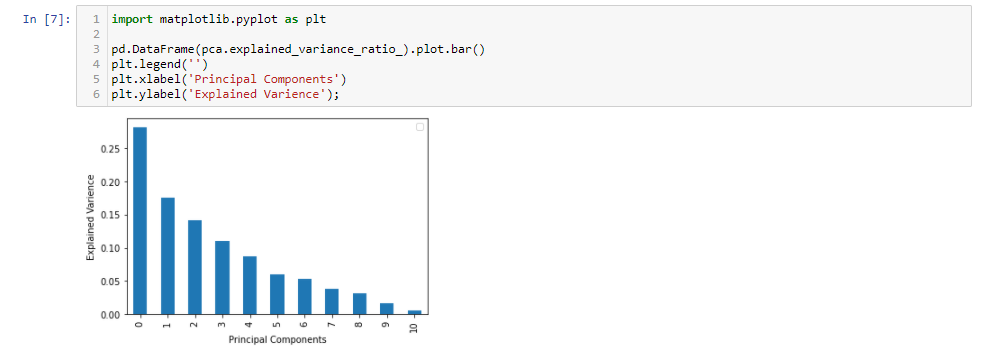
Der erste 5 Hauptkomponenten erfassen um die 80% der Varianz, damit wir die ersetzen können 11 Originalmerkmale (Säure, Restzucker, Chloride, etc.) mit dem neuen 5 Eigenschaften, die die 80% der Informationen. Deswegen, wir haben die reduziert 11 nur Abmessungen 5 Maße, die meisten Informationen behalten.
Unterschied zwischen PCA, ICA und t-SNE
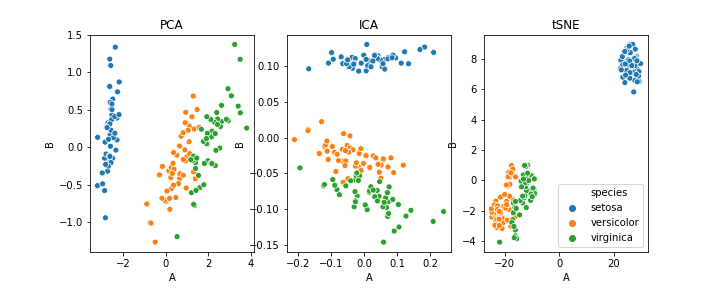
Wie sich dieser Artikel auf die Grundideen der Dimensionsreduktion konzentriert und wie PCA funktioniert, wir gehen nicht ins detail, aber wer Interesse hat, kann vorbeikommen Dieser Beitrag.
Zusammenfassend, PCA reduziert die Dimensionalität und erfasst gleichzeitig den größten Teil der Varianz. Jetzt, würde mich freuen, PCA auf Ihre Daten anzuwenden, aber vorher, Ich möchte einige der Nachteile von PCA hervorheben:
- Unabhängige Variablen werden weniger interpretierbar
- Datenstandardisierung ist ein Muss vor PCA
- Informationsverlust
Ich hoffe, Sie finden diesen Artikel informativ. Vielen Dank!
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





