
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
wie man Menschen durch die Nutzung relevanter Daten und Informationen rehabilitiert.
In diesem Projekt, Lassen Sie uns die Stimmungen aus COVID-19-Tweets vorhersagen. Daten, die von Tweeter und mir gesammelt wurden, werden die Python-Umgebung verwenden, um dieses Projekt zu implementieren.
Problemstellung
Die Herausforderung besteht darin, ein Klassifizierungsmodell zu erstellen, um die Stimmung von Covid-19-Tweets vorherzusagen.. Tweets wurden aus Twitter extrahiert und manuelles Tagging wurde durchgeführt. Wir erhalten Informationen wie Standort, Tutear de, Original-Tweet und Sentimiento.
Ansatz zur Analyse verschiedener Gefühle
vor dem Fortfahren, Es ist nützlich zu wissen, was mit Sentimentanalyse gemeint ist. Die Stimmungsanalyse ist der Prozess der computergestützten Identifizierung und Kategorisierung von Meinungen, die in einem Text ausgedrückt werden, insbesondere um festzustellen, ob die Einstellung des Autors zu einem bestimmten Thema positiv ist, Negativ oder Neutral. (Oxford Wörterbuch)
Im Folgenden finden Sie die Standardverfahren für den Umgang mit dem Projekttyp Sentimentanalyse. Wir werden dieses Verfahren durchlaufen, um vorherzusagen, was wir vorhersagen sollen!!
-
Explorative Datenanalyse.
-
Datenvorverarbeitung.
-
Vektorisierung.
-
Klassifizierungsmodelle.
-
Auswertung.
-
Fazit.
Lass uns ein paar Tweets raten
Ich werde den Tweet lesen und kannst du mir die Stimmung dieses Tweets mitteilen, wenn er positiv ist?, negativ oder neutral? Der erste Tweet ist also „Es erstaunt mich immer noch, wie viele Mitarbeiter im Supermarkt #Toronto ohne Maske arbeiten. Wir alle wissen inzwischen, dass Mitarbeiter bei der Übertragung des #Coronavirus asymptomatisch sein können.. Was vermutest du? Jawohl, Du hast recht. Dies ist ein negativer Tweet, da er negative Wörter enthält wie „Überrascht“.
Wenn Sie den Tweet oben nicht erraten können, mach dir keine Sorgen, Ich habe noch einen Tweet für dich. Lass uns diesen Tweet erraten-"Aufgrund der Covid-19-Situation, wir haben die Nachfrage nach allen Lebensmittelprodukten erhöht. Die Lieferzeit kann bei allen Online-Bestellungen länger sein, vor allem die Tiefkühl- und Beefsharing-Pakete. Wir danken Ihnen für Ihre Geduld in dieser Zeit.". Diesmal hast du absolut Recht, diesen Tweet vorherzusagen, da „Positiv“. Wörter wie „Danke“, „Größere Nachfrage“ sind optimistischer Natur, Diese Worte kategorisierten den Tweet also als positiv.
Datenzusammenfassung
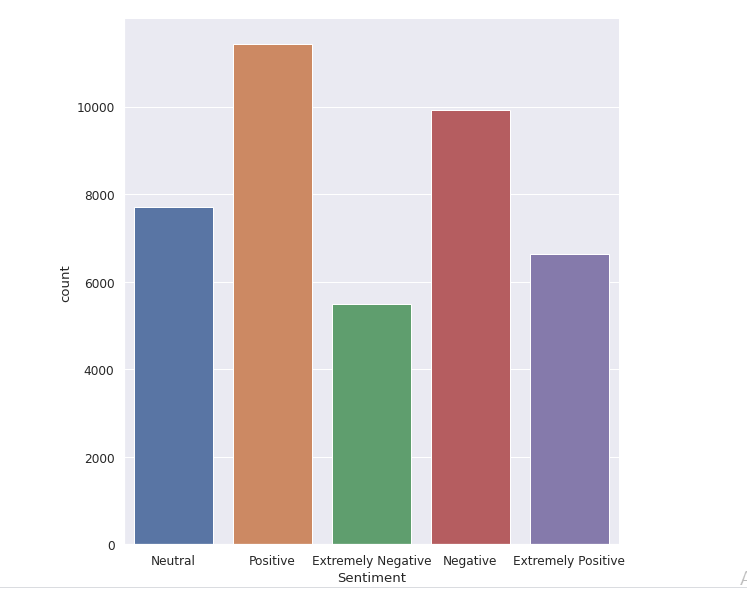
Der Originaldatensatz hat 6 Spalten und 41157 Reihen. Um verschiedene Gefühle zu analysieren, wir brauchen nur zwei Spalten namens Original Tweet und Sentiment. Es gibt fünf Arten von Gefühlen: Extrem negativ, Negativ, neutral, positiv und extrem positiv wie Sie im folgenden Bild sehen können.
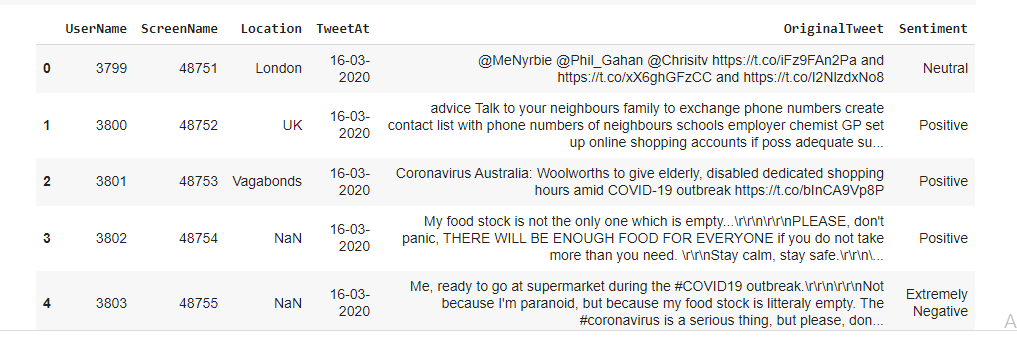
Zusammenfassung des Datensatzes
Grundlegende explorative Datenanalyse
Spalten wie „Nutzername“ Ja „Künstlername„Sie liefern keine wesentlichen Informationen für unsere Analyse. Deswegen, wir verwenden diese Funktionen nicht für den Modellbau. Alle gesammelten Tweet-Daten für die Monate März und April 2020. Das folgende Balkendiagramm zeigt uns die Anzahl der eindeutigen Werte in jeder Spalte.
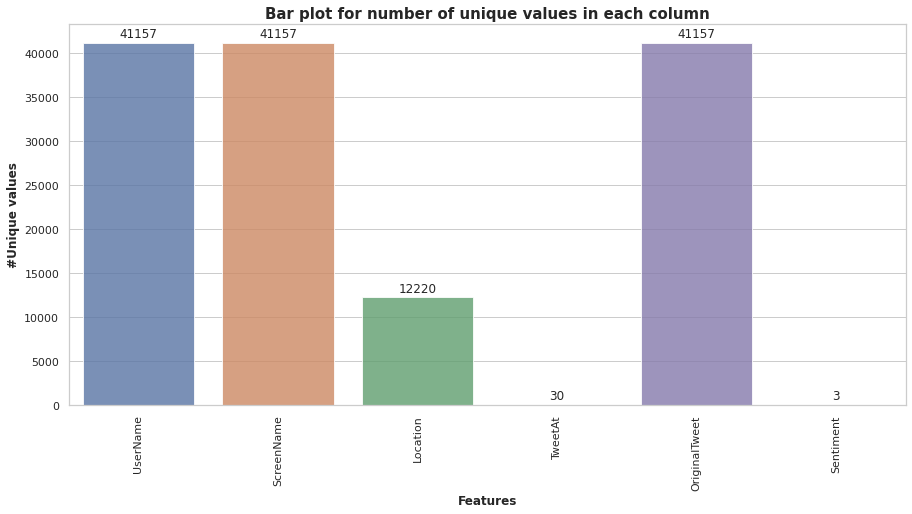
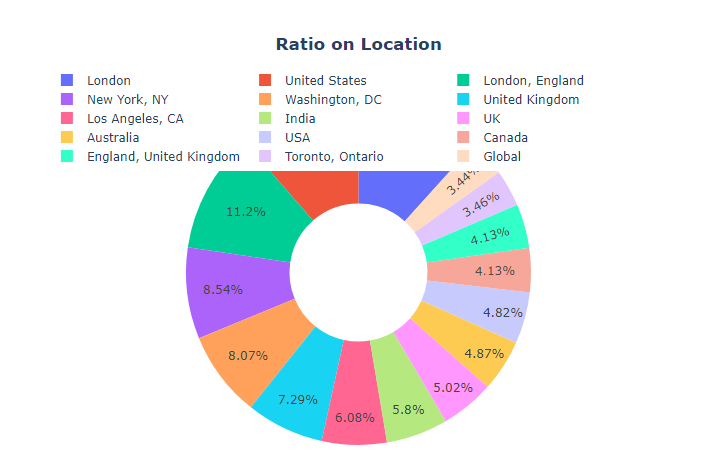
Es gibt einige Nullwerte in der Standortspalte, aber wir müssen uns nicht um sie kümmern, da wir nur zwei Spalten verwenden werden, nämlich, „Gefühl“ Ja „Tweet original”. Die meisten Tweets kamen vom Standort London (11,7%), wie aus dem Folgenden hervorgeht Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.....
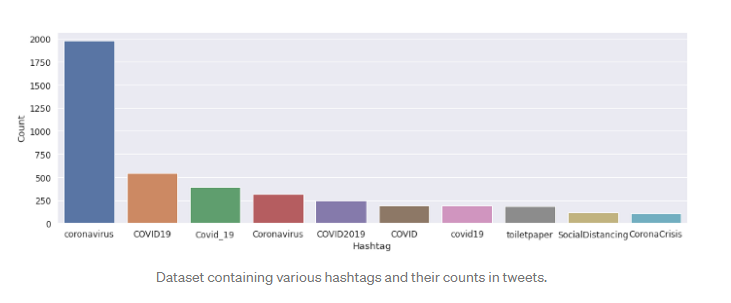
Es gibt einige Wörter wie ‚Coronavirus‘, ‚Lebensmittelgeschäft‘, die die maximale Häufigkeit in unserem Datensatz haben. Wir können es in der folgenden Wortwolke sehen. Es gibt mehrere #Hashtags in der Tweet-Spalte. Aber sie sind in allen Gefühlen fast gleich, Sie liefern uns also keine vollständigen und aussagekräftigen Informationen.
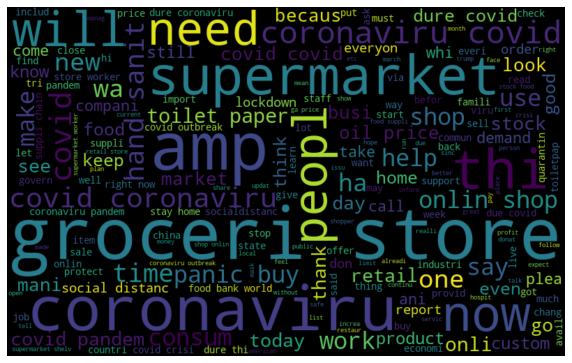
World Cloud zeigt die Wörter mit einer maximalen Häufigkeit in unserer Tweet-Spalte
Wenn wir versuchen, die Spalte zu erkunden ‚Gefühl‘, Wir haben festgestellt, dass die meisten Menschen zu verschiedenen Themen positive Gefühle haben, was zeigt uns deinen Optimismus in Zeiten der Pandemie. Sehr wenige Menschen haben extrem negative Gedanken über Covid-19.
Datenvorverarbeitung
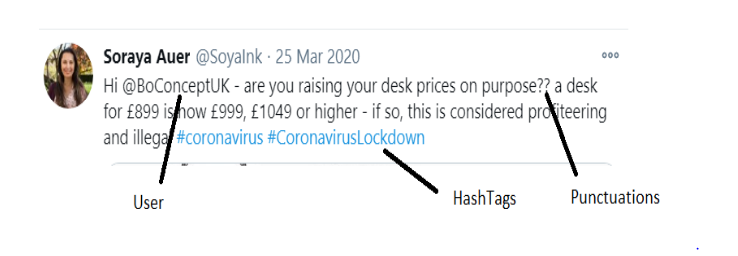
Die Vorverarbeitung von Textdaten ist ein wesentlicher Schritt, da es den Klartext für das Mining bereit macht. Das Ziel dieses Schritts ist es, die weniger relevanten Geräusche zu bereinigen, um die Stimmung von Tweets wie . zu finden Interpunktion(.,?, "Etc.), spezielle Charaktere(@,%, &, $, etc.), Zahlen(1,2,3, etc.), Mango der Hochtöner, Links(HTTPS: / HTTP:) und Begriffe, die im Kontext des Textes nicht viel Gewicht haben.
Was ist mehr, Wir müssen leere Wörter aus Tweets entfernen. Stoppwörter sind Wörter in natürlicher Sprache, die sehr wenig Bedeutung haben., Was „es ist“, „ein“, „das“, etc. Stoppwörter aus einem Satz entfernen, Sie können den Text in Wörter aufteilen und dann das Wort löschen, wenn es in der von NLTK bereitgestellten Stoppwortliste vorhanden ist.
Später, wir müssen Tweets mit Stemming oder Lemmatization normalisieren. „Stemming „ist ein regelbasierter Prozess zum Entfernen von Suffixen“ („ing“," ly "," es ist "," ed "," S ", etc.) eines Wortes. Zum Beispiel, „abspielen“, „Spieler“, „gespielt“, „abspielen“ Ja „abspielen“ sind die verschiedenen Variationen des Wortes – „abspielen“.
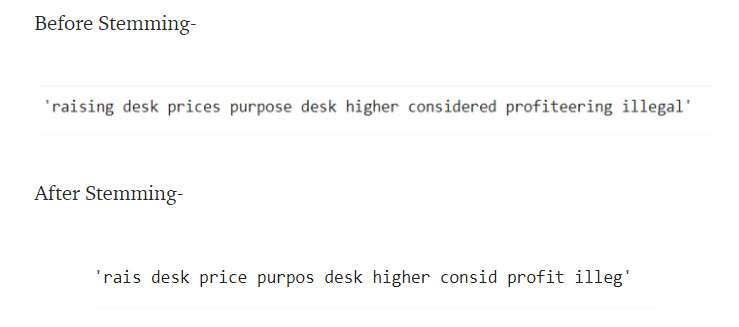
Die Ableitung wandelt die ursprünglichen Wörter nicht in bedeutungsvolle Wörter um. Wie du siehst, „betrachtet“ ist abgeleitet in „Zustand“, was keine Bedeutung hat und auch ein Rechtschreibfehler ist. Der beste Weg ist die Verwendung von Stemming anstelle des Ableitungsprozesses.
Stemming ist eine leistungsfähigere Operation und berücksichtigt die morphologische Analyse von Wörtern. Gibt das Motto zurück, das ist die Grundform all seiner Flexionsformen.
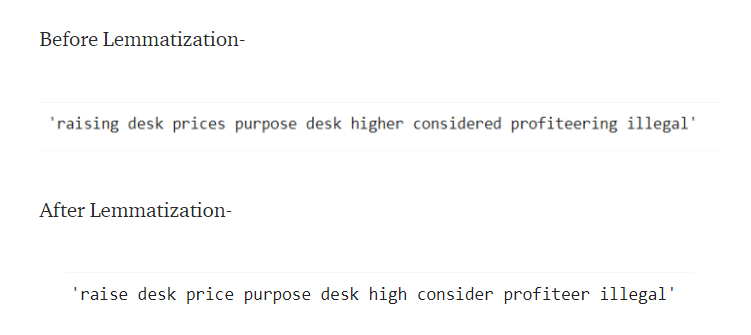
Hier, im Lemmatisierungsprozess, Wir drehen das Wort „hochheben“ zu seiner Grundform „hochheben“. Wir müssen auch alle Tweets in Kleinbuchstaben umwandeln, bevor wir den Prozess durchführen StandardisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.....
Wir können den Tokenisierungsprozess einbeziehen. In Tokenisierung, wir wandeln eine Gruppe von Sätzen in Token um. Es wird auch genannt SegmentierungDie Segmentierung ist eine wichtige Marketingtechnik, bei der ein breiter Markt in kleinere, homogenere Gruppen unterteilt wird. Diese Praxis ermöglicht es Unternehmen, ihre Strategien und Botschaften an die spezifischen Merkmale jedes Segments anzupassen, So verbessern Sie die Effektivität Ihrer Kampagnen. Das Targeting kann auf demografischen Kriterien basieren, psychografisch, geografisch oder verhaltensbezogen, Erleichterung einer relevanteren und persönlicheren Kommunikation mit der Zielgruppe.... Text- oder Lexikanalyse. Grundsätzlich, es geht darum, die Daten in eine kleine Anzahl von Wörtern aufzuteilen. Tokenisierung in Python kann von Python durchgeführt werden NLTK word_tokenize-Funktion () aus der Bibliothek.
Vektorisierung
Wir können einen Zählvektorisierer oder einen TF-IDF-Vektorisierer verwenden. Count Vectorizer erstellt ein spärliches Array aller Wörter und der Häufigkeit, mit der sie in einem Dokument vorkommen.
TFIDF, kurz für inverser Frequenz-Frequenz-Term des Dokuments, ist eine numerische Statistik, die versucht, die Bedeutung eines Wortes für ein Dokument in einer Sammlung oder einem Korpus widerzuspiegeln. Der TF - IDF-Wert erhöht sich proportional zur Häufigkeit, mit der ein Wort im Dokument vorkommt, und wird durch die Anzahl der Dokumente im Korpus ausgeglichen, die das Wort enthalten, was hilft, die Tatsache auszugleichen, dass einige Wörter im Allgemeinen häufiger vorkommen. (Wiki)
Gebäudeklassifizierungsmodelle
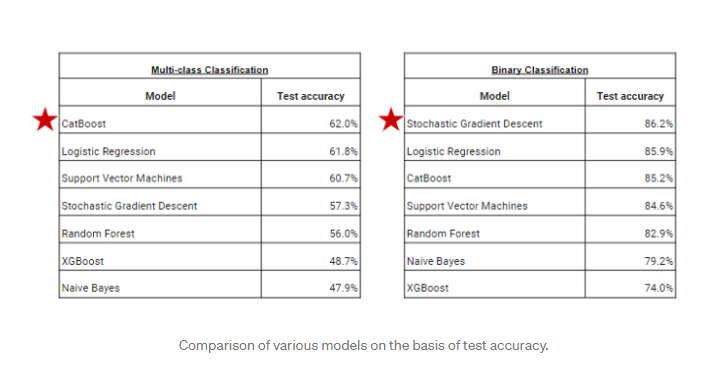
Das gegebene Problem ist die Mehrklassen-Ordinalklassifikation. Es gibt fünf Arten von Gefühlen, also müssen wir unsere Modelle trainieren, damit sie uns das richtige Label für den Testdatensatz geben können. Ich werde verschiedene Modelle bauen wie Bayes ingenuo, Logistische Regression, zufälliger Wald, XGBoost, Support-Vektor-Maschinen, CatBoost und Abstieg von SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... stochastisch.
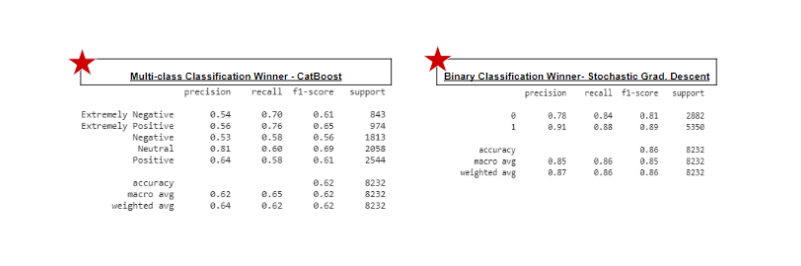
Ich habe das gegebene Problem der Mehrklassenklassifikation verwendet, das eine VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... abhängige Variable hat, die die Werte -Positiv besitzt, Extrem positiv, Neutral, Negativ, Extrem negativ. Ich wandele dieses Problem auch in eine binäre Klassifikation um, nämlich, Ich habe alle Tweets nur in zwei Typen Positiv und Negativ eingeteilt. Sie können sich auch für die Drei-Klassen-Klassifizierung entscheiden, nämlich, Positiv, Negativ und Neutral für mehr Präzision. In der Evaluierungsphase, Wir werden die Ergebnisse dieser Algorithmen vergleichen.
Bedeutung der Funktion
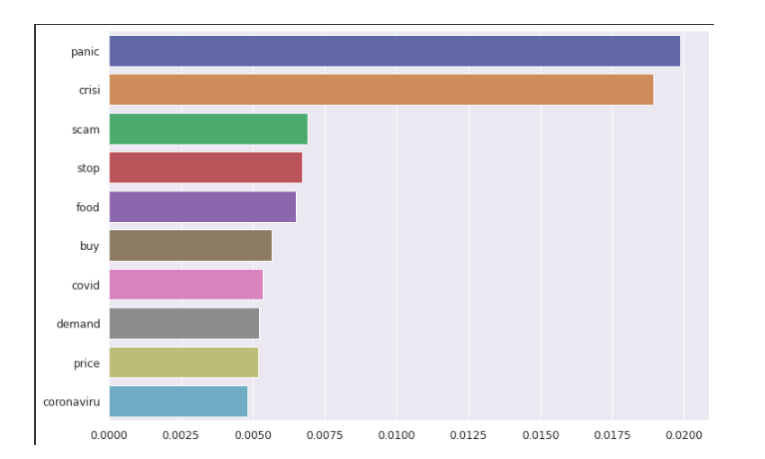
das Merkmal Bedeutung (Variable Bedeutung) beschreiben welche Merkmale ist relevant. Es kann helfen, das gelöste Problem besser zu verstehen und, manchmal, zu Modellverbesserungen durch den Einsatz von charakteristisch Auswahl. Die drei am häufigsten hervorgehobenen Wörter sind Panik, Krise und Betrug, wie wir in der folgenden Grafik sehen können.
Fazit
Diesen Weg, wir können aus verschiedenen Tweets und Textdaten weiter nachforschen. Unsere Modelle werden versuchen, die verschiedenen Gefühle richtig vorherzusagen. Ich habe verschiedene Modelle verwendet, um unseren Datensatz zu trainieren, aber einige Modelle zeigen eine höhere Genauigkeit, während andere dies nicht tun. Für Mehrklassenklassifizierung, das beste Modell für diesen Datensatz wäre CatBoost. Für binäre Klassifikation, das beste Modell für diesen Datensatz wäre der Stochastische Gradientenabstieg.
(Sie können über diesen Link auf den Python-Code dieses Projekts zugreifen-https://github.com/rajeshmore1/Capstone-Project-2 )
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





