
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Nach Meinung von Experten, das 80% der weltweiten Daten liegen in Form von unstrukturierten Daten vor (Bilder, Videos, Text, etc.). Diese Daten könnten durch Tweets generiert werden / Social-Media-Beiträge, Anrufprotokolle, Umfrage- oder Interviewbewertungen, Textnachrichten in Blogs, Foren, Nachrichten, etc.
Es ist menschlich unmöglich, den ganzen Text im Web zu lesen und Muster zu finden. Aber trotzdem, Es ist definitiv erforderlich, dass das Unternehmen diese Daten analysiert, um bessere Maßnahmen zu ergreifen.
Einer dieser Prozesse zur Gewinnung von Wissen aus Textdaten ist die Sentimentanalyse. Um die Daten für die Stimmungsanalyse zu erhalten, man kann Inhalte von Webseiten mit verschiedenen Web-Scraping-Techniken direkt abkratzen.
Wenn Sie neu im Web-Scraping sind, Zögern Sie nicht, meinen Artikel zu konsultieren „Web-Scraping mit Python: SchöneSuppe“.
Was ist Sentimentanalyse?
Stimmungsanalyse (auch bekannt als Opinion Mining oder Emotion AI) ist ein Teilbereich des NLP, der die Meinungsneigung der Menschen misst (positiv / Negativ / neutral) in unstrukturiertem Text.
Die Stimmungsanalyse kann mit zwei Ansätzen durchgeführt werden: regelbasiert, basierend auf maschinellem Lernen.
Einige Anwendungen der Stimmungsanalyse
- Marktanalyse
- Social-Media-Monitoring
- Analyse von Kundenfeedback: Analyse der Markenmeinung oder Reputation
- Marktforschung
Was ist natürliche Sprachverarbeitung? (PNL)?
Natürliche Sprache ist unser Weg, die Menschen, wir kommunizieren miteinander. Es kann Stimme oder Text sein. NLP ist die automatische Manipulation natürlicher Sprache durch Software. NLP ist ein Begriff auf höherer Ebene und ist die Kombination von Natürliches Sprachverständnis (NLU) Ja Natürliche Sprachgenerierung (NLG).
PNL = NLU + NLG
Einige von Pythons Bibliotheken zur Verarbeitung natürlicher Sprache (NLP) Sohn:
- Toolkit für natürliche Sprache (NLTK)
- TextBlob
- PLATZ
- Gensim
- CoreNLP
Ich hoffe, wir haben ein grundlegendes Verständnis der Begriffe Stimmungsanalyse, PNL.
Dieser Artikel konzentriert sich auf den regelbasierten Ansatz der Sentiment-Analyse..
Regelbasierter Ansatz
Dies ist ein praktischer Ansatz zur Textanalyse ohne Schulung oder mit maschinellen Lernmodellen. Das Ergebnis dieses Ansatzes ist ein Regelwerk, auf dessen Grundlage Text als positiv gekennzeichnet wird. / Negativ / neutral. Diese Regeln werden auch als Lexika bezeichnet. Deswegen, der regelbasierte Ansatz wird als lexikalischer Ansatz bezeichnet.
Die weit verbreiteten lexikalischen Ansätze sind TextBlob, VADER, SentiWordNet.
Schritte zur Datenvorverarbeitung:
- Text aufräumen
- Tokenización
- Anreicherung: POS-Kennzeichnung
- Entfernen von Rauschwörtern
- Holen Sie sich die Wurzelwörter
Bevor Sie sich mit den obigen Schritten befassen, Lassen Sie mich die Textdaten aus einer TXT-Datei importieren.
Importieren Sie eine Textdatei mit Pandas lesen CSV Funktion
# Pandas-Bibliothek installieren und importieren
Pandas als pd importieren
# Erstellen eines Pandas-Datenrahmens aus der Datei reviews.txt
data = pd.read_csv('reviews.txt', sep='t')
daten.kopf()
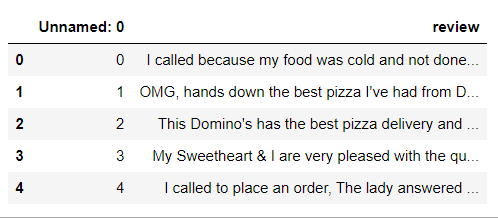
Das sieht nicht gut aus. Dann, jetzt veröffentlichen wir die „Namenlos: 0 " Spalte mit der df.drop Funktion.
mydata = data.drop('Unnamed': 0', Achse=1)
mydata.head()
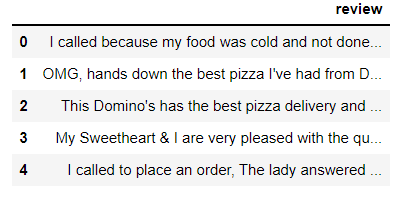
Unser Datensatz hat insgesamt 240 Beobachtungen (Bewertungen).
Paso 1: Bereinige den Text
In diesem Schritt, wir müssen die Sonderzeichen entfernen, Textnummern. Wir können die nutzen Operationen mit regulären Ausdrücken Python-Bibliothek.
# Definieren Sie eine Funktion zum Bereinigen des Textes
auf jeden Fall sauber(Text):
# Entfernt alle Sonderzeichen und Zahlen, die die Alphabete verlassen
    text = re.sub('[^ A-Za-z]+', 'Review', Text)
    Rückgabetext

# Bereinigen des Textes in der Rezensionsspalte
meine Daten['Cleaned Reviews'] = meine Daten['bewertung'].anwenden(sauber)
mydata.head()
Erläuterung: "Clean" ist die Funktion, die Text als Eingabe akzeptiert und ohne Satzzeichen oder Zahlen zurückgibt. Lo aplicamos a la columna ‚Revision‘ y creamos una nueva columna ‚Revisiones limpias‘ mit sauberem Text.
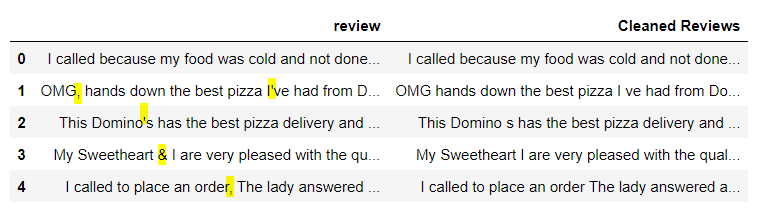
Genial, schau dir das bild oben an, alle Sonderzeichen und Zahlen werden entfernt.
Paso 2: Tokenización
Tokenisierung ist der Prozess, bei dem Text in kleinere Teile, sogenannte Tokens, unterteilt wird. Kann auf Satzebene erfolgen (Satztokenisierung) oder per Wort (Wort-Tokenisierung).
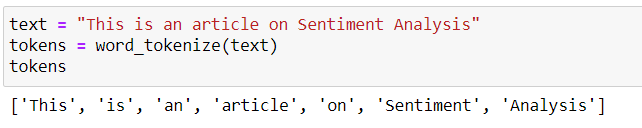
Ich werde die Tokenisierung auf Wortebene mit durchführen Tokenizar nltk word_tokenize-Funktion ().
Notiz: Da unsere Textdaten etwas groß sind, Ich werde die Schritte zuerst illustrieren 2-5 mit kleinen Beispielsätzen.
Sag, wir haben ein Gebet „Dies ist ein Artikel zur Sentimentanalyse.“. Kann in kleine Stücke geteilt werden (Aufzeichnungen) wie im Folgenden gezeigt.
Paso 3: Anreicherung: POS-Etikettierung
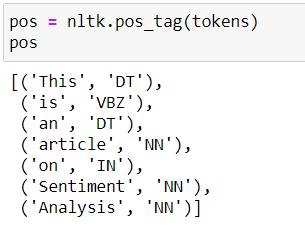
Beschriften von Wortarten (POS) ist ein Prozess der Umwandlung jedes Tokens in ein Tupel mit der Form (Wort, Etikett). POS-Tagging ist wichtig, um den Kontext des Wortes zu bewahren und ist für die Wortstammerkennung wichtig.
Dies kann mit nltk . erreicht werden pos_tag Funktion.
Unten sind die POS-Tags des Beispielsatzes „Dies ist ein Artikel über Meinungsanalyse“.
Siehe die Liste der möglichen Pos de Labels. hier.
Paso 4: Entfernen von Rauschwörtern
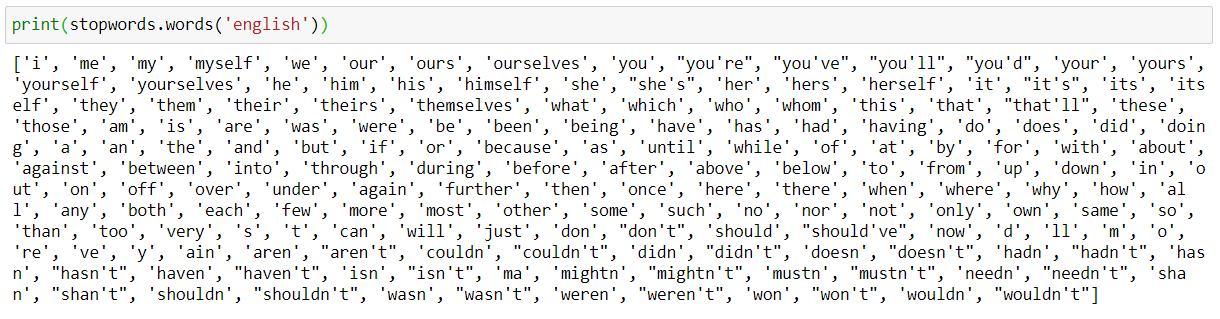
Englische Stoppwörter sind Wörter, die sehr wenig nützliche Informationen enthalten. Wir müssen sie im Rahmen der Textvorverarbeitung entfernen. nltk hat eine Stoppwortliste für jede Sprache.
Siehe englische Stoppwörter.
Beispiel für die Entfernung von Stoppwörtern:
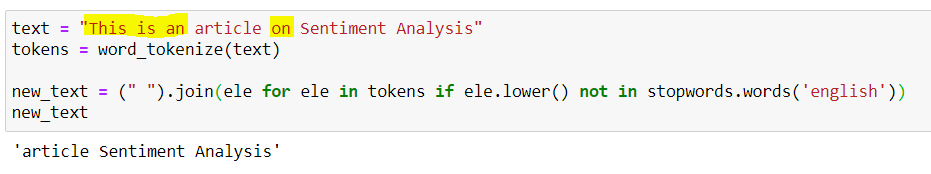
Die leeren Worte Dies, ist, ein, on se eliminan y la oración de salida es ‚Análisis de opinión del artículo‘.
Paso 5: Holen Sie sich die Wurzelwörter
Eine Wurzel ist ein Teil eines Wortes, das für seine lexikalische Bedeutung verantwortlich ist. Die zwei beliebten Techniken, um die Wurzelwörter zu erhalten / root sind Stemming und Lemmatization.
Der Hauptunterschied besteht darin, dass Stemming oft einige unsinnige Wurzelwörter enthält, da es am Ende nur einige Zeichen schneidet. Stammen bietet sinnvolle Wurzeln, aber trotzdem, erfordert POS-Tags der Wörter.
Beispiel zur Veranschaulichung des Unterschieds zwischen Stemming und Lematization: Klicken Sie hier, um den Code zu erhalten
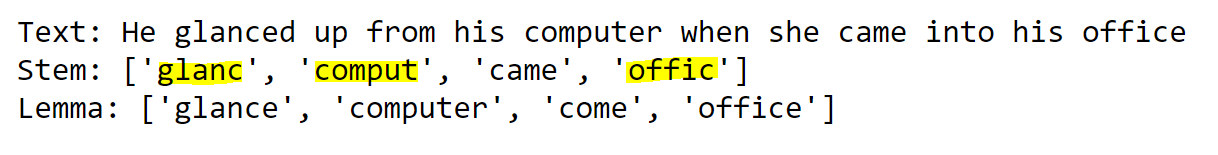
Wenn wir uns das vorherige Beispiel ansehen, Die Ausgabe von Stemming ist Stem und die Ausgabe von Lemmatizatin ist Lemma.
Bei dem Wort schau, Der Stamm Blick Hat keinen Sinn. Bedenkt, dass, das Motto aussehen es ist perfekt.
Jetzt haben wir die Schritte verstanden 2-5 einfache Beispiele nehmen. Ohne weitere Verzögerung, Kommen wir zurück zu unserem eigentlichen Problem.
Code für Schritte 2 ein 4: tokenización, POS-Etikettierung, Entfernen von Rauschwörtern
nltk importieren
nltk.download('punkt')
aus nltk.tokenize import word_tokenize
aus nltk importieren pos_tag
nltk.download('Stoppwörter')
aus nltk.corpus importieren Stoppwörter
nltk.download('wordnet')
von nltk.corpus import wordnet

# POS-Tagger-Wörterbuch
pos_dict = {'J':wordnet.ADJ, 'V':wordnet.VERB, 'N':wordnet.NOUN, 'R':wordnet.ADV}
def token_stop_pos(Text):
    tags = pos_tag(word_tokenize(Text))
    neue Liste = []
    für Wort, Tag in Tags:
        wenn word.lower() nicht im Set(Stoppwörter.Wörter('english')):
        neueliste.anhängen(Tupel([Wort, pos_dict.get(Schild[0])]))
    Neue Liste zurückgeben

meine Daten['POS tagged'] = meine Daten['Cleaned Reviews'].anwenden(token_stop_pos)
mydata.head()
Erläuterung: token_stop_pos ist die Funktion, die den Text nimmt und die Tokenisierung durchführt, Entfernen Sie Stoppwörter und markieren Sie die Wörter in Ihrem POS. Lo aplicamos a la columna ‚Reseñas limpias‘ y creamos una nueva columna para los datos de ‚POS etiquetados‘.
Wie bereits erwähnt, um das genaue Motto zu bekommen, WordNetLemmatizer requiere etiquetas POS en forma de ‚n‘, ‚ein‘, etc. Pero las etiquetas POS obtenidas de pos_tag tienen la forma ‚NN‘, ‚ANPASSEN‘, etc.
So weisen Sie Wordnet-Tags pos_tag zu, wir erstellen ein pos_dict-Wörterbuch. Jedes pos_tag, das mit J beginnt, wird auf wordnet.ADJ . abgebildet, Jedes pos_tag, das mit R beginnt, wird auf wordnet.ADV abgebildet, usw.
Unsere Interessen-Tags sind Nomen, Adjektiv, Adverb, Verb. Alles von diesen vier wird None zugewiesen.
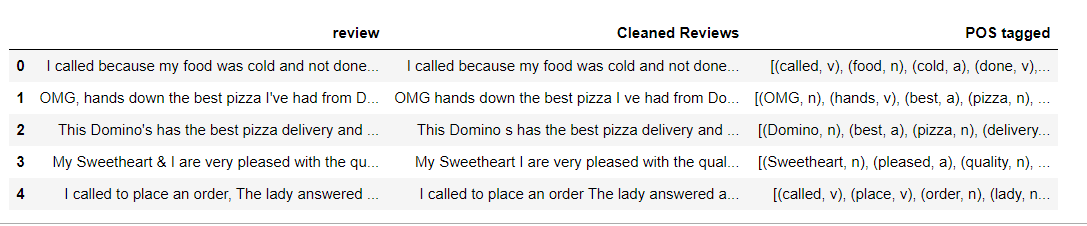
Im Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... anterior, podemos observar que cada palabra de la columna ‚Etikettieren von POS‘ Karten zu Ihrem POS von pos_dict.
Code für Schritt 5: Holen Sie sich die Wurzelwörter – Lematización
aus nltk.stem importieren WordNetLemmatizer
wordnet_lemmatizer = WordNetLemmatizer()
def lemmatisieren(pos_daten):
    lemma_rew = " "
    für Wort, pos in pos_data:
    wenn nicht pos:
        Lemma = Wort
        lemma_rew = lemma_rew + " " + Lemma
    anders:
        lemma = wordnet_lemmatizer.lemmatize(Wort, pos = pos)
        lemma_rew = lemma_rew + " " + Lemma
    zurück lemma_rew

meine Daten['Lemma'] = meine Daten['POS tagged'].anwenden(lemmatisieren)
mydata.head()
Erläuterung: lemmatize ist eine Funktion, die pos_tag-Tupel nimmt und das Lemma für jedes angibt Wort in pos_tag basierend auf dem Pos dieses Wortes. Lo aplicamos a la columna ‚Etikettieren von POS‘ y creamos una columna ‚Lema‘ um die Ausgabe zu speichern.
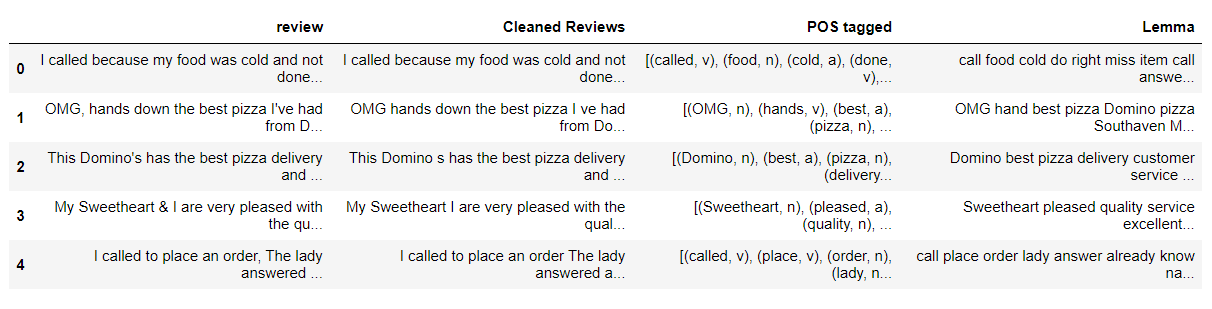
Jawohl, nach einer langen Reise, wir sind mit der Vorverarbeitung des Textes fertig.
Jetzt, tómese un minuto para mirar las columnas ‚Revision‘, ‚Lema‘ und beobachte, wie der Text verarbeitet wird.
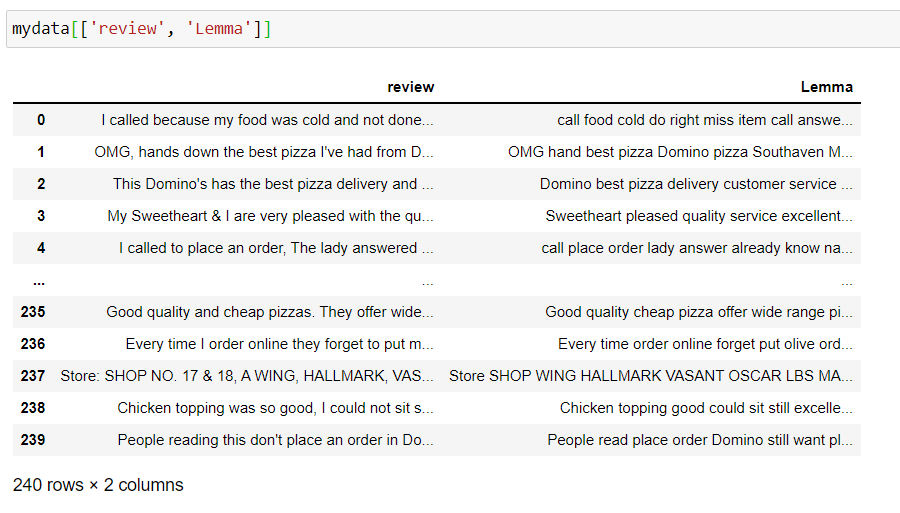
Wenn wir mit der Datenvorverarbeitung fertig sind, unsere endgültigen Daten sehen sauber aus. Machen Sie eine kurze Pause und kommen Sie zurück, um die eigentliche Aufgabe fortzusetzen.
Stimmungsanalyse mit TextBlob:
TextBlob ist eine Python-Bibliothek zur Verarbeitung von Textdaten. Bietet eine konsistente API, um in gängige Aufgaben der Verarbeitung natürlicher Sprache einzutauchen (NLP), wie das Markieren von Wortarten, Extraktion von Nominalphrasen, Stimmungsanalyse und mehr.
Die beiden zur Analyse der Stimmung verwendeten Messgrößen sind:
- Polarität: spricht darüber, wie positiv oder negativ die Meinung ist.
- Subjektivität: Sprechen Sie darüber, wie subjektiv die Meinung ist.
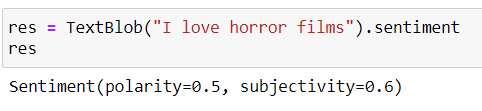
TextBlob (Text) .Sentiment gibt uns die Polaritätswerte, Subjektivität.
Polarität variiert von -1 ein 1 (1 ist positiver, 0 ist neutral, -1 ist eher negativ)
Subjektivität variiert von 0 ein 1 (0 es ist sehr objektiv und 1 sehr subjektiv)
Python-Code:
aus Textblob importieren TextBlob
# Funktion zur Berechnung der Subjektivität
def getSubjektivität(Rezension):
    TextBlob zurückgeben(Rezension).Sentiment.Subjektivität
    # Funktion zur Berechnung der Polarität
    def getPolarity(Rezension):
        TextBlob zurückgeben(Rezension).sentiment.polarität

# Funktion zum Analysieren der Bewertungen
Def-Analyse(Spielstand):
    wenn punktzahl < 0:
        return 'Negative'
    elif score == 0:
        return 'Neutral'
    else:
        return 'Positive'
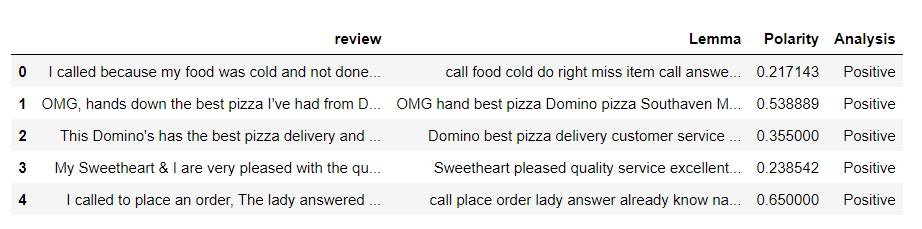
Erläuterung: Funktionen, die erstellt wurden, um Polaritätswerte zu erhalten, Subjektivität und beschriften Sie die Bewertung basierend auf dem Polaritäts-Score.
Erstellen Sie einen neuen Datenrahmen mit der Revision, Lemma-Spalten und wenden Sie die oben genannten Funktionen an
fin_data = pd.DataFrame(meine Daten[['bewertung', 'Lemma']])
# fin_data['Subjectivity'] = fin_data['Lemma'].anwenden(getSubjektivität)
fin_data['Polarity'] = fin_data['Lemma'].anwenden(getPolarität)
fin_data['Analysis'] = fin_data['Polarity'].anwenden(Analyse)
fin_data.head()
Zählen Sie die Anzahl der positiven Bewertungen, negativ und neutral.
tb_counts = fin_data.Analysis.value_counts()

tb_counts
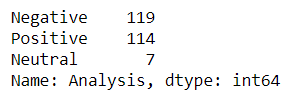
Stimmungsanalyse mit VADER
VADER steht für Valence Aware Dictionary und Sentiment Reasoner. Vaders Stimmung sagt nicht nur, ob die Aussage positiv oder negativ ist, zusammen mit der Intensität der Emotion.
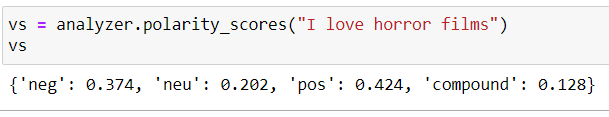
Die Summe der Intensitäten pos, negativ, neu da 1. Die Verbindung variiert von -1 ein 1 y ist die Metrik, die verwendet wird, um die Gesamtstimmung zu zeichnen.
positiv, wenn zusammengesetzt> = 0.5
neutral ja -0,5 <Verbindung <0,5
negativ ja -0,5> = Verbindung
Python-Code:
from VaderSentiment.vaderSentiment import SentimentIntensityAnalyzer
Analyzer = SentimentIntensityAnalyzer()
# Funktion zur Berechnung der Vaterstimmung
Def Vater Stimmungsanalyse(Rezension):
    vs = Analyzer.polarity_scores(Rezension)
    zurück vs['Compound']
    fin_data['Vader Sentiment'] = fin_data['Lemma'].anwenden(Vaterstimmungsanalyse)
# Funktion zu analysieren
def vader_analyse(Verbindung):
    wenn zusammengesetzt >= 0.5:
        return 'Positive'
    elif compound <= -0.5 :
        return 'Negative'
    else:
        return 'Neutral'
fin_data['Vader Analysis'] = fin_data['Vader Sentiment'].anwenden(vader_analyse)
fin_data.head()
Erläuterung: Funktionen, die entwickelt wurden, um Vader-Scores und Tag-Reviews basierend auf zusammengesetzten Scores zu erhalten
Zählen Sie die Anzahl der positiven Bewertungen, negativ und neutral.
Father_counts = fin_data['Vader Analysis'].value_counts()
vader_counts
Stimmungsanalyse mit SentiWordNet
SentiWordNet verwendet die DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... WordNet. Es ist wichtig, den POS zu bekommen, Motto jedes Wortes. Dann werden wir das Motto verwenden, POS, um die Synonymsätze zu erhalten (synsets). Dann, wir erhalten die objektiven Scores, negativ und positiv für alle möglichen Synthesizer oder den ersten Synthesizer und wir beschriften den Text.
ja positive Bewertung> negative Punktzahl, das gefühl ist positiv
ja positive Bewertung <negative Punktzahl, das gefühl ist negativ
wenn positiver Wert = negativer Wert, das gefühl ist neutral
Python-Code:
nltk.download('sentiwordnet')
von nltk.corpus importiere sentiwordnet als swn
def Sentiwordnetanalyse(pos_daten):
    Stimmung = 0
    tokens_count = 0
    für Wort, pos in pos_data:
        wenn nicht pos:
            fortsetzen
            lemma = wordnet_lemmatizer.lemmatize(Wort, pos = pos)
        wenn nicht lemma:
            fortsetzen
            synsets = wordnet.synsets(Lemma, pos = pos)
        wenn nicht synsets:
            fortsetzen
            # Nimm den ersten Sinn, das Üblichste
            synset = synsets[0]
            noise_synset = noise.senti_synset(synset.name())
            Stimmung += swn_synset.pos_score() - swn_synset.neg_score()
            tokens_count += 1
            # drucken(swn_synset.pos_score(),swn_synset.neg_score(),swn_synset.obj_score())
        wenn nicht tokens_count:
            Rückkehr 0
        wenn Gefühl>0:
            Rückkehr "Positiv"
        wenn Stimmung==0:
            Rückkehr "Neutral"
        anders:
            Rückkehr "Negativ"

fin_data['SWN analysis'] = meine Daten['POS tagged'].anwenden(Sentiwordnetanalyse)
fin_data.head()
Erläuterung: Wir erstellen eine Funktion, um die positiven und negativen Werte für das erste Wort des Synsets zu erhalten und dann den Text zu beschriften, indem wir die Stimmung als Differenz von positiven und negativen Werten berechnen.
Zählen Sie die Anzahl der positiven Bewertungen, negativ und neutral.
swn_counts=fin_data['SWN analysis'].value_counts()
swn_counts
Bis zu diesem Punkt, Wir haben die Implementierung von Sentiment-Analysen mit einigen der beliebten lexikonbasierten Techniken gesehen. Jetzt schnell eine Visualisierung erstellen und die Ergebnisse vergleichen.
Visuelle Darstellung der TextBlob-Ergebnisse, VADER, SentiWordNet
Wir werden die Anzahl der positiven Bewertungen nachverfolgen, negativ und neutral für die drei Techniken.
import matplotlib.pyplot als plt
%matplotlib inline
plt.figur(Feigengröße=(15,7))
plt.subplot(1,3,1)
plt.titel("TextBlob-Ergebnisse")
plt.pie(tb_counts.values, Etiketten = tb_counts.index, explodieren = (0, 0, 0.25), autopct="%1.1F%%", Schatten=Falsch)
plt.subplot(1,3,2)
plt.titel("VADER-Ergebnisse")
plt.pie(vader_counts.values, Etiketten = vader_counts.index, explodieren = (0, 0, 0.25), autopct="%1.1F%%", Schatten=Falsch)
plt.subplot(1,3,3)
plt.titel("SentiWordNet-Ergebnisse")
plt.pie(swn_counts.values, Etiketten = swn_counts.index, explodieren = (0, 0, 0.25), autopct="%1.1F%%", Schatten=Falsch)
Wenn wir uns das Bild oben ansehen, Die Ergebnisse von TextBlob und SentiWordNet sehen etwas eng aus, während die VADER-Ergebnisse eine große Variation zeigen.
Abschließende Anmerkungen:
Herzlichen Glückwunsch 🎉 an uns. Am Ende dieses Artikels, Wir haben die verschiedenen Schritte der Datenvorverarbeitung und die verschiedenen lexikalischen Ansätze zur Sentimentanalyse kennengelernt. Wir vergleichen die Ergebnisse von TextBlob, VADER, SentiWordNet mit Tortendiagrammen.
Verweise:
Vollständiges Jupyter-Notizbuch ansehen hier auf GitHub gehostet.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von Analytics Vidhya und werden nach Ermessen des Autors verwendet.





