
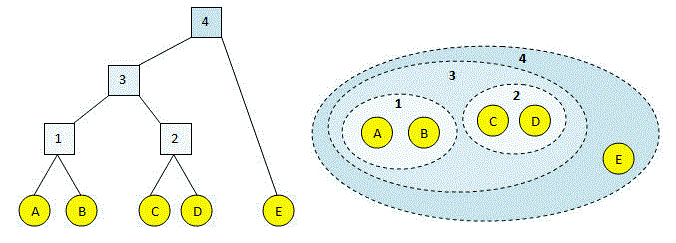
Wie wir alle wissen, Die agglomerative hierarchische Gruppierung beginnt damit, dass jede Beobachtung als einzelne Gruppe behandelt wird und dann die Gruppen iterativ zusammengeführt werden, bis alle Datenpunkte zu einer einzigen Gruppe zusammengeführt sind. Dendrogramme werden verwendet, um die Ergebnisse von GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. hierarchisch.
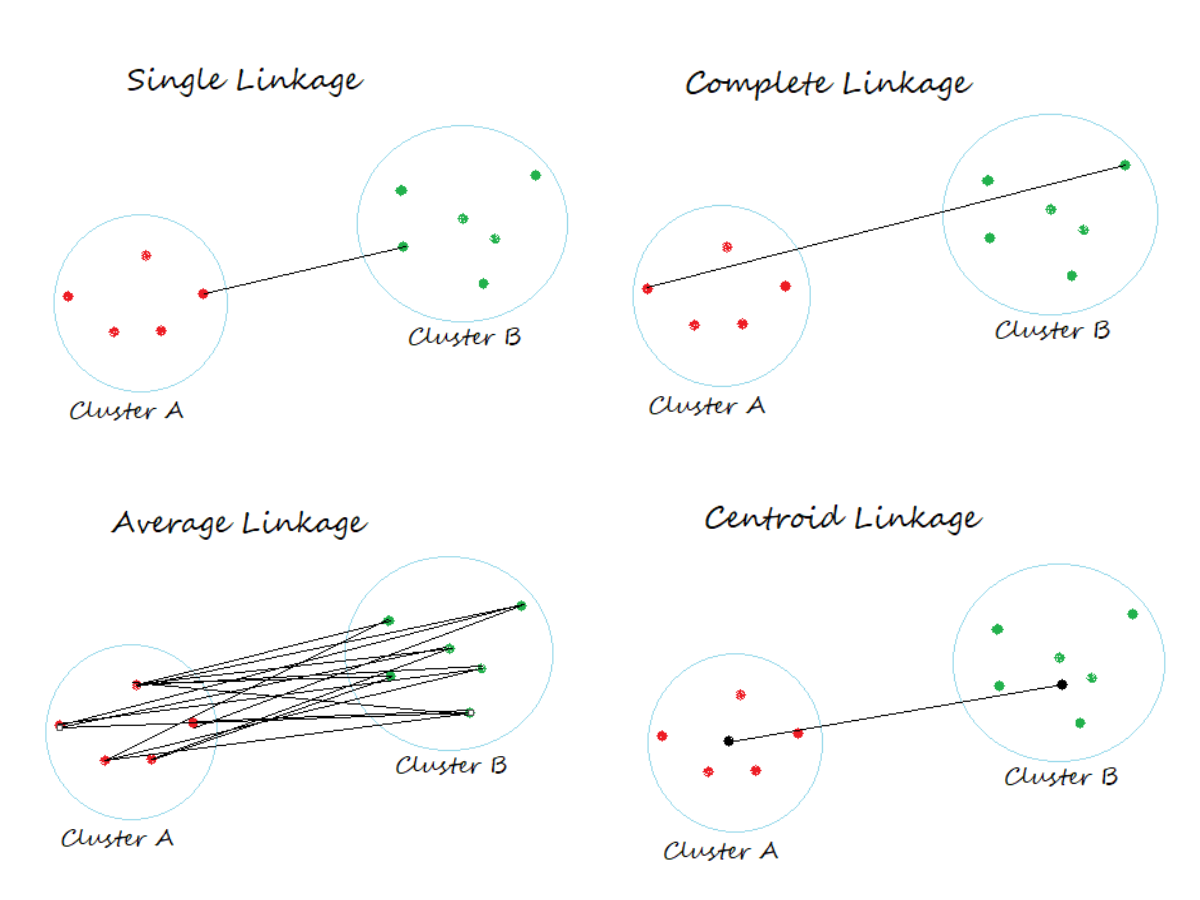
Die Cluster werden basierend auf der Entfernung zwischen ihnen zusammengeführt und um die Entfernung zwischen den Clustern zu berechnen, haben wir verschiedene Arten von Links.
Verknüpfungskriterien:
Bestimmen Sie den Abstand zwischen Beobachtungssätzen basierend auf dem paarweisen Abstand zwischen den Beobachtungen.
- In Einzelne Verbindung, der Abstand zwischen zwei Gruppen ist der Mindestabstand zwischen den Mitgliedern der beiden Gruppen
- In Vollständige Kopplung, der Abstand zwischen zwei Gruppen ist der maximale Abstand zwischen den Mitgliedern der beiden Gruppen
- In Durchschnittliche Verknüpfung, der Abstand zwischen zwei Clustern ist der Durchschnitt aller Abstände zwischen den Mitgliedern der beiden Cluster
- In Schwerpunktverbindung, der Abstand zwischen zwei Gruppen ist der Abstand zwischen ihren Schwerpunkten
In diesem Artikel, Unser Ziel ist es, den Clustering-Prozess mit der Single-Link-Methode zu verstehen.
Gruppierung einzelner Links:
Beginnen Sie mit dem Importieren der erforderlichen Bibliotheken
numpy als np importieren
Pandas als pd importieren
import matplotlib.pyplot als plt
%matplotlib inline
scipy.cluster.hierarchy als shc importieren
aus scipy.spatial.distance importieren quadratische Form, pdist
Erstellen wir Spielzeugdaten mit numpy.random.random_sample
a = np.random.random_sample(Größe = 5)
b = np.random.random_sample(Größe = 5)
Sobald wir die zufälligen Datenpunkte generiert haben, Wir erstellen einen Pandas-Datenrahmen.
Punkt = ['P1','P2','P3','P4','P5']
data = pd.DataFrame({'Punkt':Punkt, 'a':np.rund(ein,2), 'b':np.rund(B,2)})
data = data.set_index('Punkt')
Daten
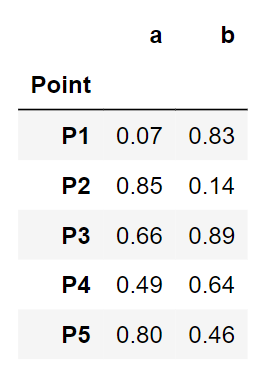
Ein Blick auf die Daten unserer Spielzeuge. Sieht sauber aus. Kommen wir zu den Gruppierungsschritten.
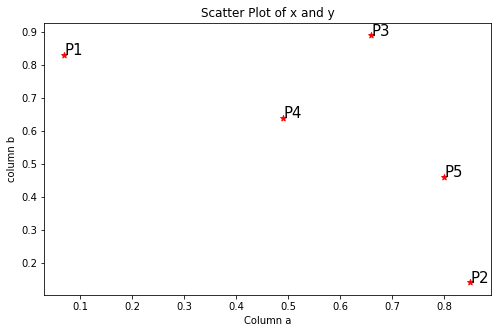
Paso 1: Visualisieren Sie Daten mit einem AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen....
plt.figur(Feigengröße=(8,5))
plt.streuung(Daten['a'], Daten['b'], c="R", Markierung="*")
plt.xlabel('Spalte a')
plt.ylabel('Spalte b')
plt.titel('Streudiagramm von x und y')für j in data.itertuples():
    plt.annotate(j.Index, (j.a, j.b), Schriftgröße=15)
Paso 2: Berechnung der Distanzmatrix in der euklidischen Methode mit pdist
dist = pd.DataFrame(quadratische Form(pdist(Daten[['ein', 'B']]), „euklidisch“), Spalten=data.index.values, index=data.index.values)
Für unsere Bequemlichkeit, Wir werden nur die unteren Grenzwerte des Arrays berücksichtigen, wie unten gezeigt.
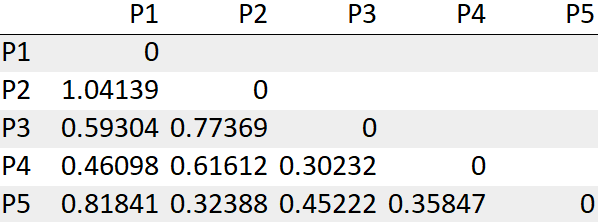
Paso 3: Finden Sie die kürzeste Entfernung und fassen Sie sie zu einer Gruppe zusammen
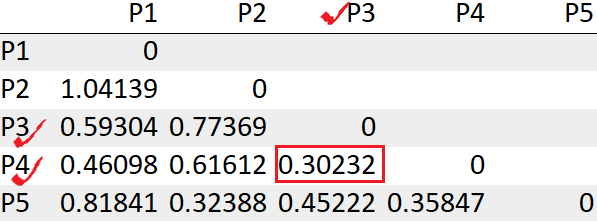
Wir sehen die Punkte P3, P4 hat den Mindestabstand „0.30232“. Dann, Zuerst werden wir sie zu einer Gruppe zusammenführen.
Paso 4: Berechne die Distanzmatrix neu, nachdem du eine Gruppe gebildet hast
Aktualisieren Sie den Abstand zwischen der Gruppe (P3, P4) ein P1
= Min (dist (P3, P4), P1)) -> Mindest (dist (P3, P1), dist (P4, P1))
= Min (0.59304, 0.46098)
= 0,46098
Aktualisieren Sie den Abstand zwischen der Gruppe (P3, P4) ein P2
= Min (dist (P3, P4), P2) -> Mindest (dist (P3, P2), dist (P4, P2))
= Minimum (0,77369, 0,61612)
= 0,61612
Aktualisieren Sie den Abstand zwischen der Gruppe (P3, P4) ein P5
= Min (dist (P3, P4), P5) -> Mindest (dist (P3, P5), dist (P4, P5))
= Minimum (0.45222, 0.35847)
= 0.35847
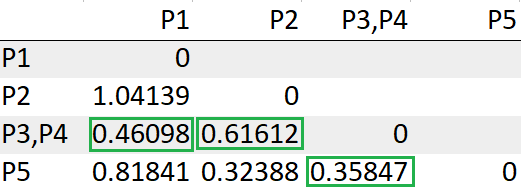
Schritte wiederholen 3, 4 bis wir bei nur einer Gruppe bleiben.
Nach Neuberechnung der Distanzmatrix, Wir müssen erneut nach dem Mindestabstand suchen, um eine ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.....
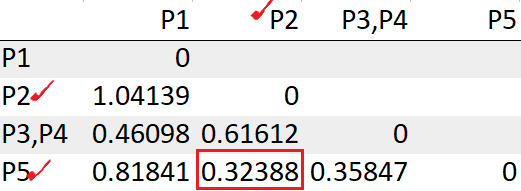
Wir sehen die Punkte P2, P5 hat den Mindestabstand „0.32388“. Also gruppieren wir sie in eine Gruppe und berechnen die Distanzmatrix neu.
Aktualisieren Sie den Abstand zwischen der Gruppe (P2, P5) ein P1
= Min (dist ((P2, P5), P1)) -> Mindest (dist (P2, P1), dist (P5, P1))
= Min (1.04139, 0.81841)
= 0,81841
Aktualisieren Sie den Abstand zwischen der Gruppe (P2, P5) ein (P3, P4)
= Min (dist ((P2, P5), (P3, P4))) -> = Min (dist (P2, (P3, P4)), dist (P5, (P3, P4)))
= Min (dist (0.61612, 0.35847))
= 0.35847
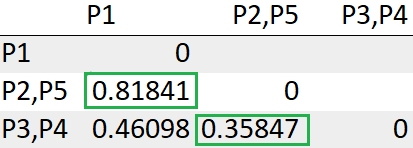
Nach Neuberechnung der Distanzmatrix, wir müssen wieder nach dem Mindestabstand suchen.
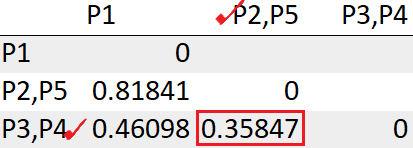
Die Gruppe (P2, P5) hat den geringsten Abstand zur Gruppe (P3, P4) „0.35847“. Also werden wir sie gruppieren.
Aktualisieren Sie den Abstand zwischen der Gruppe (P3, P4, P2, P5) ein P1
= Min (dist (((P3, P4), (P2, P5)), P1))
= Min (0,46098, 0,81841)
= 0,46098
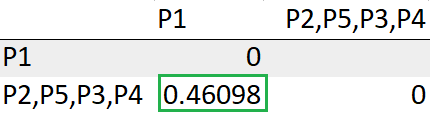
Mit diesem, Am Ende erhalten wir einen einzelnen Cluster.
Theoretisch, unten sind die Gruppierungsschritte:
- Punkte P3, P4 haben den kürzesten Abstand und sind verschmolzen
- Punkte P2, P5 haben den kürzesten Abstand und sind verschmolzen
- Die Gruppen (P3, P4), (P2, P5) sie sind gruppiert
- Die Gruppe (P3, P4, P2, P5) verschmilzt mit Datenpunkt P1
Wir können das gleiche mit einem Dendrogramm visualisieren.
plt.figur(Feigengröße=(12,5))
plt.titel("Dendrogramm mit Einzeltinte")
dend = shc.dendrogramm(shc.linkage(Daten[['a', 'b']], method='einzeln'), label=data.index)
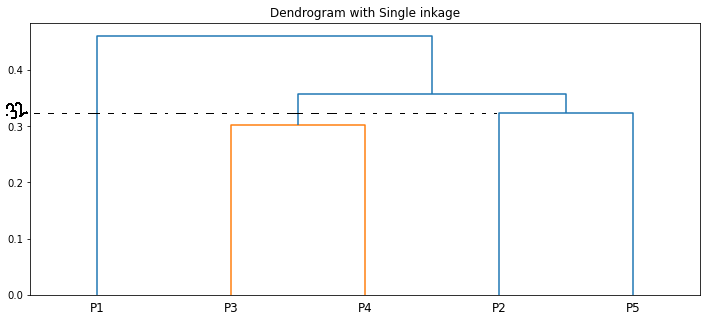
Die Länge der vertikalen Linien im Dendrogramm zeigt den Abstand. Zum Beispiel, der Abstand zwischen den Punkten P2, P5 ist 0.32388.
Die schrittweise Gruppierung, die wir vorgenommen haben, ist die gleiche wie die des Dendrogramms🙌
Abschließende Anmerkungen:
Am Ende dieses Artikels, wir sind mit der tiefgreifenden Arbeit der hierarchischen Gruppierung mit einzelnen Links vertraut. Im nächsten Artikel, wir werden die anderen Verknüpfungsmethoden lernen.
Verweise:
GitHub-Repository-Link zum Bezahlen von Jupyter Notebook
Ich hoffe, dieser Blog hilft Ihnen zu verstehen, wie die hierarchische Gruppierung einzelner Links funktioniert. Bitte, gib ihm einen Klaps 👏. Viel Spaß beim Lernen !! 😊
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





