
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Der Random Forest-Algorithmus ist ohne Zweifel einer der beliebtesten Algorithmen unter Data Scientists.. Funktioniert hervorragend bei Klassifizierungs- und Regressionsproblemen. Random Forest ist als Ensemble-Technik bekannt, da es sich um eine Sammlung mehrerer Entscheidungsbäume handelt.
Was war der Hauptzweck der Verwendung mehrerer Entscheidungsbäume??
Die Verwendung eines einzigen Entscheidungsbaums hat mehrere Nachteile. Wenn wir einen einzelnen Entscheidungsbaum verwenden, um eine Problemstellung zu lösen, wir finden eine Situation mit geringem Bias und hoher Varianz. Nämlich, el árbol capturará toda la información sobre los datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen...., sowie der Lärm. Infolge, Das mit dem Entscheidungsbaumalgorithmus entwickelte Modell funktioniert gut mit den Trainingsdaten, aber es wird schlecht funktionieren, wenn es anhand der Testdaten ausgewertet wird (unbekannte Daten). Overfitting ist die Bedingung eines geringen Bias und einer hohen Varianz.
Entscheidungsbaum -----> Übereinstellung ————–> geringe Abweichung hohe Varianz
Random Forest verwendet mehrere Entscheidungsbäume, um dieses im Entscheidungsbaumalgorithmus vorhandene Problem zu vermeiden.
Aber, Wie geht Random Forest das Problem der Überanpassung an??
Der Random Forest-Algorithmus verwendet nicht alle Trainingsdaten beim Trainieren des Modells, wie im Diagramm unten zu sehen. Stattdessen, Beispielzeilen und -spalten mit Wiederholung. Das bedeutet, dass jeder Baum nur mit einer begrenzten Anzahl von Zeilen und Spalten mit sich wiederholenden Daten trainiert werden kann. Im folgenden Diagramm, Trainingsdaten 1 werden verwendet, um den Entscheidungsbaum zu trainieren 1, und Trainingsdaten n werden verwendet, um den Entscheidungsbaum n . zu trainieren. Aber trotzdem, da jeder Baum in seiner vollen Tiefe erstellt wird und die Überanpassungseigenschaft hat, Wie vermeiden wir dieses Problem?
Da der Algorithmus nicht vom Ergebnis eines bestimmten Entscheidungsbaums abhängt. Sie erhalten zunächst die Ergebnisse aller Entscheidungsbäume und geben dann das Endergebnis basierend auf der Art der Problemstellung an. Zum Beispiel; wenn die Art der Problemstellung die Klassifikation ist, Mehrheitsbeschluss würde verwendet. Angenommen, wir klassifizieren „Jawohl“ Ja „Nein“ mit 10 Bäume, und 6 Bäume sortieren „Jawohl“ Ja 4 sie klassifizieren „Nein“, die endgültige antwort wird sein „Jawohl“ mit Mehrheitsabstimmung. ¿Qué pasa si nuestra salida es una VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... continua? Dann, el resultado final sería la media o la MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... de la producción de todos los árboles.
Klassifizierungsproblem -> Stimmenmehrheit
Regressionsproblem -> Medien / Median
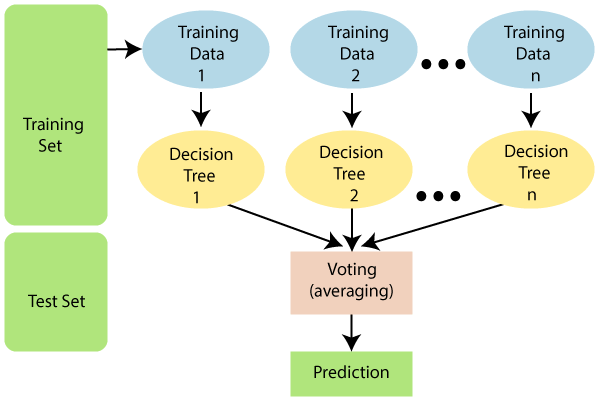
Das Modell führt eine Reihenstichprobe durch. Aber trotzdem, Die Merkmalsstichprobe sollte entsprechend der Art der Problemstellung durchgeführt werden.
- Wenn der Problemaussagetyp ist „Einstufung“.
Die Gesamtzahl der Funktionen / zufällige Spalten ausgewählt = p ^ ½ oder die Quadratwurzel von p,
wobei p die Gesamtzahl von ist Unabhängig Attribute / in den Daten vorhandene Merkmale.
- Wenn der Problemaussagetyp ist „Rückschritt“.
Die Gesamtzahl der ausgewählten zufälligen Spalten = P / 3.
Random Forest vermeidet eine Überanpassung mit: –
1) Durchführen von Reihen- und Merkmalsstichproben.
2) Alle Entscheidungsbäume parallel verbinden.
Warum ist es als Bootstrap Aggregation-Technik bekannt??
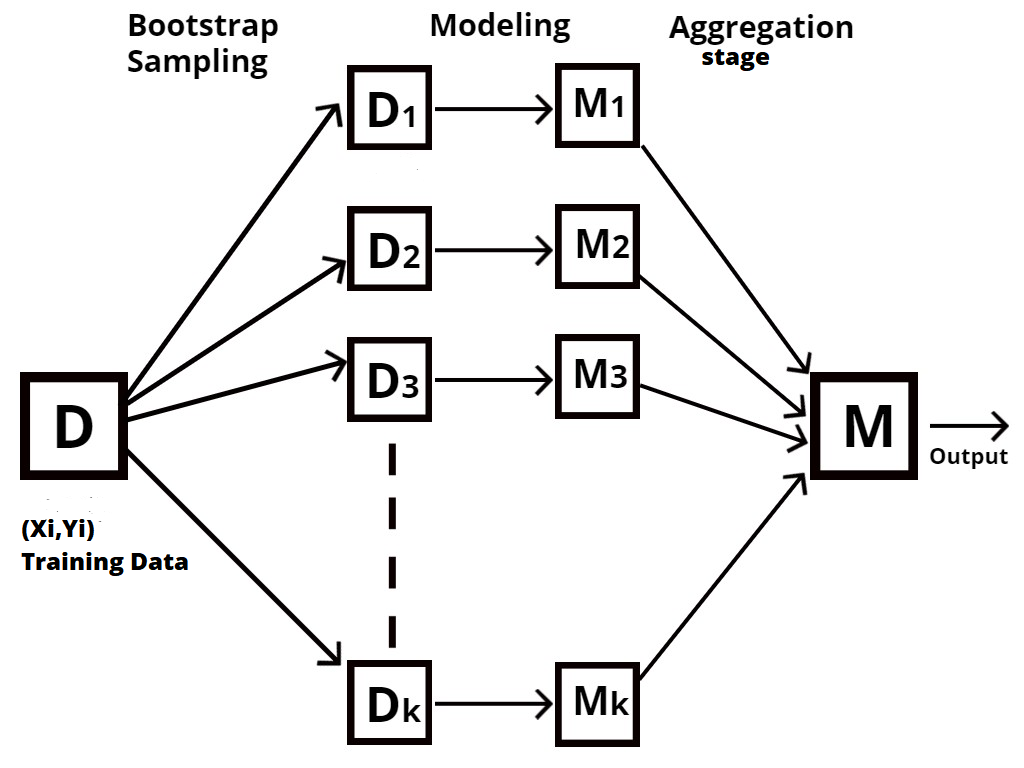
Random Forest ist eine Art Set-Technik, auch bekannt als Bootstrap-Aggregation Ö harpillera.
Der Prozess des Abtastens verschiedener Zeilen und Merkmale der Trainingsdaten mit Wiederholung, um jedes Entscheidungsbaummodell zu erstellen, wird als Bootstrapping bezeichnet., wie in der folgenden Abbildung gezeigt.
Aggregation ist der Prozess, bei dem alle Ergebnisse aus jedem Entscheidungsbaum genommen und kombiniert werden, um ein Endergebnis unter Verwendung von Mehrheitsstimmen oder Durchschnittswerten zu erhalten., je nach Art der Problemstellung.
Zufälliger Wald mit R
Bücherei(caTools)

Bücherei(zufälligWald)
Necesitamos instalar las bibliotecas ‚caTools‘ Ja ‚zufälligWald‘ und über die Bibliotheksfunktion aktivieren ()
Hemos utilizado el conjunto de datos de autenticación de billetes y lo hemos almacenado en la variable ‚Daten‘. Wir werden die Struktur der Daten mit der str-Funktion überprüfen ().
Daten <- lesen.csv ('bank_note_data.csv', Kopfzeile = T)
str (Daten)
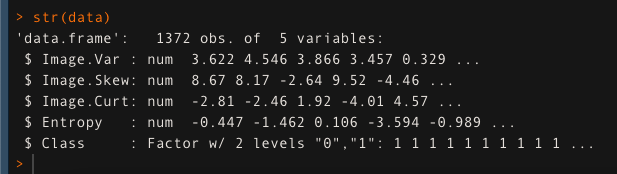
Jetzt werden wir unsere Daten in Test- und Trainingsteile aufteilen. 80% zum Training und 20% um das Modell zu testen.
Saat (123)
Teilt <- probe.split (Daten, Splitverhältnis = 0.8)
Bahn <- Teilmenge (Daten, dividieren == T)
nachweisen <- Teilmenge (Daten, Teilung == F)
Nach dem Teilen der Daten, wir bauen unser Modell mit der randomForest-Funktion (). Hier ‚ntree‘ ist der Hyperparameter. was muss angepasst werden. In diesem Fall, ist ausgewählt als 500.
random_model <- random_forest (Klasse ~., Daten = Zug, mtry = 2, Baum = 500)
Vorhersage der Modellgenauigkeit von Testdaten mithilfe der Vorhersagefunktion ().
bewerten <- Vorhersagen (random_model, nachweisen)
Bewerten Sie die Präzision des Modells mit der Konfusionsmatrix.
Verwirrung Matrix (Tisch (bewerten, nachweisen $ Klasse))
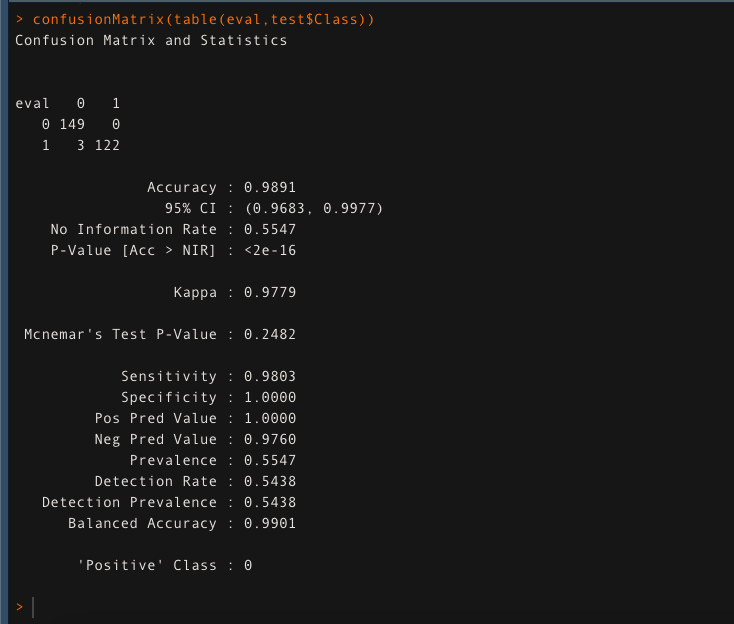
Das Modell gibt eine Genauigkeit von 98,91% in den Testdaten. Dies stellt sicher, dass Random Forest einen fantastischen Job macht..





