
[*]
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Wetter. Son datos con un tamaño y complejidad tan grandes que ninguna de las herramientas tradicionales de administración de datos los almacenará o procesará con eficiencia.
Big Data es un campo que trata las formas de investigar, analizar y extraer información de forma consistente de una gran cantidad de datos estructurados o no estructurados.
Python tiene varias características incorporadas para admitir el procesamiento de datos, ya sea de tamaño pequeño o enorme. Estas funciones admiten el procesamiento de datos no estructurados y no convencionales. Esta es la razón por la que los científicos de datos y las empresas de Big Data prefieren elegir Python para el procesamiento de datos, da es als eine der wichtigsten Anforderungen im Bereich Big Data gilt.
Es gibt auch andere Technologien, die Big Data effizienter als Python verarbeiten können. Dies sind Hadoop und Spark.
Hadoop
Hadoop ist die beste Lösung zur Speicherung und Verarbeitung von Big Data, da Hadoop riesige Dateien in Form von Verteiltes DateisystemEin verteiltes Dateisystem (DFS) Ermöglicht die Speicherung und den Zugriff auf Daten auf mehreren Servern, Erleichterung der Verwaltung großer Informationsmengen. Diese Art von System verbessert die Verfügbarkeit und Redundanz, da Dateien an verschiedene Speicherorte repliziert werden, Reduzierung des Risikos von Datenverlusten. Was ist mehr, Ermöglicht Benutzern den Zugriff auf Dateien von verschiedenen Plattformen und Geräten aus, die Zusammenarbeit zu fördern und... (HDFSHDFS, o Verteiltes Hadoop-Dateisystem, Es ist eine Schlüsselinfrastruktur für die Speicherung großer Datenmengen. Entwickelt für die Ausführung auf gängiger Hardware, HDFS ermöglicht die Datenverteilung über mehrere Knoten, Sicherstellung einer hohen Verfügbarkeit und Fehlertoleranz. Seine Architektur basiert auf einem Master-Slave-Modell, wobei ein Master-Knoten das System verwaltet und Slave-Knoten die Daten speichern, Erleichterung der effizienten Verarbeitung von Informationen..) Hadoop ohne Angabe eines Schemas speichert.
Es ist hoch skalierbar, da jedem beliebigen Knoten zur Leistungsverbesserung hinzugefügt werden kann. In Hadoop, sind die Daten auch bei einem Hardwareausfall hoch verfügbar.
Funke – Funke
Spark ist ebenfalls eine gute Option zur Verarbeitung großer Mengen strukturierter oder unstrukturierter Datensätze, da die Daten in Clustern gespeichert werden. Spark wird so konzipiert sein, dass es die maximale Datenmenge im Speicher hält, damit sie auf die Festplatte überläuft. Es wird einen Teil des Datensatzes im Speicher speichern und, Daher, die restlichen Daten auf der Festplatte.
Die erste Wahl der Sprache für Today Data Scientist ist Python, und sowohl Hadoop als auch Spark bieten Python-APIs, die Big-Data-Verarbeitung ermöglichen und auch einen einfachen Zugriff auf Big-Data-Plattformen erlauben.
Bildquelle: für mich
Bedarf von Python im Big Data
1. Open Source:
Python ist eine Open-Source-Programmiersprache, die unter einer von der OSI genehmigten Open-Source-Lizenz entwickelt wurde, was sie frei nutzbar und verteilbar macht, auch für kommerzielle Nutzung.
Python ist eine interpretierte Hochsprache mit allgemeinem Zweck. No es necesario compilarlo para ejecutarse. Un programa conocido como intérprete ejecuta código Python en prácticamente cualquier tipo de sistema. Esto implica que un desarrollador puede modificar el código y ver rápidamente los resultados.
2. Leicht zu lernen:
Python es muy fácil de aprender al igual que el idioma inglés. Su sintaxis y código son fáciles y legibles también para principiantes. Python tiene muchas aplicaciones como el desarrollo de aplicaciones web, Datenwissenschaft, maschinelles Lernen, etc.
Python nos permite escribir programas con menos líneas de código que la mayoría de los otros lenguajes de programación. La popularidad de Python está creciendo rápidamente debido a su simplicidad.
3. Bibliotecas de procesamiento de datos:
Cuando se trata de procesamiento de datos, Python hat eine
reichhaltiges Werkzeugset mit einer breiten Palette von Vorteilen. Da es eine Open-Source-Programmiersprache ist, ist es einfach zu lernen und verbessert sich auch kontinuierlich. Python besteht aus einer Liste mehrerer nützlicher Bibliotheken zur Datenverarbeitung und ist auch mit anderen Sprachen integriert (wie Java), sowie mit bestehenden Strukturen. Python ist bibliothekenreicher, was seine Funktionalität weiter verbessert.
4. Kompatibilität mit Hadoop und Spark:
Das Hadoop-Framework ist in der Programmiersprache Java geschrieben; aber trotzdem, Hadoop-Programme können in Python oder C codiert werden ++. Wir können Programme wie MapReduce in Python schreiben, obwohl es nicht erforderlich ist, den Code in Java-Jar-Dateien zu übersetzen.
Spark proporciona una API de Python llamada PySpark lanzada por la comunidad de Apache Spark para admitir Python con Spark. Usando PySpark, uno simplemente integrará y trabajará con RDD dentro del lenguaje de programación Python también.
Spark viene con un shell de Python interactivo llamado PySpark shell. Este shell de PySpark es responsible del enlace entre la API de Python y el núcleo de chispa y de inicializar el contexto de chispa. PySpark también se puede iniciar directamente desde la línea de comando dando algunas instrucciones para uso interactivo.
5. Velocidad y eficiencia:
Python es un lenguaje de programación de alto nivel poderoso y eficiente. Ya sea para desarrollar una aplicación o trabajar para resolver cualquier problema comercial a través de la ciencia de datos, Python lo tiene cubierto todos estos límites. Python siempre funciona bien para optimizar la productividad y la eficiencia de los desarrolladores.
Podemos crear rápidamente un programa que puede resolver un problema comercial y satisface una necesidad práctica. Aber trotzdem,
Es posible que las soluciones no alcancen el rendimiento optimizado de Python mientras se desarrollan rápidamente.
6. Escalable y flexible:
Python es el lenguaje más popular para ML / AI debido a su conveniencia. La flexibilidad de Python también permite instrumentar el código de Python para formar la escalabilidad ML / AI posiblemente sin requerir una mayor experiencia en el sistema distribuido y muchos cambios de código invasivos. Deswegen, los usuarios de ML / AI obtienen las ventajas de la escalabilidad en todo el clúster con un esfuerzo mínimo.
Componentes de Hadoop:
Hay principalmente dos componentes de Hadoop:
- HDFS (Hadoop verteiltes Dateisystem)
- Kleine Karte
Sistema de archivos distribuido Hadoop
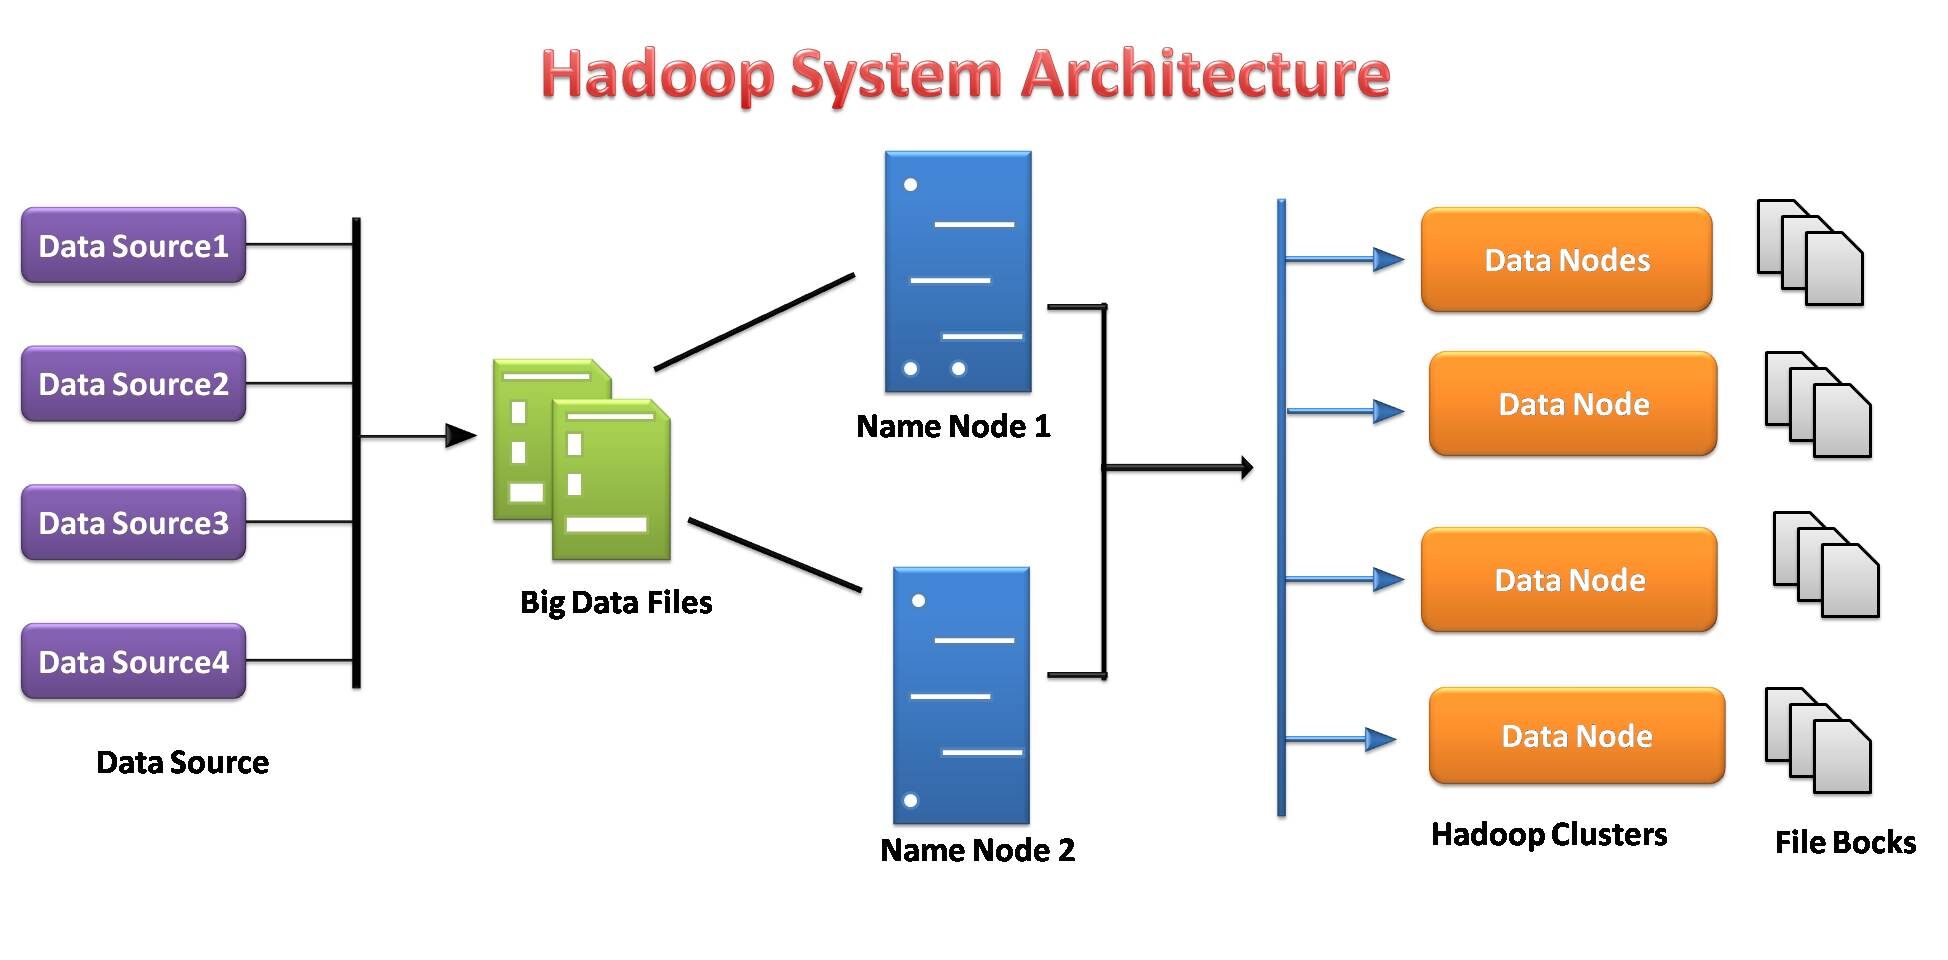
El sistema de archivos Hadoop se desarrolló sobre la base del modelo de sistema de archivos distribuido. Funciona con hardware básico. A diferencia de los diferentes sistemas distribuidos, HDFS es extremadamente tolerante a fallas y está diseñado con hardware económico.
HDFS puede almacenar una gran cantidad de datos y también proporciona un acceso más fácil a esos datos. Para almacenar una cantidad tan grande de datos, Die Dateien werden in mehreren Systemen gespeichert. Diese Dateien werden redundant gespeichert, um das System im Falle eines Datenverlusts zu retten. Was ist mehr, HDFS bietet Anwendungen für die Multiprozessverarbeitung.
- Es ist verantwortlich für die Speicherung von Daten in einem ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... wie verteilte Speicherung und Verarbeitung.
- Die Daten-Server des KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... Name-Node und Knowledge-Node erleichtern es Benutzern, einfach den Status des Clusters zu überprüfen.
- Jeder Block wird standardmäßig mehrfach repliziert 3 mal. Die Replikate werden auf völlig unterschiedlichen Knoten gespeichert.
- Hadoop Streaming dient als Brücke zwischen Ihrem Python-Code und, Daher, dem auf Java basierenden HDFS, und ermöglicht Ihnen einen nahtlosen Zugriff auf Hadoop-Cluster und das Ausführen von Aufgaben Karte verkleinernMapReduce ist ein Programmiermodell, das entwickelt wurde, um große Datensätze effizient zu verarbeiten und zu generieren. Unterstützt von Google, Bei diesem Ansatz wird die Arbeit in kleinere Aufgaben aufgeteilt, die auf mehrere Knoten in einem Cluster verteilt sind. Jeder Knoten verarbeitet seinen Teil und dann werden die Ergebnisse kombiniert. Mit dieser Methode können Sie Anwendungen skalieren und große Informationsmengen verarbeiten, in der Welt von Big Data von grundlegender Bedeutung zu sein.....
- HDFS proporciona permisos y autenticación de archivos.
Bildquelle: für mich
Instalación de Hadoop en Google Colab
Hadoop es un marco de procesamiento de datos basado en programación Java. Instalemos la configuración de Hadoop paso a paso en Google Colab. Es gibt zwei Möglichkeiten, la primera es que tenemos que instalar java en nuestras máquinas y la segunda es que instalamos java en google colab, por lo que no es necesario instalar java en nuestras máquinas. Como usamos Google colab, elegimos la segunda forma de instalar Hadoop:
# Install java
!apt-get install openjdk-8-jdk-headless -qq > /dev/null
#create java home variable
import os
os.environ["JAVA_HOME"] = "/usr/lib/jvm/java-8-openjdk-amd64"
os.environ["SPARK_HOME"] = "/content/spark-3.0.0-bin-hadoop3.2"
Paso 1: instalar Hadoop
#download hadoop
!wget https://downloads.apache.org/hadoop/common/hadoop-3.3.0/hadoop-3.3.0.tar.gz
#Wir verwenden den tar-Befehl mit dem -x-Flag zum Extrahieren, -z zum Entkomprimieren,
#-V für ausführliche Ausgabe, und -f, um anzugeben, dass wir aus einer Datei extrahieren
!tar -xzvf hadoop-3.3.0.tar.gz
#kopiere die Hadoop-Datei nach user/local
!cp -r hadoop-3.3.0/ /usr/local/
Paso 2: configurar la VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... de inicio de Java
#finding the default Java path
!readlink -f /usr/bin/java | sed "S:bin/java::"
Paso 3: Ejecuta Hadoop
#Running Hadoop
!/usr/local/hadoop-3.3.0/bin/hadoop
!mkdir ~/input
!cp /usr/local/hadoop-3.3.0/etc/hadoop/*.xml ~/input
!/usr/local/hadoop-3.3.0/bin/hadoop jar /usr/local/hadoop-3.3.0/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.0.jar grep ~/input ~/grep_example 'allowed[.]*'
Jetzt, Google Colab está listo para implementar HDFS.
Kleine Karte
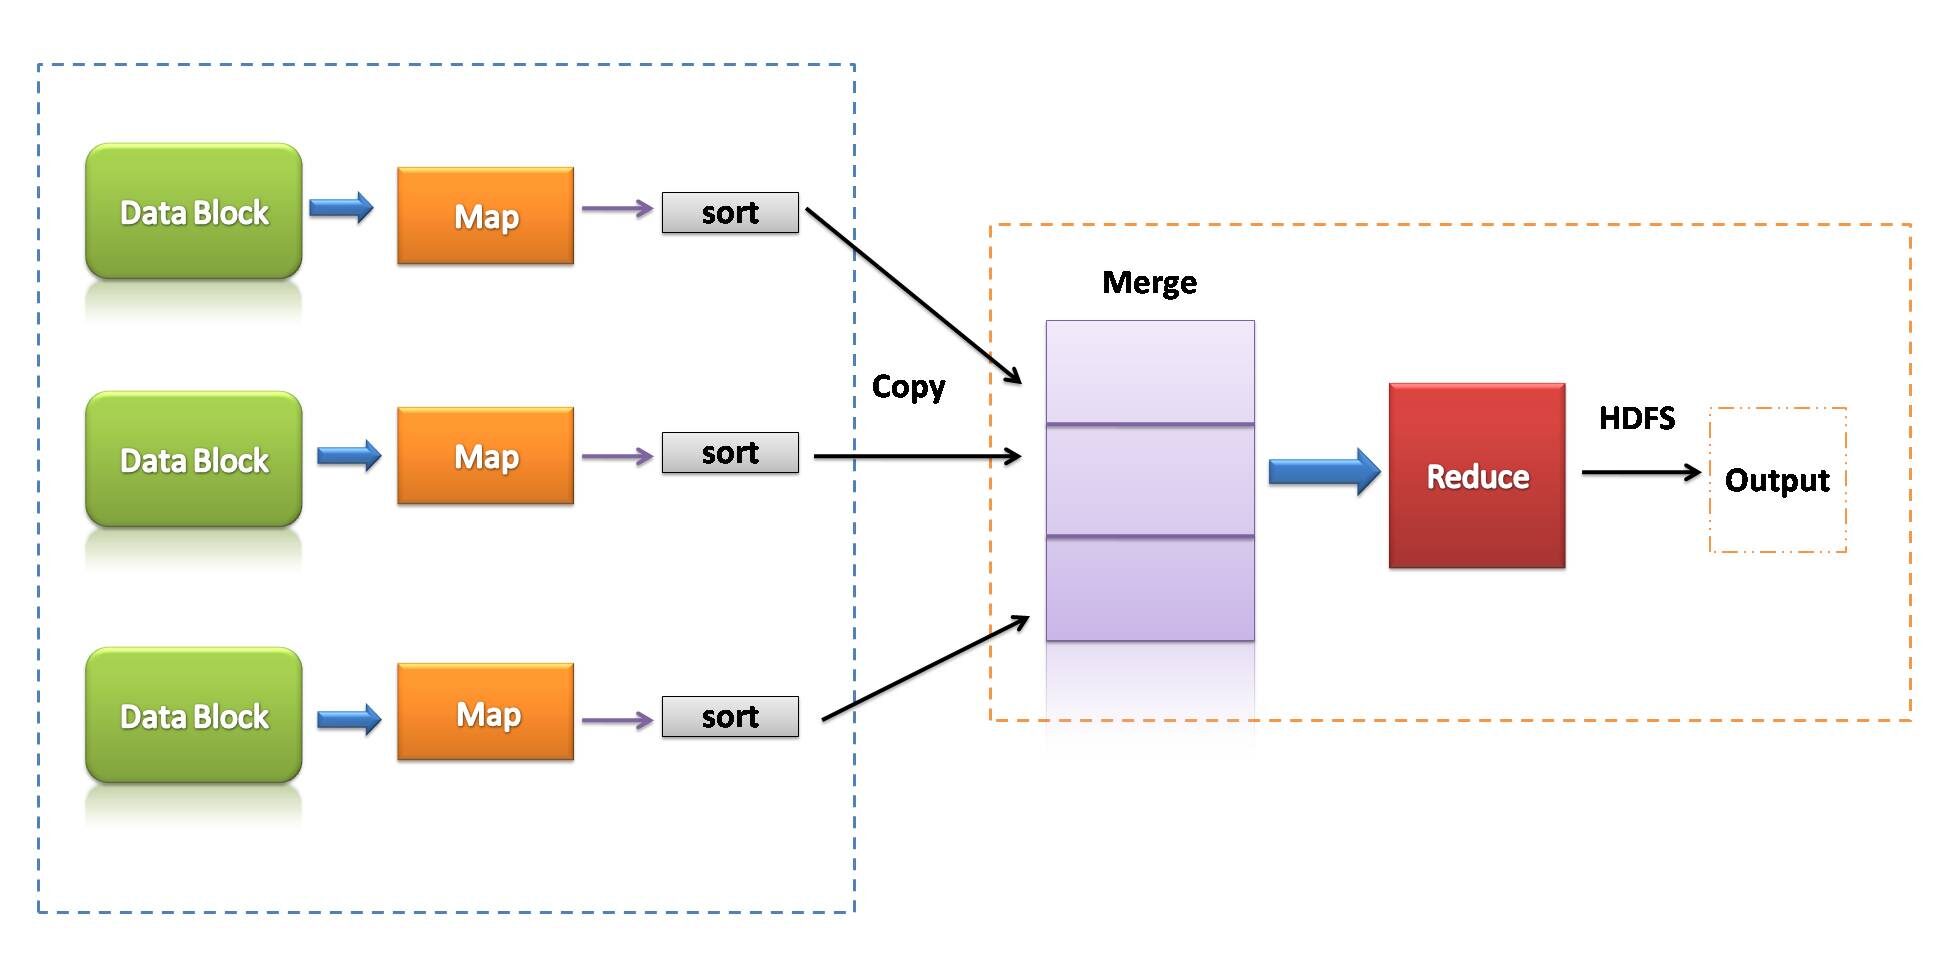
MapReduce es un modelo de programación que se asocia con la implementación del procesamiento y la generación de grandes conjuntos de datos con la ayuda de reglas algorítmicas distribuidas en paralelo en un clúster.
Un programa MapReduce consiste en un procedimiento de mapa, que realiza filtrado y clasificación, y una técnica de reducción, que realiza una operación de esquema.
Bildquelle: für mich
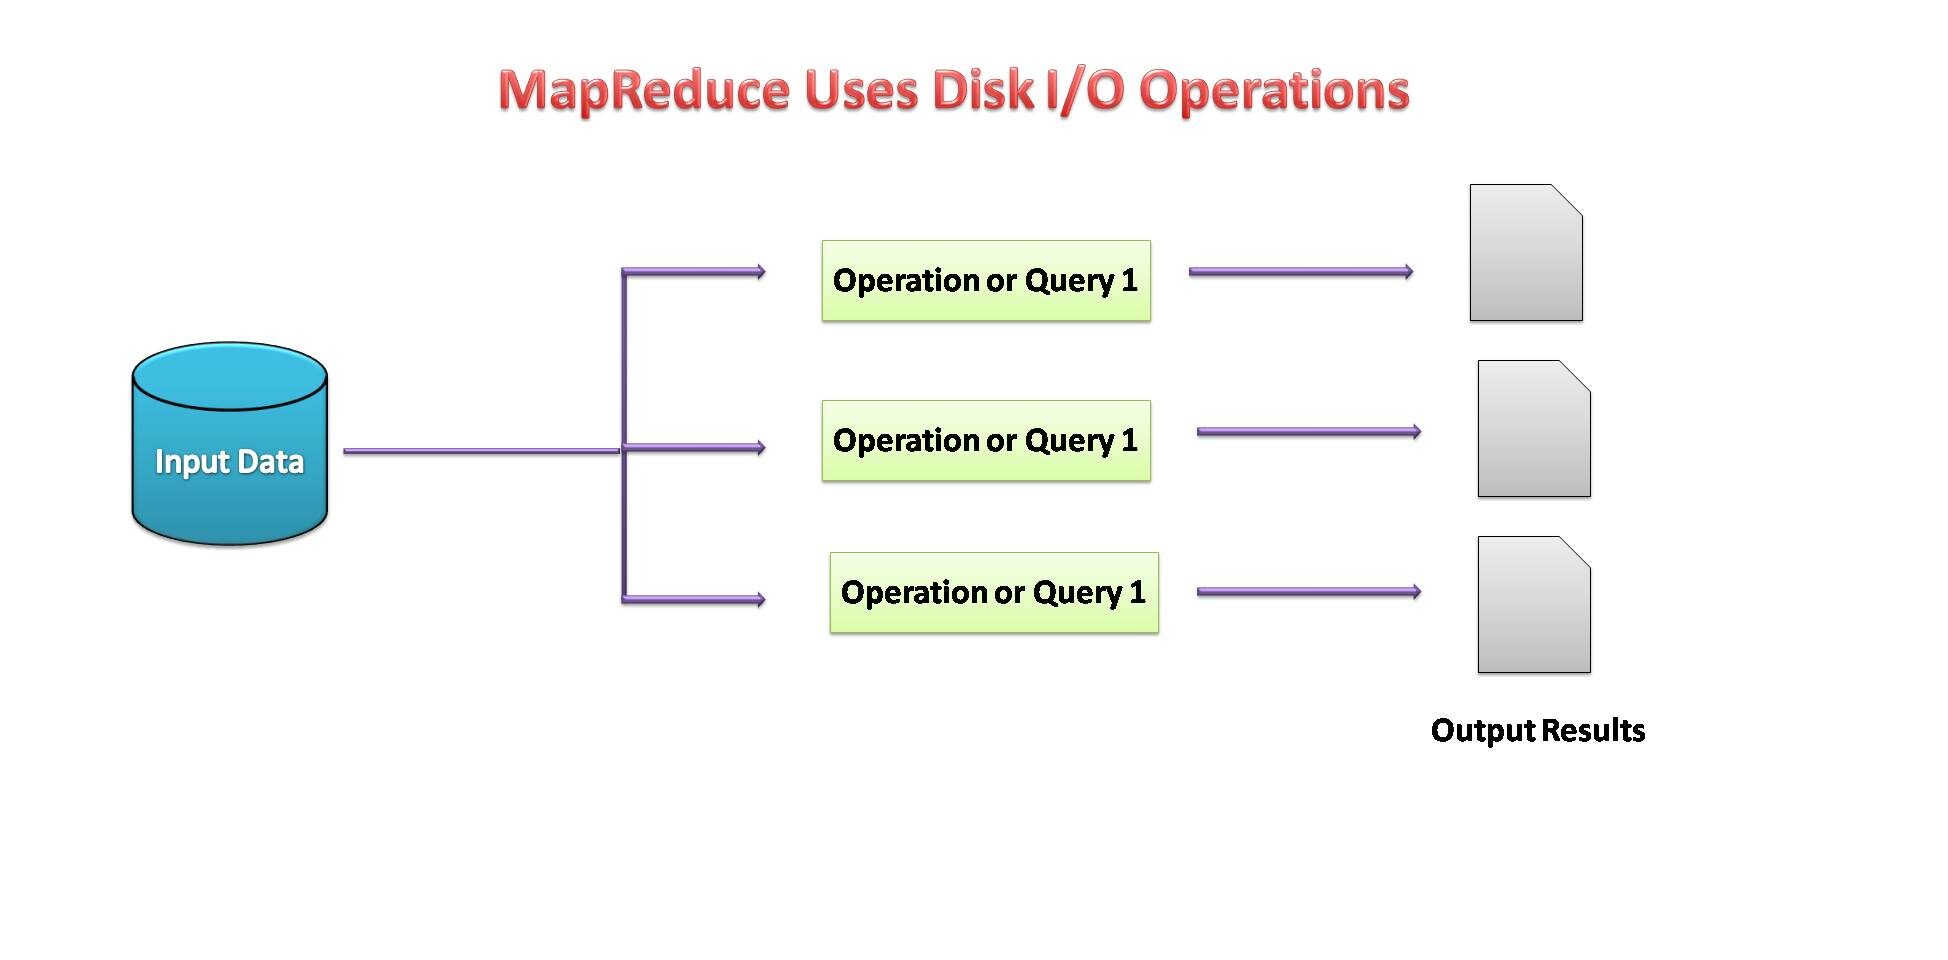
- MapReduce podría ser un marco de procesamiento de datos para procesar datos en el clúster.
- Dos fases consecutivas: mapear y reducir.
- Cada tarea de mapa opera en partes separadas de datos.
- Después del mapa, el reductor trabaja con los datos generados por el asignador en los nodos de datos distribuidos.
- MapReduce usó E / S de disco para realizar operaciones con datos.
Bildquelle: für mich
Apache SparkApache Spark ist eine Open-Source-Datenverarbeitungs-Engine, die die schnelle und effiziente Analyse großer Informationsmengen ermöglicht. Sein Design basiert auf dem Speicher, Dies optimiert die Leistung im Vergleich zu anderen Batch-Verarbeitungstools. Spark wird häufig in Big-Data-Anwendungen verwendet, Maschinelles Lernen und Echtzeitanalysen, Dank seiner Benutzerfreundlichkeit und...
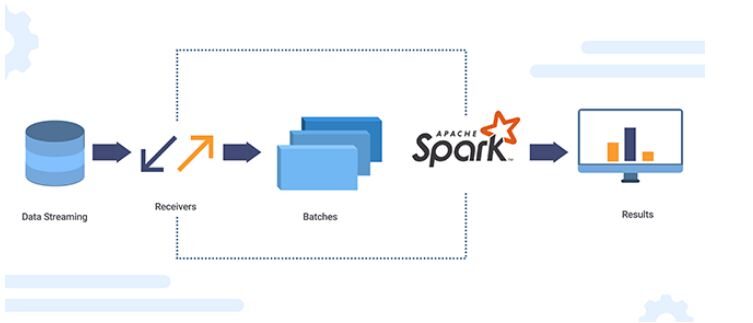
Apache Spark es un motor de análisis de datos de código abierto para el procesamiento a gran escala de datos estructurados o no estructurados. Para trabajar con Python, incluidas las funcionalidades de Spark, la comunidad de Apache Spark había lanzado una herramienta llamada PySpark.
La API Spark Python (PySpark) revela el modelo de programación Spark a Python. Usando PySpark, podemos trabajar con RDD en el lenguaje de programación Python. Es atribuible a una biblioteca conocida como Py4j que pueden alcanzar esto.
Bildquelle: XanonStack
Conjuntos de datos distribuidos resistentes (RDD)
Los conceptos sobre conjuntos de datos distribuidos resilientes (RDD) Sohn:
- El enfoque principal de la programación Spark es RDD.
- Spark es extremadamente tolerante a fallas. Es verfügt über Sammlungen von Objekten, die in einem Cluster verteilt sind und parallel arbeiten können.
- Al usar Spark, kann automatisch von einem Maschinenfehler wiederhergestellt werden.
- Wir können ein RDD erstellen, indem wir Elemente aus einer bestehenden Sammlung kopieren oder auf einen extern gespeicherten Datensatz verweisen.
- Es gibt zwei Arten von Operationen, die RDDs ausführen: Transformationen und Aktionen.
- Die Transformationsoperation verwendet einen vorhandenen Datensatz, um einen neuen zu erstellen. Beispiel: abbilden, Filter, beitreten.
- Die auf dem Datensatz ausgeführten Aktionen geben den Wert an das Steuerprogramm zurück. Beispiel: reduzieren, erzählen, versammeln, speichern.
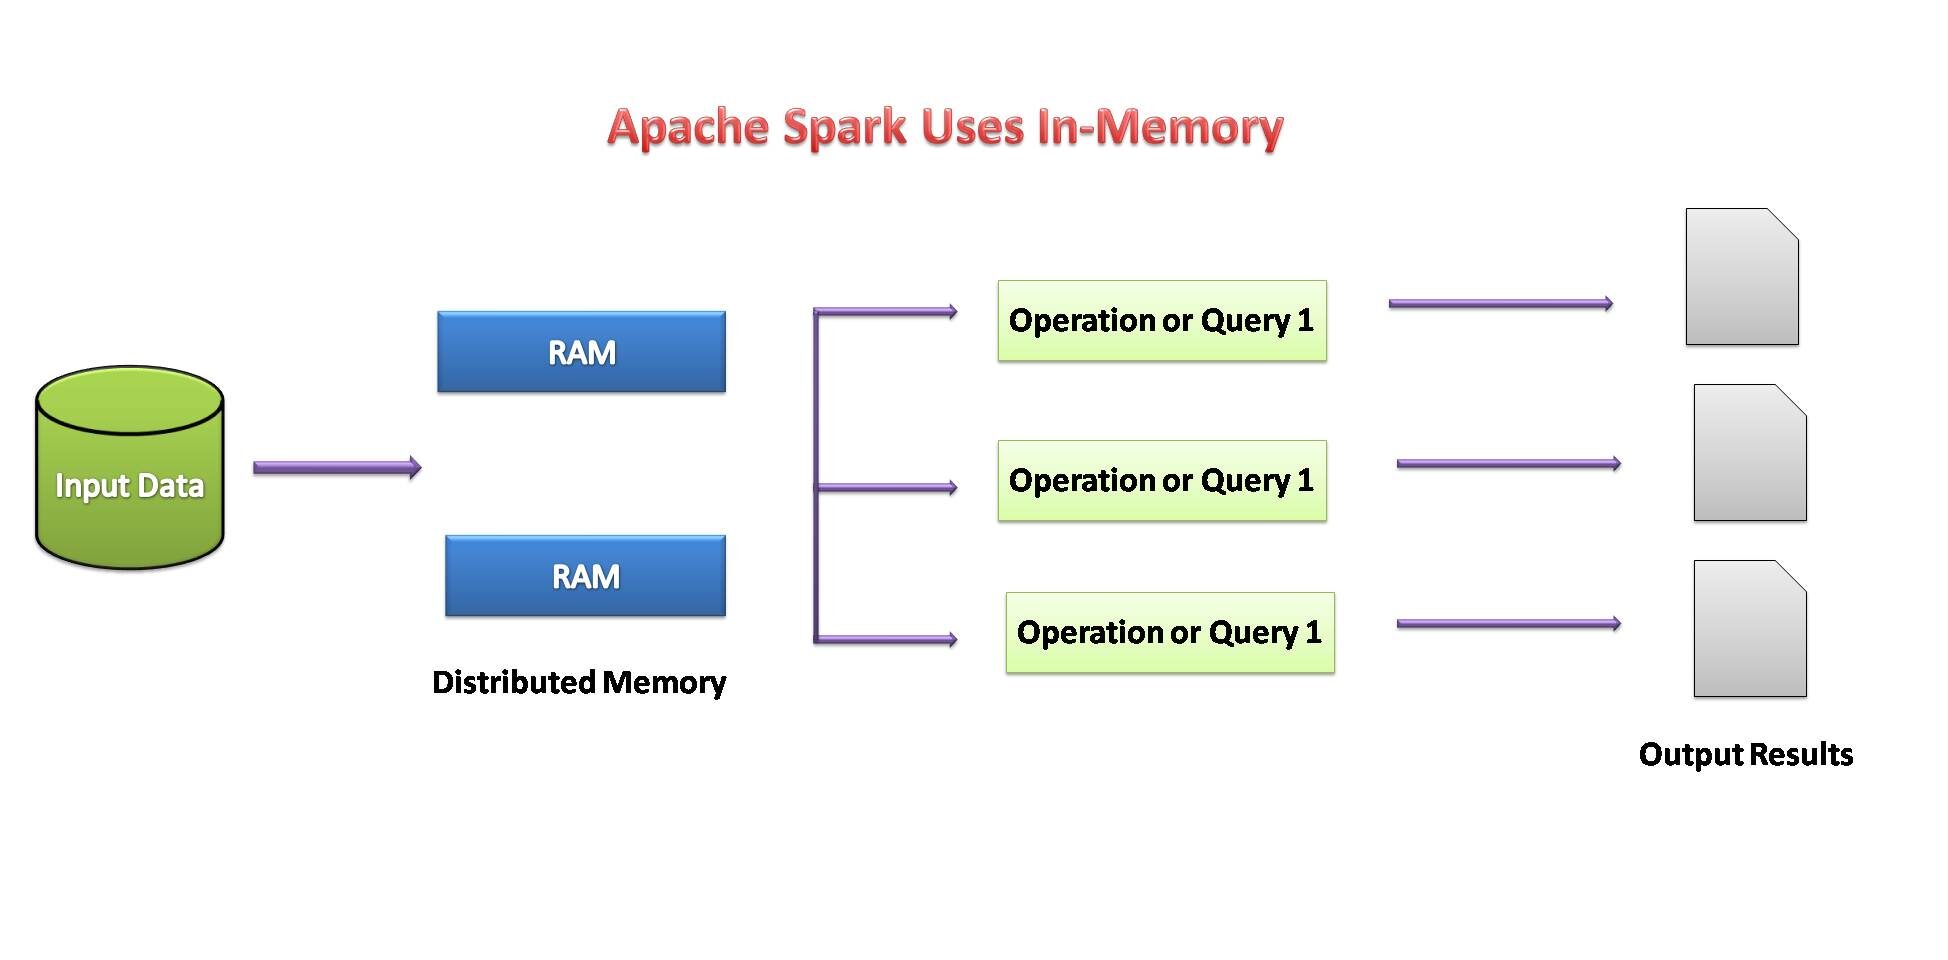
Wenn die Speicherkapazität unzureichend erscheint, werden die Daten auf einer Festplatte wie bei MapReduce gespeichert.
Bildquelle: für mich
Spark-Installation in Google Colab:
Spark ist ein leistungsfähiges Datenverarbeitungs-Framework. Wir können es problemlos in Google Colab installieren.
# Install java
!apt-get install openjdk-8-jdk-headless -qq > /dev/null
#Spark installieren (Ändern Sie die Versionsnummer bei Bedarf)
!wget -q https://archive.apache.org/dist/spark/spark-3.0.0/spark-3.0.0-bin-hadoop3.2.tgz
#Entpacken Sie die Spark-Datei in den aktuellen Ordner
!tar xf spark-3.0.0-bin-hadoop3.2.tgz
#Legen Sie Ihren Spark-Ordner in Ihrem System-Pfad fest.
Importieren von OS
os.environ["JAVA_HOME"] = "/usr/lib/jvm/java-8-openjdk-amd64"
os.environ["SPARK_HOME"] = "/content/spark-3.0.0-bin-hadoop3.2"
#Installieren Sie findspark mit pip
!pip install -q findspark
#Spark für Python (pyspark)
!pip installieren pyspark
#importing pyspark
import pyspark
#importing sparksessio
from pyspark.sql import SparkSession
#creating a sparksession object and providing appName
spark=SparkSession.builder.appName("lokal[*]").getOrCreate()
#printing the version of spark
print("Apache Spark Version: ", spark.version)

Jetzt, Google Colab ist bereit, Spark in Python auszuführen.
Vorteile von Apache Spark:
- Spark ist 10 ein 100 mal schneller als Hadoop MapReduce, wenn es um Datenverarbeitung geht.
- Hat sImplementieren Sie einen Datenverarbeitungsrahmen und interaktive APIs für Python, die die Anwendungsentwicklung beschleunigen helfen.
- Was ist mehr, Es ist effizienter, da es über mehrere Werkzeuge für komplexe analytische Operationen verfügt.
- Es kann leicht in die vorhandene Hadoop-Infrastruktur integriert werden.
Fazit:
In diesem Blog, Wir haben untersucht, wie Python auch zu einem guten und effizienten Werkzeug für die Big-Data-Verarbeitung werden kann. Wir können alle Big-Data-Werkzeuge mit Python integrieren, Was die Datenverarbeitung einfacher und schneller macht. Python ist nicht nur für Data Science, sondern auch für die Big-Data-Verarbeitung zu einer geeigneten Wahl geworden.
Danke fürs Lesen. Bitte lassen Sie es mich wissen, wenn es Kommentare oder Feedback gibt.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





