
Überblick
- Verstehen Sie Spark Streaming und wie es funktioniert.
- Erfahren Sie anhand eines Beispiels mehr über Windows on Spark Streaming.
Einführung
Laut IBM, das 60% aller sensorischen Informationen verlieren innerhalb weniger Millisekunden an Wert, wenn nicht darauf reagiert wird. In Anbetracht dessen, dass der Markt für Big Data und Analytik erreicht hat $ 125 Milliarden und ein großer Teil davon wird in Zukunft auf IoT entfallen, Die Unfähigkeit, Echtzeitinformationen zu nutzen, wird zu einem Verlust von Milliarden von Dollar führen.
Beispiele für einige dieser Anwendungen umfassen ein Telekommunikationsunternehmen, das berechnet, wie viele seiner Nutzer Whatsapp zuletzt verwendet haben 30 Protokoll, Ein Einzelhändler, der die Anzahl der Menschen verfolgt, die sich heute in den sozialen Medien positiv über ihre Produkte geäußert haben, oder eine Strafverfolgungsbehörde, die mithilfe von Verkehrsüberwachungsdaten nach einem Verdächtigen sucht.
Dies ist der Hauptgrund, warum Stream-Verarbeitungssysteme wie Spark Streaming die Zukunft der AnalyseAnalytics bezieht sich auf den Prozess des Sammelns, Messen und analysieren Sie Daten, um wertvolle Erkenntnisse zu gewinnen, die die Entscheidungsfindung erleichtern. In verschiedenen Bereichen, wie Business, Gesundheit und Sport, Analysen können Muster und Trends erkennen, Prozesse optimieren und Ergebnisse verbessern. Der Einsatz fortschrittlicher Werkzeuge und statistischer Techniken ist unerlässlich, um Daten in anwendbares und strategisches Wissen umzuwandeln.... in Echtzeit. Es besteht auch ein wachsender Bedarf, sowohl ruhende als auch bewegte Daten zu analysieren, um Anwendungen zu steuern, das macht Systeme wie Spark, sie können beides, noch attraktiver und leistungsfähiger sein. Es ist ein System für alle Jahreszeiten von Big Data.
Sie erfahren, wie Spark Streaming nicht nur die vertraute Spark-API intakt hält, aber auch, unter der Haube, verwendet RDD für die Speicherung und Fehlertoleranz. Damit können Spark-Profis von Anfang an in die Welt des Streamings einsteigen. In diesem Sinne, gehen wir direkt dazu.
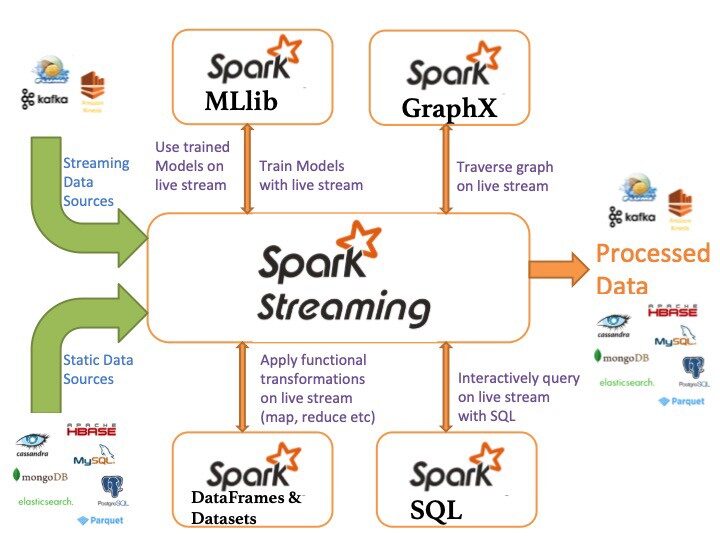
Einführung in Spark-Streaming | von Harshit Agarwal | Halb
Inhaltsverzeichnis
- Apache SparkApache Spark ist eine Open-Source-Datenverarbeitungs-Engine, die die schnelle und effiziente Analyse großer Informationsmengen ermöglicht. Sein Design basiert auf dem Speicher, Dies optimiert die Leistung im Vergleich zu anderen Batch-Verarbeitungstools. Spark wird häufig in Big-Data-Anwendungen verwendet, Maschinelles Lernen und Echtzeitanalysen, Dank seiner Benutzerfreundlichkeit und...
- Apache Spark-Ökosystem
- Spark-Streaming: DStreams
- Spark-Streaming: Übertragungskontext
- Beispiel: Wortzahl
- Spark-Streaming: Fenster
- Ein Fenster basierend auf: Wortzahl
- ein (effizienter) fensterbasiert: Wortzahl
- Spark-Streaming: Ausgangsoperationen
Apache Spark
Apache Spark ist eine vereinheitlichte Computing-Engine und eine Reihe von Bibliotheken für die parallele Datenverarbeitung auf Computerclustern. Zum Zeitpunkt des Schreibens dieses Artikels, Spark ist die am weitesten entwickelte Open-Source-Engine für diese Aufgabe, Dies macht es zu einem Standardwerkzeug für jeden Entwickler oder Datenwissenschaftler, der sich für Big Data interessiert.
Spark unterstützt mehrere weit verbreitete Programmiersprachen (Python, Java, Skala y R), enthält Bibliotheken für verschiedene Aufgaben von SQL über Streaming bis hin zu Machine Learning, und läuft überall, von einem Laptop bis zu einem ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... von tausenden Servern. Dies macht es zu einem einfachen System für den Einstieg und die Skalierung auf Big Data-Verarbeitung oder unglaublich großen Umfang.. Nachfolgend sind einige der Funktionen von Spark aufgeführt:
-
Schnelle Allzweck-Engine für umfangreiche Datenverarbeitung
-
Spark kann effizient unterstützen mehr Arten von Berechnungen
-
Kann lesen / Schreiben Sie auf jedes Hadoop-kompatible System (zum Beispiel, HDFSHDFS, o Verteiltes Hadoop-Dateisystem, Es ist eine Schlüsselinfrastruktur für die Speicherung großer Datenmengen. Entwickelt für die Ausführung auf gängiger Hardware, HDFS ermöglicht die Datenverteilung über mehrere Knoten, Sicherstellung einer hohen Verfügbarkeit und Fehlertoleranz. Seine Architektur basiert auf einem Master-Slave-Modell, wobei ein Master-Knoten das System verwaltet und Slave-Knoten die Daten speichern, Erleichterung der effizienten Verarbeitung von Informationen..)
- Geschwindigkeit: In-Memory-Datenspeicherung für sehr schnelle iterative Abfragen
-
Das System ist auch effizienter als Karte verkleinernMapReduce ist ein Programmiermodell, das entwickelt wurde, um große Datensätze effizient zu verarbeiten und zu generieren. Unterstützt von Google, Bei diesem Ansatz wird die Arbeit in kleinere Aufgaben aufgeteilt, die auf mehrere Knoten in einem Cluster verteilt sind. Jeder Knoten verarbeitet seinen Teil und dann werden die Ergebnisse kombiniert. Mit dieser Methode können Sie Anwendungen skalieren und große Informationsmengen verarbeiten, in der Welt von Big Data von grundlegender Bedeutung zu sein.... für komplexe Anwendungen, die auf der Festplatte ausgeführt werden
-
bis um 40 mal schneller als Hadoop
-
Nehmen Sie Daten aus vielen Quellen auf: Kafka, Twitter, HDFS, Sockets TCP
-
Ergebnisse können an Dateisysteme gesendet werden, Datenbanken, Live-Panels, aber nicht nur
-
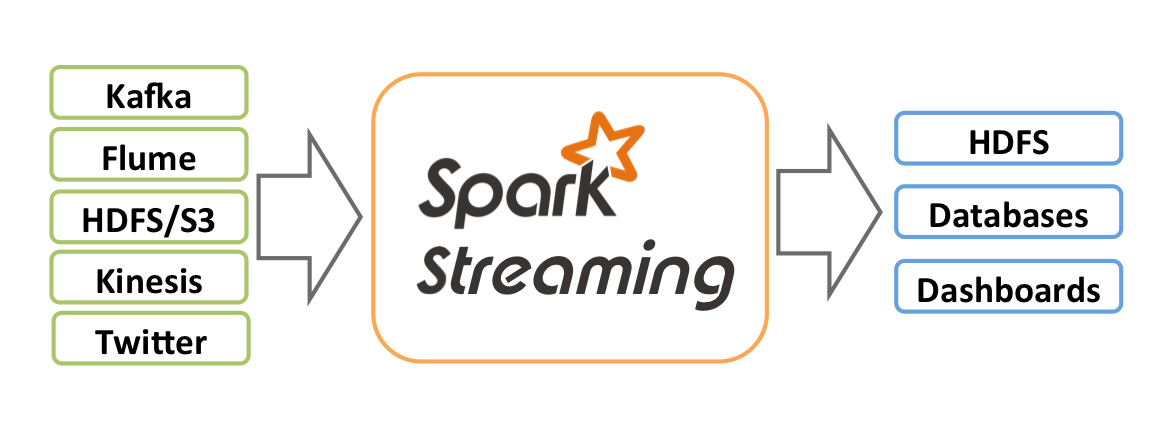
Apache Spark-Ökosystem
Im Folgenden sind die Komponenten des Apache Spark-Ökosystems aufgeführt:
- Funkenkern: grundlegende Spark-Funktionalität (Aufgabenplanung, Speicherverwaltung, Absturzwiederherstellung, Interaktion von Speichersystemen).
-
Spark-SQL: Paket, um mit strukturierten Daten zu arbeiten, die über SQL und HiveQL abgefragt werden
-
Spark-Streaming: eine Komponente, die die Verarbeitung von Live-Datenströmen ermöglicht (zum Beispiel, Protokolldateien, Statusaktualisierungsmeldungen)
- MLLib: MLLib ist eine Bibliothek für maschinelles Lernen wie Mahout. Es baut auf Spark auf und kann viele maschinelle Lernalgorithmen unterstützen..
- GraphX: Für Diagramme und Diagrammberechnungen, Spark verfügt über eine eigene Grafikberechnungs-Engine, namens GraphX. Es ähnelt anderen weit verbreiteten Graphverarbeitungswerkzeugen oder Datenbanken, wie Neo4j, Giraffe und viele andere verteilte Graphdatenbanken.
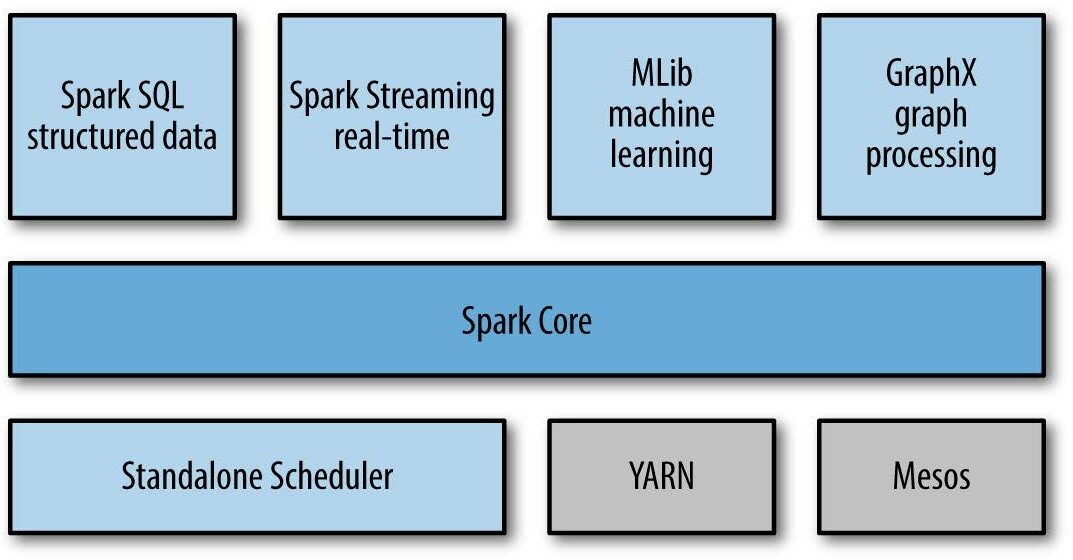
Spark-Streaming: Abstraktionen
Spark Streaming hat eine Micro-Batch-Architektur wie folgt:
-
behandelt den Stream als eine Reihe von Datenbatches
-
In regelmäßigen Zeitabständen werden neue Chargen erstellt.
-
die Größe der Zeitintervalle heißt Stapel Intervall
-
Das Batch-Intervall liegt normalerweise zwischen 500 ms und mehrere Sekunden
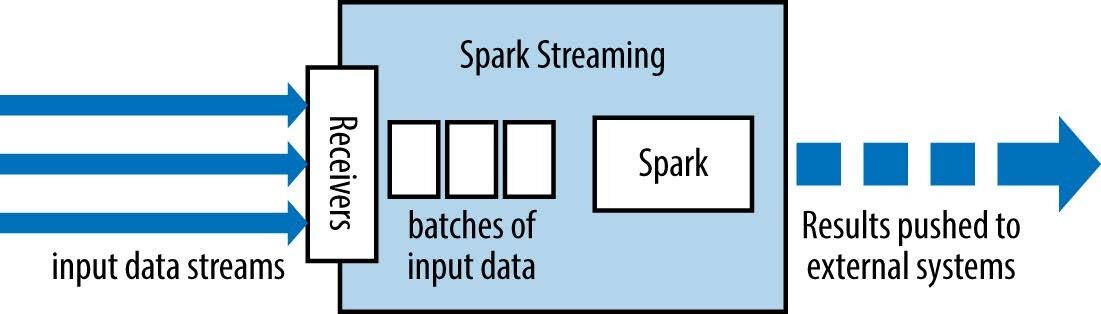
Der Reduktionswert jedes Fensters wird inkrementell berechnet.
diskretisierte Folge (DStream)
diskretisierter Strom Ö DStream ist die grundlegende Abstraktion, die von Spark Streaming bereitgestellt wird. Stellt einen kontinuierlichen Datenfluss dar, entweder der von der Quelle empfangene Eingabedatenstrom oder der verarbeitete Datenstrom, der durch Transformieren des Eingabestroms erzeugt wird. Im Inneren, ein DStream wird durch eine fortlaufende Reihe von RDD dargestellt, Dies ist Sparks Abstraktion eines verteilten, unveränderlichen Datensatzes (beobachten Spark-Programmieranleitung für mehr Details). Jedes RDD in einem DStream enthält Daten aus einem bestimmten Intervall.
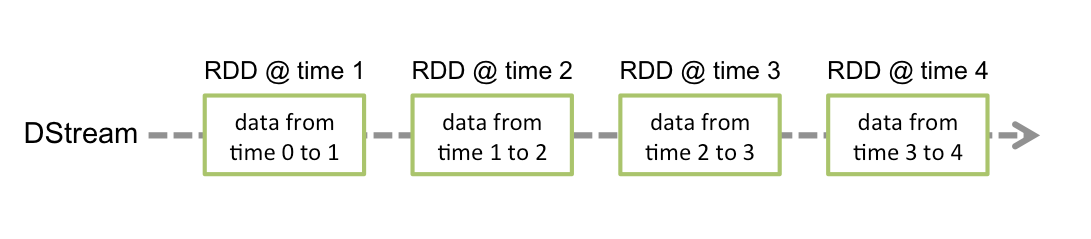
- RDD-Transformationen werden von der Spark-Engine berechnet
-
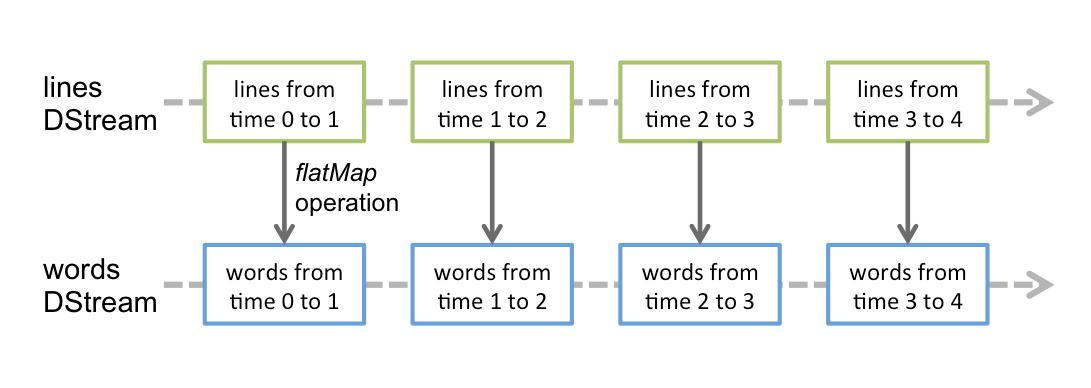
DStream-Operationen verbergen die meisten dieser Details
-
Alle Operationen, die auf einen DStream angewendet werden, werden in Operationen auf den zugrunde liegenden RDDs übersetzt..
-
Der Reduktionswert jedes Fensters wird inkrementell berechnet.
Spark-Streaming: Übertragungskontext
Es ist der Haupteinstiegspunkt für die Spark-Streaming-Funktionalität. Stellt Methoden bereit, die zum Erstellen verwendet werden DStreams von mehreren Eingangsquellen. Streaming Spark kann durch Angabe einer Spark-Master-URL und eines Anwendungsnamens erstellt werden, oder von einer Konfiguration org.apache.spark.SparkConf, oder seit einem bestehenden org.apache.spark.SparkContext. Auf den zugehörigen SparkContext kann über zugegriffen werden context.sparkContext.
Nach dem Erstellen und Transformieren von DStreams, Streaming Computing kann mit gestartet und gestoppt werden context.start() Ja, beziehungsweise. context.awaitTermination() ermöglicht dem aktuellen Thread, auf die Kontextbeendigung durch zu warten stop() oder für eine Ausnahme.
So führen Sie eine SparkStreaming-Anwendung aus, Wir müssen StreamingContext definieren. SparkContext ist auf Streaming-Anwendungen spezialisiert.
Der Streaming-Kontext in Java kann wie folgt definiert werden:
JavaStreamingContext ssc = neuer JavaStreamingContext(sparkConf, batchInterval);
wo:
-
Maestro ist eine Spark-Cluster-URL, Mesos oder GARNYARN ist ein Paketmanager für JavaScript, der die effiziente Installation und Verwaltung von Abhängigkeiten in Entwicklungsprojekten ermöglicht. Unterstützt von Facebook, Es zeichnet sich durch seine Schnelligkeit und Sicherheit im Vergleich zu anderen Managern aus. YARN verwendet ein Cache-System, um Installationen zu optimieren, und stellt eine Sperrdatei bereit, um die Konsistenz der Abhängigkeitsversionen in verschiedenen Entwicklungsumgebungen zu gewährleisten....; um Ihren Code im lokalen Modus auszuführen, benutzen „lokal[K]„wo K> = 2 stellt die Parallelität dar
-
App Name ist der Name Ihrer Anwendung
-
Batch-Intervall Zeitintervall (in Sekunden) jeder Charge
einmal gebaut, bieten zwei Arten von Operationen an:
Einige Beispiele sind: Karte (), Filter () und ReduceByKey ()
-
-
zustandsbehaftete Transformationen: verwendet Daten aus früheren Chargen, um die Ergebnisse der aktuellen Charge zu berechnen. Schiebefenster beinhalten, Statusverfolgung im Laufe der Zeit, etc.
-
Beachten Sie, dass ein Stream-Kontext nur einmal gestartet werden kann und gestartet werden sollte, nachdem wir alle DStreams und Ausgabeoperationen eingerichtet haben.
Grundlegende Datenquellen
Die grundlegenden Spark Streaming-Datenquellen sind unten aufgeführt:
- Datei-Streams: Wird zum Lesen von Daten aus Dateien auf jedem Dateisystem verwendet, das die HDFS-API unterstützt (nämlich, HDFS, S3, NFS, etc.), Sie können einen DStream wie erstellen:
... = streamingContext.fileStream<...>(Verzeichnis);
- Streams basierend auf benutzerdefinierten Empfängern: DStreams können mit Datenströmen erstellt werden, die über benutzerdefinierte Empfänger empfangen werden, Erweiterung der Receiver-Klasse
... = streamingContext.queueStream(queueOfRDDs)
- RDD-Warteschlange als Stream: So testen Sie eine Spark Streaming-Anwendung mit Testdaten, Sie können auch einen DStream basierend auf einer RDD-Warteschlange erstellen, mit
... = streamingContext.queueStream(queueOfRDDs)
Die meisten Transformationen haben die gleiche Syntax wie auf RDDs angewendet.
-
Transformation
Sinn
Karte (Funk)
Gibt einen neuen DStream zurück, indem jedes Element des Quell-DStream durch eine func-Funktion geleitet wird.
flachKarte (Funk)
ähnlich der Karte, aber jedes Eingangselement kann zugewiesen werden 0 oder mehr Ausgabeelemente.
Filter (Funk)
Geben Sie einen neuen DStream zurück, der nur Datensätze aus dem Quell-DStream auswählt, in denen func true zurückgibt.
Union (anderer Stream)
Gibt einen neuen DStream zurück, der die Vereinigung der Quellelemente DStream und otherDStream enthält.
beitreten (eine andere Strömung)
Wenn zwei Paar DStreams aufgerufen werden (K, V) Ja (K, W), Gibt einen neuen DStream von (K, (V, W)) Paare mit allen Elementpaaren für jede Taste.
Beispiel: Wortzahl
SparkConf sparkConf = neue SparkConf()
.setMaster("lokal[2]").setAppName("WordCount");
JavaStreamingContext ssc = ...
JavaReceiverInputDStream<Zeichenfolge> lines = ssc.socketTextStream( ... );
JavaDStream<Zeichenfolge> words = lines.flatMap(...);
JavaPairdStream<Zeichenfolge, Ganze Zahl> wordCounts = words
                                             .mapToPair(s -> neu Tuple2<>(S, 1))
                                             .reduceByKey((i1, i2) -> i1 + i2);

wordCounts.print();
Spark-Streaming: Fenster
Die einfachste Fensterfunktion ist ein Fenster, mit dem Sie einen neuen DStream erstellen können, berechnet durch Anwenden der ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Fensteroperationen auf den alten DStream. Sie können jede der DSTREAM-Operationen im neuen Stream verwenden, So erhalten Sie die Flexibilität, die Sie sich wünschen.
Berechnungen in Fenstern ermöglichen es Ihnen, Transformationen über ein gleitendes Datenfenster anzuwenden. Jeder Fenstervorgang muss zwei Parameter angeben:
- Fenster lang
- Die Dauer des Fensters in Sekunden.
- Gleiten Intervall
- Das Intervall, in dem der Fenstervorgang in Sekunden ausgeführt wird.
- Diese Parameter müssen ein Vielfaches des Batchintervalls sein.
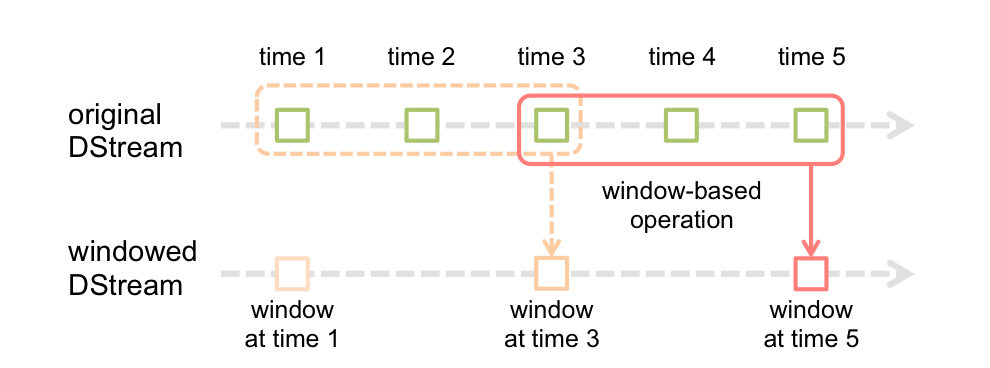
Fenster(FensterLänge, slideInterval)
Gibt einen neuen DStream zurück, der basierend auf Batches im Fenster berechnet wird..
...
JavaStreamingContext ssc = ...
JavaReceiverInputDStream<Zeichenfolge> Linien = ...
JavaDStream<Zeichenfolge> linesInWindow =
lines.window(WINDOW_SIZE, SLIDING_INTERVAL);
JavaPairdStream<Zeichenfolge, Ganze Zahl> wordCounts = linesInWindow.flatMap(SPLIT_LINE)
.mapToPair(s -> neu Tuple2<>(S, 1))
.reduceByKey((i1, i2) -> i1 + i2);
- reduceByWindow (Funk, InvFunc, FensterLänge, slideInterval)
- Gibt eine neue Sequenz eines einzelnen Elements zurück., erstellt durch Hinzufügen von Elementen in der Sequenz während eines gleitenden Intervalls mit Funk (die assoziativ sein müssen).
- Der Reduktionswert jedes Fensters wird inkrementell berechnet.
- reduceByKeyAndWindow (Funk, InvFunc, FensterLänge, slideInterval)
- Beim Aufrufen eines DStream von (K, V) Paare, Gibt einen neuen DStream von (K, V) Paare, bei denen die Werte für jeden Schlüssel mit der angegebenen Reduktionsfunktion addiert werden Funk über Grundstücke in einem Schiebefenster.
So führen Sie diese Transformationen durch, Wir müssen ein Verzeichnis von Checkpoints definieren
Fensterbasiert: Wortzahl
...
JavaPairdStream<Zeichenfolge, Ganze Zahl> wordCountPairs = ssc.socketTextStream(...)
.flachKarte(x -> Arrays.asList(SPACE.split(x)).Iterator())
.mapToPair(s -> neu Tuple2<>(S, 1));
JavaPairdStream<Zeichenfolge, Ganze Zahl> wordCounts = wordCountPairs
.reduceByKeyAndWindow((i1, i2) -> i1 + i2, WINDOW_SIZE, SLIDING_INTERVAL);
wordCounts.print();
wordCounts.foreachRDD(neue SaveAsLocalFile());
ein (effizienter) fensterbasiert: Wortzahl
In einer effizienteren Version, Der Reduktionswert jedes Fensters wird inkrementell berechnet.
Beachten Sie, dass Checkpoints aktiviert sein müssen, um diesen Vorgang verwenden zu können.
...
ssc.checkpoint(LOCAL_CHECKPOINT_DIR);
...
JavaPairdStream<Zeichenfolge, Ganze Zahl> wordCounts = wordCountPairs.reduceByKeyAndWindow(
(i1, i2) -> i1 + i2,
(i1, i2) -> i1 - i2, WINDOW_SIZE, SLIDING_INTERVAL);
Spark-Streaming: Ausgangsoperationen
Ausgabeoperationen ermöglichen es, die Daten eines DStreams an externe Systeme wie eine DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... oder ein Dateisystem zu senden
-
Ausgangsbetrieb
Sinn
Drucken()
Druckt die ersten zehn Elemente jedes Datenbatches in einem DStream auf dem KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... der Controller, der die Anwendung ausführt.
saveAsTextFiles (Präfix, [Suffix])
Speichern Sie den Inhalt dieses DStream als Textdateien. Der Dateiname in jedem Stapelintervall wird basierend auf dem Präfix generiert.
saveAsHadoopFiles (Präfix, [Suffix])
Speichern Sie den Inhalt dieses DStream als Hadoop-Dateien.
saveAsObjectFiles (Präfix, [Suffix])
Speichern Sie den Inhalt dieses DStream als SequenceFiles von serialisierten Java-Objekten.
foreachRDD (Funk)
Allgemeiner Ausgabeoperator, der eine Funktion anwendet, Funk, zu jedem aus der Sequenz erzeugten RDD.
Online-Referenzen
• Spark-Dokumentation
• Spark-Dokumentation
Fazit
Es sollte klar sein, dass Spark Streaming eine leistungsstarke Möglichkeit darstellt, Streaming-Anwendungen zu schreiben. Es ist einfach und aus technischer Sicht äußerst nützlich, einen Batch-Job, den Sie bereits ausführen, in einen Streaming-Job umzuwandeln, ohne dass Code geändert werden muss, wenn dieser Job eng mit dem Rest Ihrer Streaming-Anwendung interagieren soll.
Ich empfehle Ihnen, die folgenden Data-Engineering-Ressourcen zu konsultieren, um Ihr Wissen zu verbessern:
Wenn Ihnen der Artikel gefallen hat, Hinterlasse einen Kommentar im Kommentarbereich unten.





