
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Daten sind überall in der heutigen Datenwelt und wir können nur davon profitieren, wenn wir Informationen aus den Daten extrahieren können. Die Datenvisualisierung ist der visuell ansprechendste Aspekt der Datenanalyse, da wir mit den Daten interagieren können. Es ist diese magische Technik, um mit einem einzigen Blick Informationen an große Personengruppen zu übermitteln und aus Daten interessante Geschichten zu erstellen.. Pandas ist eines der beliebtesten und am weitesten verbreiteten Datenanalysetools in Python. Es hat auch eine integrierte Plotting-Funktion für Proben. Aber trotzdem, wenn es um interaktive Visualisierung geht, Python-Benutzer, die keine Front-End-Engineering-Kenntnisse haben, können einige Herausforderungen haben, wie viele Bibliotheken, als D3, chart.js, erfordert etwas JavaScript-Kenntnisse. Plotly und Twins sind an dieser Stelle hilfreich.
Wenn große Datenmengen vorhanden sind und Unternehmen Schwierigkeiten haben, kritische Informationen daraus zu extrahieren, Datenvisualisierung spielt eine wichtige Rolle bei wichtigen Geschäftsentscheidungen.
Plotly ist eine auf d3.js aufbauende Grafikbibliothek, die dank einer weiteren Bibliothek namens Cufflinks direkt mit Pandas-Datenrahmen verwendet werden kann.
In diesem kurzen Tutorial zeigen wir Ihnen, wie Sie interaktive Plotly-Diagramme mit Pandas-Datenrahmen verwenden.. Um die Dinge einfach zu halten, Wir werden Jupyter Notebook verwenden (installiert mit Anaconda Distribution mit Python) und der berühmte Titanic-Datensatz.
Datenvisualisierung in Python
Nach Abschluss der Datenbereinigung und -manipulation, Der nächste Schritt im Datenanalyseprozess besteht darin, aussagekräftige Erkenntnisse und Schlussfolgerungen aus den Daten zu ziehen, was kann man mit grafiken und tabellen erreichen. Python hat mehrere Bibliotheken, die für diesen Zweck verwendet werden können. Wie gewöhnlich, wir werden nur über die beiden Bibliotheken matplotlib und seaborn unterrichtet. Diese Bibliotheken enthalten Werkzeuge zum Erstellen von Liniendiagrammen, Kreisdiagramme, Balkendiagramme, BoxplotsBox-Diagramme, Auch bekannt als Box- und Whisker-Diagramme, sind statistische Werkzeuge, die die Verteilung eines Datensatzes darstellen. Diese Diagramme zeigen den Median, Quartile und Ausreißer, Ermöglicht die Visualisierung von Datenvariabilität und -symmetrie. Sie sind nützlich für den Vergleich zwischen verschiedenen Gruppen und in der explorativen Analyse, So lassen sich Trends und Muster in den Daten leichter erkennen.... y una variedad de otros diagramas. Sie fragen sich wahrscheinlich, warum wir andere Bibliotheken für die Datenvisualisierung brauchen, wenn wir bereits matplotlib und seaborn haben. Als ich zum ersten Mal von der Handlung und den Zwillingen hörte, Ich hatte die gleiche Frage im Kopf.
Handlung
Die neueste Veröffentlichung von Plotly war 5.1.0, während der mit den Zwillingen war 0.17.5. Weil ältere Versionen von Manschettenknöpfen nicht mit neu veröffentlichten Plotting-Versionen kompatibel sind, Es ist wichtig, beide Pakete gleichzeitig zu aktualisieren oder kompatible Versionen zu finden. In Anaconda-Eingabeaufforderung, Führen Sie die folgenden Befehle aus, um Plotly zu installieren (o de Terminal selbst verwendet OS oder Ubuntu)
Plotly ist eine Open-Source- und Grafikbibliothek, die interaktives Plotten ermöglicht. Python, R, MATLAB, Arduino und REST, unter anderen, gehören zu den von der Bibliothek unterstützten Programmiersprachen.
Cufflink ist eine Python-Bibliothek, die Plotly und Pandas verbindet, Ermöglicht es uns, Grafiken direkt auf Datenrahmen zu zeichnen. Es ist im Wesentlichen ein Plugin.
Diagrammdiagramme sind interaktiv, wodurch wir über die Werte scrollen können, Vergrößern und verkleinern Sie Diagramme und identifizieren Sie Ausreißer im Datensatz. Die Matplotlib und Seaborn Letters, Zweitens, sie sind statisch; Wir können das Bild nicht vergrößern oder verkleinern, und alle Werte in der Tabelle sind nicht detailliert. Das wichtigste Feature von Plotly ist, dass wir dynamische Webgrafiken direkt aus Python erstellen können, was ist mit matplotlib nicht möglich. Wir können auch interaktive Grafiken und Animationen aus geografischen Daten erstellen, Wissenschaftler, Statistiken und Finanzen mit Plotly.
Auf PC installieren „Handlung „ Ja „Zwillinge„ eine Anaconda-Umgebung verwenden
conda install -c plotly plotly
conda install -c conda-forge manschettenknöpfe-py
o mit pip
pip install plotly --upgrade
pip install Manschettenknöpfe --upgrade
Laden von Bibliotheken
Pandas-Bibliotheken, Plotly und Manschettenknöpfe werden zuerst geladen. Denn plotly ist eine Online-Plattform, requiere una credencial de inicio de SitzungDas "Sitzung" Es ist ein Schlüsselbegriff im Bereich der Psychologie und Therapie. Bezieht sich auf ein geplantes Treffen zwischen einem Therapeuten und einem Klienten, wo Gedanken erforscht werden, Emotionen und Verhaltensweisen. Diese Sitzungen können in Länge und Häufigkeit variieren, und ihr Hauptzweck ist es, persönliches Wachstum und Problemlösung zu erleichtern. Die Wirksamkeit der Sitzungen hängt von der Beziehung zwischen dem Therapeuten und dem Therapeuten ab.. para usarla en línea. Wir werden in diesem Artikel den Offline-Modus verwenden, das reicht für Jupyter Notebook.
#Pandas importieren
Pandas als pd importieren
#Importieren von Plotly und Manschettenknöpfen im Offline-Modus
Manschettenknöpfe als cf . importieren
plotly.offline importieren
cf.go_offline()
cf.set_config_file(offline=Falsch, world_readable=Wahr)
Datensatz laden
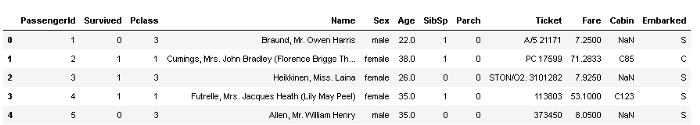
Wir haben erwähnt, dass wir den Titanic-Datensatz verwenden werden, was kannst du davon bekommen kaggle_link. Es wird nur die Datei train.csv verwendet.
df=pd.read_csv("zug.csv")
df.kopf()
Histogramm
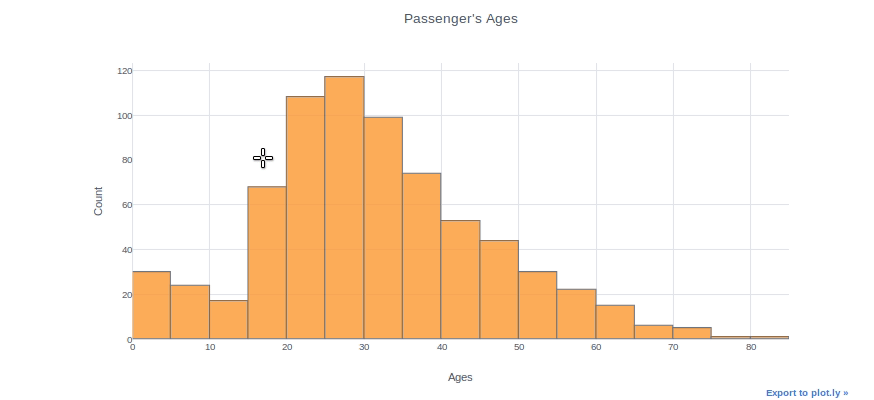
Das HistogrammeHistogramme sind grafische Darstellungen, die die Verteilung eines Datensatzes darstellen. Sie werden konstruiert, indem der Wertebereich in Intervalle unterteilt wird, Ö "Behälter", und zählen, wie viele Daten in jedem Intervall fallen. Diese Visualisierung ermöglicht es Ihnen, Muster zu erkennen, Trends und Variabilität von Daten effektiv, Erleichterung statistischer Analysen und fundierter Entscheidungsfindung in verschiedenen Disziplinen.... se pueden utilizar para inspeccionar las distribuciones de una característica, als die Funktion „Alter“ in diesem Fall. Wir verwenden einfach die (Datenrahmen["Spaltenname"]) um eine Spalte auszuwählen und dann die iplot-Funktion hinzuzufügen. Als Beispiel, Wir können die Größe des Containers angeben, das Thema, der Titel und die Namen der Achsen. Mit dem Befehl „Hilfe (df.iplot)“, puede ver todos los ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... del parámetro iplot.
df["Alter"].iplot(Art="Histogramm", Behälter=20, Thema="Weiß", Titel="Passenger's Ages",xTitel="Alter", yTitel ="Zählen")
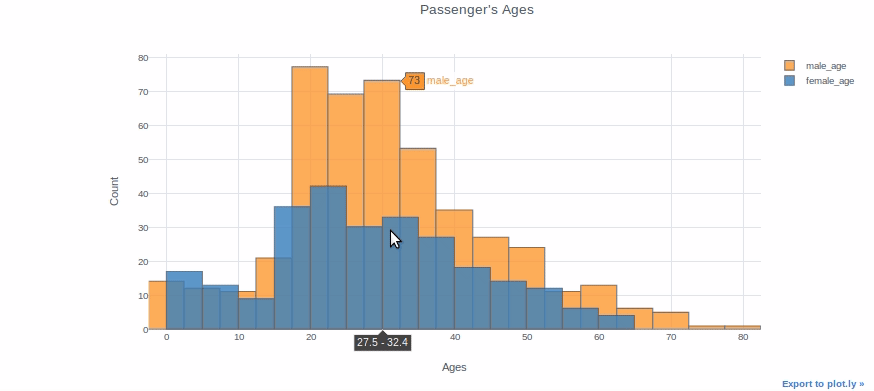
Sie können zwei verschiedene Verteilungen als zwei verschiedene Spalten darstellen, wenn Sie sie vergleichen möchten. Zum Beispiel, Wir werden das Alter der männlichen und weiblichen Passagiere auf derselben Parzelle aufzeichnen.
df["männlich_alter"]=df[df["Sex"]=="männlich"]["Alter"]
df["weibliches_alter"]=df[df["Sex"]=="weiblich"]["Alter"]df[["männlich_alter","weibliches_alter"]].iplot(Art="Histogramm", Behälter=20, Thema="Weiß", Titel="Passenger's Ages",
         xTitel="Alter", yTitel ="Zählen")
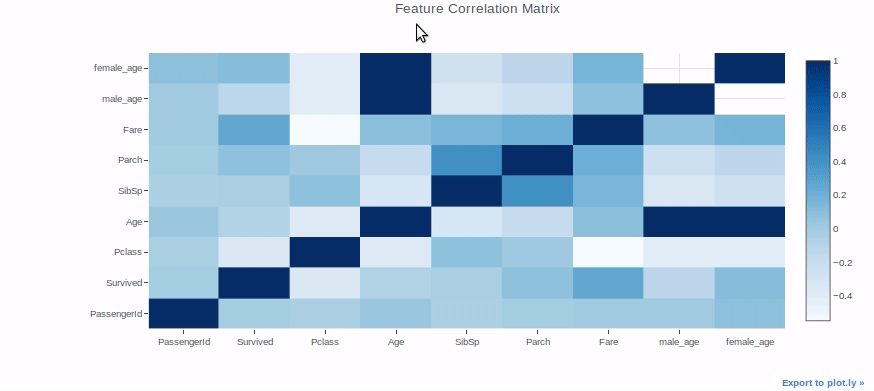
Heatmapein "Heatmap" ist eine grafische Darstellung, die Farben verwendet, um die Dichte von Daten in einem bestimmten Bereich anzuzeigen. Häufig in der Datenanalyse verwendet, Marketing und Verhaltensstudien, Diese Art der Visualisierung ermöglicht es Ihnen, Muster und Trends schnell zu erkennen. Durch chromatische Variationen, Heatmaps erleichtern die Interpretation großer Informationsmengen, dabei helfen, fundierte Entscheidungen zu treffen....
Heatmaps können für eine Vielzahl von Zwecken verwendet werden, Wir werden sie jedoch verwenden, um die Korrelation zwischen Merkmalen in einem Datensatz als Beispiel zu überprüfen.
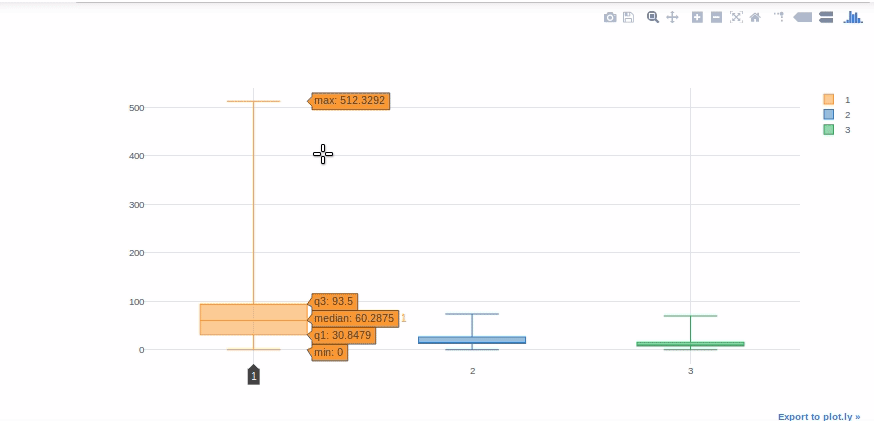
Box-Plot
Boxplots sind äußerst nützlich, um Schiefe in Daten schnell zu interpretieren, Ausreißer und Quartilbereiche. Wir verwenden nun einen Boxplot, um die Verteilung von zu zeigen „Rate“ für jede Titanic-Klasse.
#Wir erhalten Hilfe von Pivot-Tabellen, um Tarifwerte in verschiedenen Spalten für jede Klasse zu erhalten.
df[['Pclass', 'Fare']].Drehpunkt(Spalten="PKlasse", Werte="Tarif").iplot(kind='box')
StreudiagrammEin Streudiagramm ist eine visuelle Darstellung, die die Beziehung zwischen zwei numerischen Variablen mithilfe von Punkten auf einer kartesischen Ebene zeigt. Jede Achse stellt eine Variable dar, und die Position jedes Punktes gibt seinen Wert in Bezug auf beide an.. Diese Art von Diagramm ist nützlich, um Muster zu erkennen, Korrelationen und Trends in den Daten, Erleichterung der Analyse und Interpretation quantitativer Zusammenhänge....
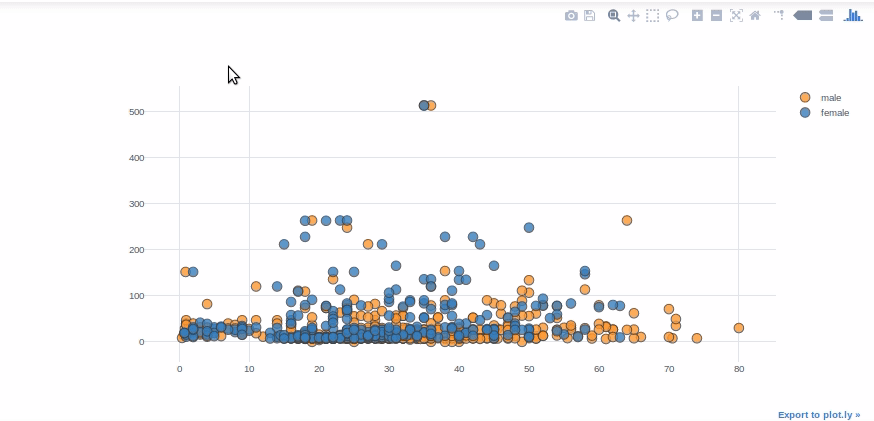
Streudiagramme werden häufig verwendet, um die Beziehung zwischen zwei numerischen Variablen zu visualisieren. Für Variablen „Rate“ Ja „Alter“, Wir werden Streudiagramme verwenden. "Kategorien" ermöglicht es uns, die Variablen eines ausgewählten Merkmals in verschiedenen Farben anzuzeigen (Geschlecht der Passagiere in diesem Fall).
df.iplot(Art="streuen", Thema="Weiß",x="Alter",y ="Tarif",
            Kategorien="Sex")
eine kurze Erinnerung: der Parameter „Kategorien“ muss ein String oder eine Spalte vom Typ float64 sein. Zum Beispiel, am Beispiel des Blasendiagramms, sollte Spalte konvertieren „Überlebt“ vom Typ integer in float64 oder string.
Blasendiagramm
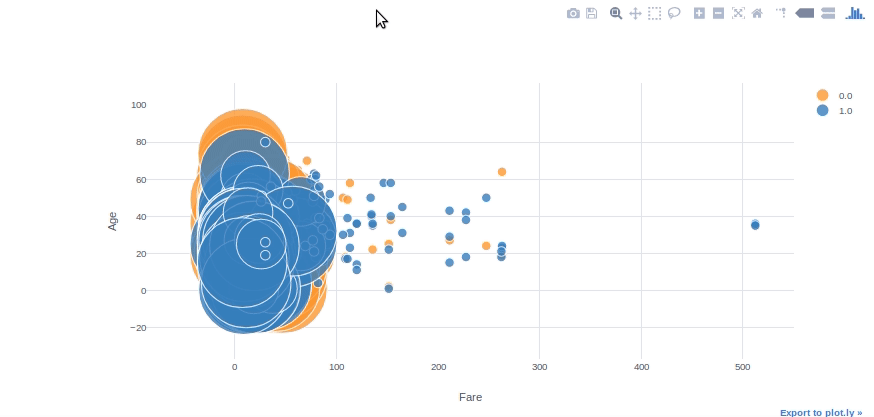
Wir können Blasendiagramme verwenden, um mehrere Variablenbeziehungen gleichzeitig zu sehen. Mit den Parametern von „Kategorien“ Ja „Größe“ in der Grafik, Wir können die Unterkategorien für Farbe und Größe einfach anpassen. Mit dem Parameter „Text“, wir können auch die schwebende Textspalte angeben.
#Konvertieren der überlebenden Spalte in float64, um sie in Plotly verwenden zu können
df[['Survived']] = df[['Survived']].astyp('float64', kopieren=Falsch)df.iplot(kind='bubble', x="Tarif",y ="Alter",Kategorien="Überlebt", Größe="PKlasse", text="Name", xTitel="Tarif", yTitel ="Alter")
BalkengrafikDas Balkendiagramm ist eine visuelle Darstellung von Daten, die rechteckige Balken verwendet, um Vergleiche zwischen verschiedenen Kategorien anzuzeigen. Jeder Balken stellt einen Wert dar, und seine Länge ist proportional zu ihm. Diese Art von Diagramm ist nützlich, um Trends zu visualisieren und zu analysieren, Erleichterung der Interpretation quantitativer Informationen. Es ist in verschiedenen Disziplinen weit verbreitet, wie z.B. Statistiken, Marketing und Forschung, Aufgrund seiner Einfachheit und Effektivität....
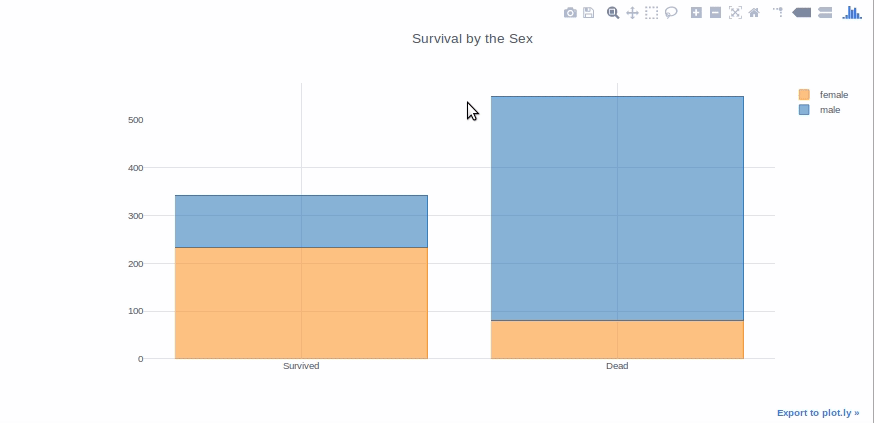
Balkendiagramme eignen sich gut, um Daten aus verschiedenen Gruppen darzustellen, die miteinander verglichen werden. Was ist mehr, kann gestapelt verwendet werden, um verschiedene variable Effekte zu zeigen. Wir werden ein Balkendiagramm erstellen, um die Anzahl der überlebenden Passagiere nach Geschlecht anzuzeigen.
überlebt_sex = df[df['Survived']==1]['Sex'].value_counts()
dead_sex = df[df['Survived']==0]['Sex'].value_counts()
df1 = pd.DataFrame([überlebt_sex,toter_sex])
df1.index = ['Survived','Tot']
df1.iplot(kind='bar',barmode="Stapel", Titel="Überleben durch das Geschlecht")
Ich habe versucht alles so einfach wie möglich zu erklären. Ich hoffe, es ist für Neulinge einfacher, die Handlung zu verstehen.
Plotly bietet auch wissenschaftliche Diagramme, 3D-Grafik, Karten und Animationen. Besuchen Sie die Dokumentation von plotly hier für mehr Details.
Werfen Sie einen Blick auf EDA – Explorative Datenanalyse mit Python Pandas und SQL ANKLICKEN ZUM LESEN
EndNote
Danke fürs Lesen!
Ich hoffe, Ihnen hat der Artikel gefallen und Sie haben Ihr Wissen erweitert.
Zögern Sie nicht, mich zu kontaktieren Über Email
Alles was nicht erwähnt wurde oder du deine Gedanken teilen möchtest? Fühlen Sie sich frei, unten einen Kommentar zu hinterlassen und ich melde mich bei Ihnen.
Über den Autor
Hardikkumar M. Dhaduk
Daten Analyst | Spezialist für digitale Datenanalyse | Student der Datenwissenschaften
Verbinde dich mit mir auf Linkedin
Verbinde dich mit mir auf Github
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





