
Dieser Beitrag wurde im Rahmen der . veröffentlicht Data Science Blogathon.
Überblick
Einführung
Apache SparkApache Spark ist eine Open-Source-Datenverarbeitungs-Engine, die die schnelle und effiziente Analyse großer Informationsmengen ermöglicht. Sein Design basiert auf dem Speicher, Dies optimiert die Leistung im Vergleich zu anderen Batch-Verarbeitungstools. Spark wird häufig in Big-Data-Anwendungen verwendet, Maschinelles Lernen und Echtzeitanalysen, Dank seiner Benutzerfreundlichkeit und... es un marco de procesamiento de datos que puede realizar rápidamente tareas de procesamiento en conjuntos de datos muy grandes y además puede repartir tareas de procesamiento de datos en múltiples computadoras, entweder allein oder in Verbindung mit anderen verteilten Computertools. Es ist eine ultraschnelle Unified Analytics-Engine für Big Data und maschinelles Lernen.
So unterstützen Sie Python mit Spark, Apache Spark Community veröffentlicht ein Tool, PySpark. Mit PySpark, Sie können mit RDD in der Programmiersprache Python arbeiten.
Spark-Komponenten sind:
- Funkenkern
- Spark-SQL
- Spark-Streaming
- Spark MLlib
- GraphX
- Spark R
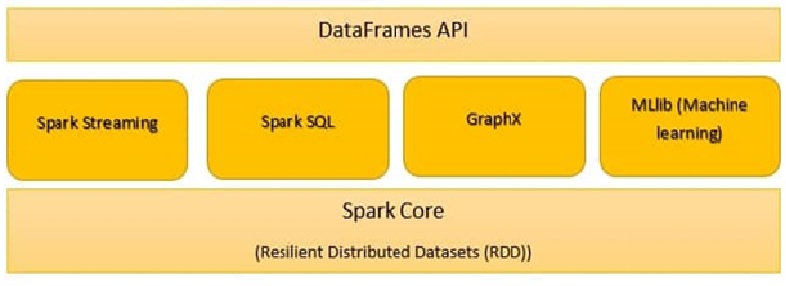
Funkenkern
Alle von Apache Spark bereitgestellten Funktionen konzentrieren sich auf die Oberseite von Spark Core. Verwaltung aller E-Funktionalitäten / Essentielles S. Wird für die Aufgabenverteilung und Fehlerbehebung verwendet. Spark Core ist mit einer speziellen Sammlung namens RDD (Ausfallsicherheit verteilter Datensatz). RDD gehört zu Sparks Abstraktionen. Spark RDD maneja la partición de datos en todos los nodos de un ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen..... Behält sie als einzelne Einheit im Cluster-Speicherpool. Es gibt zwei Operationen, die in RDD ausgeführt werden:
Transformation: Es ist eine Funktion, die neue RDDs aus vorhandenen RDDs erzeugt.
Aktion: In Transformation, RDDs werden gegeneinander erstellt. Aber wenn wir mit dem realen Datensatz arbeiten wollen, dann, zu diesem Zeitpunkt, wir verwenden Action.
Spark-SQL
Die Spark SQL-Komponente ist ein verteiltes Framework für die Verarbeitung strukturierter Daten. Spark SQL gibt strukturierte und halbstrukturierte Informationen ein. Es ermöglicht auch leistungsstarke und interaktive analytische Anwendungen in historischen und Übertragungsdaten. DataFrames und SQL bieten eine gemeinsame Möglichkeit zum Eingeben eines Bereichs von Datenquellen. Sein Hauptmerkmal ist es, ein Optimierer zu sein, der auf Kosten und Toleranz gegenüber mittleren Abfragefehlern basiert..
Spark-Streaming
Es ist ein Add-on zur Kern-API von Spark, das eine skalierbare Stream-Verarbeitung ermöglicht, performante und fehlertolerante Live-Datenübertragungen. Spark-Streaming, Gruppiert Live-Daten in kleine Batches. Anschließend liefert es es stapelweise zur Verarbeitung an das System aus.. Bietet auch Fehlertoleranzfunktionen.
Spark GraphX:
GraphX in Spark ist eine API für Diagramme und parallele Diagrammausführung. Es handelt sich um eine Netzwerkdiagramm-Analyse-Engine und ein Data Warehouse. In den Graphen ist es auch möglich, zu gruppieren, kategorisieren, Scooch, Routen suchen und finden.
SparkR:
SparkR bietet eine verteilte Datenframework-Implementierung. Unterstützt Operationen als Selektion, ausgefiltert, Aggregation, aber in großen Datensätzen.
Spark MLlib:
Spark MLlib wird verwendet, um maschinelles Lernen in Apache Spark durchzuführen. MLlib besteht aus gängigen Algorithmen und Dienstprogrammen. MLlib on Spark ist eine skalierbare Bibliothek für maschinelles Lernen, die sowohl hochwertige als auch Hochgeschwindigkeitsalgorithmen analysiert. Machine-Learning-Algorithmen als Regression, Einstufung, GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.., Pattern Mining und kollaboratives Filtern. Die Primitive des maschinellen Lernens auf niedrigerer Ebene, als generischer Algorithmus zur Optimierung der Steigungsabnahme, Sie sind auch in MLlib vorhanden.
Spark.ml ist die primäre Machine Learning-API für Spark. Die Bibliothek Spark.ml bietet eine Top-Level-API, die auf DataFrames basiert, um ML-Pipelines zu erstellen.
Die Tools von Spark MLlib werden im Folgenden bereitgestellt.:
- ML-Algorithmen
- Charakterisierung
- Pipelines
- Beharrlichkeit
- Dienstprogramme
-
ML-Algorithmen
ML-Algorithmen bilden den Kern von MLlib. Dazu gehören gängige Lernalgorithmen wie die Klassifizierung., Rückschritt, Kollaboratives Gruppieren und Filtern.
MLlib standardisiert APIs, um mehrere Algorithmen in einer einzigen Pipeline oder einem Workflow zu kombinieren. Die Schlüsselkonzepte sind die Api-Pipelines, Wo das Konzept der Pipeline vom Scikit-learn-Projekt inspiriert ist.
Transformator:
Ein Transformator ist ein Algorithmus, der einen DataFrame in einen anderen DataFrame transformieren kann. Technisch, Ein Transformer implementiert eine Transformationsmethode (), die einen DataFrame in einen anderen konvertiert, im Allgemeinen durch Hinzufügen einer oder mehrerer Spalten. Als Beispiel:
Ein Feature-Transformator kann einen DataFrame aufnehmen, Lesen einer Spalte (als Beispiel, Text), Weisen Sie es einer neuen Spalte zu (als Beispiel, Feature-Vektoren) und generieren Sie einen neuen DataFrame mit der zugeordneten Spalte.
Ein Lernmodell kann einen DataFrame aufnehmen, Lesen Sie die Spalte mit den Feature-Vektoren, Prognostizieren Sie das Tag für jeden Feature-Vektor und generieren Sie einen neuen DataFrame mit vorhergesagten Tags, die als Spalte hinzugefügt werden.
SchätzerDas "Schätzer" ist ein statistisches Instrument, mit dem aus einer Stichprobe Merkmale einer Grundgesamtheit abgeleitet werden können. Es stützt sich auf mathematische Methoden, um genaue und zuverlässige Schätzungen zu liefern. Es gibt verschiedene Arten von Schätzern, wie die Unvoreingenommenheit und die konsequente, die je nach Kontext und Ziel der Studie ausgewählt werden. Seine korrekte Anwendung ist für die wissenschaftliche Forschung unerlässlich, Umfragen und Datenanalysen....:
Ein Schätzer ist ein Algorithmus, der an einen DataFrame angepasst werden kann, um einen Transformator zu erzeugen. Technisch, ein Estimator implementiert eine Fit-Methode (), die einen DataFrame akzeptiert und ein Modell erzeugt, das ist ein Transformer. Als Beispiel, Ein Lernalgorithmus wie LogisticRegression ist ein Estimator, und Call Fit () trainiert ein LogisticRegressionModel, die ein Modell ist und, deshalb, ein Transformator.
Transformer.transform () und Estimator.fit () sind staatenlos. In der Zukunft, Zustandsbehaftete Algorithmen können mit alternativen Konzepten kompatibel sein.
Jede Instanz eines Transformators oder Schätzers hat eine eindeutige ID, que es útil para especificar ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... (im Folgenden beschrieben).
-
Charakterisierung
Charakterisierung umfasst Extraktion, Transformation, verringerte Dimensionalität und KE-Auswahl.
- Bei der Feature-Extraktion geht es darum, Features aus Rohdaten zu extrahieren.
- Die Featuretransformation umfasst die Skalierung, Erneuern oder Ändern von Features
- Bei der Featureauswahl wird eine Teilmenge unverzichtbarer Features aus einem großen Featuresatz ausgewählt..
-
Rohrleitungen:
Eine Pipeline verkettet mehrere Transformatoren und Schätzer, um einen AA-Workflow festzulegen. Es bietet auch Tools zum Erstellen von, Durchsuchen und Optimieren von ML-Pipelines.
Beim maschinellen Lernen, Es ist üblich, eine Sequenz von Algorithmen auszuführen, um die Daten zu verarbeiten und daraus zu lernen. MLlib representa un flujo de trabajo como RohrleitungPipeline ist ein Begriff, der in einer Vielzahl von Zusammenhängen verwendet wird, hauptsächlich im Technologie- und Projektmanagement. Es bezieht sich auf eine Reihe von Prozessen oder Phasen, die den kontinuierlichen Arbeitsfluss von der Konzeption einer Idee bis zu ihrer endgültigen Umsetzung ermöglichen. Im Bereich der Softwareentwicklung, zum Beispiel, Eine Pipeline kann die Planung umfassen, Testen und Bereitstellen, Dies garantiert mehr Effizienz und Qualität in der..., Dies ist eine Abfolge von Pipeline-Stufen (Transformatoren und Schätzer) in einer bestimmten Reihenfolge ausgeführt werden. Wir werden diesen einfachen Workflow als Beispiel für die Ausführung in diesem Abschnitt verwenden..
Beispiel: Das unten gezeigte Pipelinebeispiel führt die Datenvorverarbeitung in einer bestimmten Reihenfolge wie folgt aus:
1. Aplicar el método String Indexer para hallar el IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... de las columnas categóricas
2. Anwenden der OneHot-Codierung auf kategoriale Spalten
3. Anwenden des Zeichenfolgenindexers für die Spalte „Etikett“ aus VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Ausgabe
4. VectorAssembler gilt sowohl für kategoriale als auch für numerische Spalten. VectorAssembler ist ein Transformator, der eine gegebene Liste von Spalten in einer einzigen Vektorspalte kombiniert.
Der Pipeline-Workflow führt die Datenmodellierung in der oben genannten Reihenfolge aus.
aus pyspark.ml.feature importieren OneHotEncoderEstimator, StringIndexer, VectorAssembler
categoricalColumns = ['job', 'marital', 'education', 'default', 'housing', 'loan']
Stufen = []
für categoricalCol in categoricalColumns:
    stringIndexer = StringIndexer(inputCol = kategorialCol, outputCol = kategorialCol + 'Indexer')
    Encoder = OneHotEncoderEstimator(inputCols=[stringIndexer.getOutputCol()], AusgabeCols=[kategoricalCol + "Vec |"])
    Stufen += [ZeichenfolgeIndexer, Encoder]
label_stringIdx = StringIndexer(EingabeCol="deponieren", AusgangCol="Etikett")
Stufen += [label_stringIdx]
numericColumns = ['age', 'balance', 'duration']
assemblerInputs = [C + "Vec |" für c in categoricalColumns] + numericColumns
Vassembler = VectorAssembler(inputCols = assemblerinputs, AusgangCol="Merkmale")
Stufen += [Vassembler]
from pyspark.ml import Pipeline pipeline = Pipeline(Stufen = Etappen) pipelineModel = pipeline.fit(df) df = pipelineModel.transform(df) selectedCols = ['label', 'features'] + cols df = df.select(selectedCols)
Datenrahmen
Los marcos de datos proporcionan una API más fácil de utilizar que los RDD. Die DataFrame-basierte API für MLlib bietet eine konsistente API über ML-Algorithmen hinweg und in mehreren Sprachen. Daten-Frameworks erleichtern praktische Pipelines für maschinelles Lernen, insbesondere Feature-Transformationen.
from pyspark.sql import SparkSession spark = SparkSession.builder.appName('mlearnsample').getOrCreate() df = spark.read.csv('loan_bank.csv', header = True, inferSchema = True) df.printSchema() -
Beharrlichkeit:
Persistenz hilft beim Speichern und Laden von Algorithmen, Modelle und Pipelines. Dies hilft, Zeit und Aufwand zu reduzieren, Da das Modell persistent ist, kann geladen werden / Wiederverwendung jederzeit bei Bedarf.
from pyspark.ml.classification import LogisticRegression
lr = LogisticRegression(FunktionenCol="Merkmale", labelCol="Etikett")
lrModel = lr.fit(Bahn)
aus pyspark.ml.evaluation importieren BinaryClassificationEvaluator
Evaluator = BinaryClassificationEvaluator ()
drucken (‚Testbereich unter ROC‘, evaluator.evaluate (Vorhersagen))
Vorhersagen = lrModel.transform(Prüfung) Vorhersagen.select('age', 'label', 'roheVorhersage', 'Vorhersage').zeigen() -
Dienstprogramme:
Dienstprogramme für lineare Algebra, Statistik und Datenverarbeitung. Beispiel: mllib.linalg sind die MLlib-Dienstprogramme für lineare Algebra.
Referenzmaterial:
https://spark.apache.org/docs/latest/ml-guide.html
Abschließende Anmerkungen
Spark MLlib ist notwendig, wenn es sich um Big Data und maschinelles Lernen handelt. In diesem Beitrag, Erfahren Sie mehr über die Details von Spark MLlib, Daten-Frameworks und Pipelines. Im zukünftigen Beitrag, Wir werden an praktischem Code arbeiten, um Pipelines zu implementieren und Datenmodelle mit MLlib zu erstellen.





