
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
VGG- Network es un modelo de rote neuronale FaltungFaltungsneurale Netze (CNN) sind eine Art von neuronaler Netzwerkarchitektur, die speziell für die Datenverarbeitung mit einer Gitterstruktur entwickelt wurde, als Bilder. Sie verwenden Faltungsschichten, um hierarchische Merkmale zu extrahieren, Dies macht sie besonders effektiv bei Mustererkennungs- und Klassifizierungsaufgaben. Dank seiner Fähigkeit, aus großen Datenmengen zu lernen, CNNs haben Bereiche wie Computer Vision revolutioniert.. propuesto por K. Simonyan und A. Zisserman im Artikel „Sehr tiefe Faltungsnetzwerke für großflächige Bilderkennung“ [1]. Diese Architektur erreichte Testgenauigkeit zwischen den 5 das beste von 92,7% auf ImageNet, das hat mehr als 14 Millionen Bilder gehören zu 1000 Lektionen.
Es una de las arquitecturas famosas en el campo del tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit.... Ersetzen Sie große Kernelgrößenfilter durch 11 Ja 5 in der ersten und zweiten Schicht, beziehungsweise, zeigte eine Verbesserung gegenüber der AlexNet-Architektur, mit mehreren Kernelgrößenfiltern von 3 × 3 einer nach demanderen. Es wurde wochenlang trainiert und nutzte die NVIDIA Titan Black GPU.
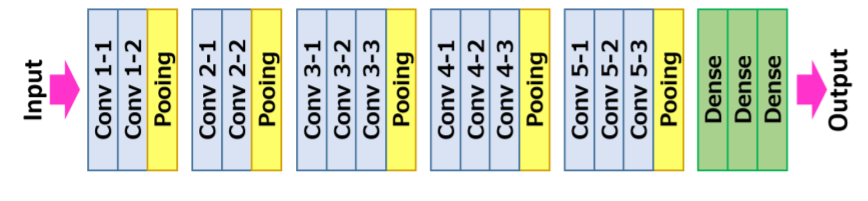
VGG16-Architektur
La entrada a la rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. de convolución es una imagen RGB de tamaño fijo 224 × 224. Die einzige Vorverarbeitung, die es macht, ist die Subtraktion der durchschnittlichen RGB-Werte, que se calculan en el conjunto de datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen...., von jedem Pixel.
Später, das Bild läuft durch einen Stapel von Faltungsschichten (Konv.), Wo gibt es Filter mit einem sehr kleinen rezeptiven Feld, das heißt 3 × 3, was die kleinste Größe ist, um den Begriff von links zu erfassen / rechts, hoch / Nieder, und Mittelteil.
In einer der Konfigurationen, verwendet auch Faltungsfilter 1 × 1, die als lineare Transformation der Eingangskanäle gefolgt von Nichtlinearität beobachtet werden kann. Faltungsschritte sind auf festgelegt 1 Pixel; el relleno espacial de la entrada de la FaltdeckelDie Faltungsschicht, grundlegend in Convolutional Neural Networks (CNN), Es wird hauptsächlich für die Datenverarbeitung mit gitterartigen Strukturen verwendet, als Bilder. Dieser Layer wendet Filter an, die relevante Features extrahieren, wie Kanten und Texturen, Ermöglicht dem Modell, komplexe Muster zu erkennen. Seine Fähigkeit, die Dimensionalität von Daten zu reduzieren und wichtige Informationen zu speichern, macht es zu einem wichtigen Werkzeug für Computer-Vision-Aufgaben.. es tal que la AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist.... espacial se mantiene después de la convolución, nämlich, die Füllung ist 1 Pixel für 3 × 3 Conv. deckt.
Später, Die räumliche Gruppierung erfolgt durch fünf Schichten maximaler Gruppierung, 16 die einigen der Conv . folgen. deckt, aber nicht alle Conv. auf Ebenen folgt die maximale Gruppierung. Diese maximale Gruppierung erfolgt in einem Fenster von 2 × 2 Pixel, mit Schritt 2.
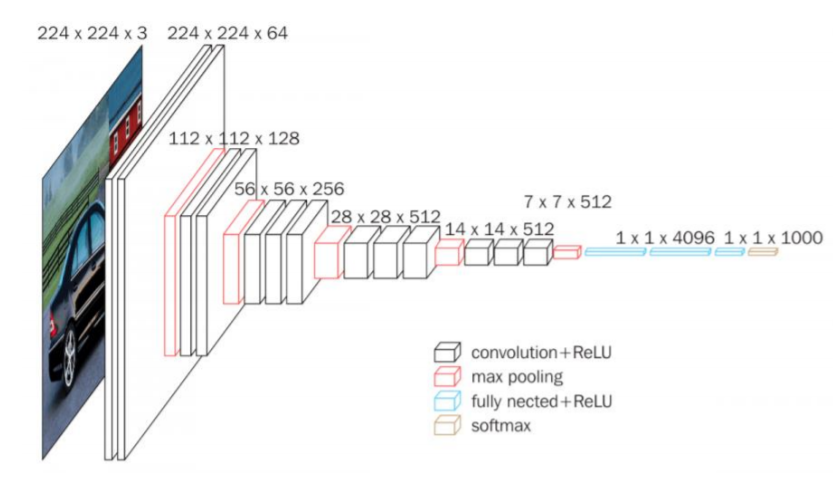
Die Architektur enthält einen Stapel von Faltungsschichten, die in verschiedenen Architekturen eine unterschiedliche Tiefe haben, gefolgt von drei vollständig verbundenen Schichten (FC): die ersten beiden FC haben 4096 Kanäle und der dritte FC führt eine Klassifizierung von 1000 Routen und enthält daher 1000 Kanäle, einer für jede Klasse.
Die letzte Schicht ist die Soft-Max-Schicht. Die Konfiguration der vollständig verbundenen Schichten ist in allen Netzwerken ähnlich.
Alle versteckten Schichten sind mit Entzerrung ausgestattet (LebenslaufDie Aktivierungsfunktion von ReLU (Gleichgerichtete Lineareinheit) Es wird aufgrund seiner Einfachheit und Effektivität häufig in neuronalen Netzen verwendet. Definiert als ( F(x) = max(0, x) ), ReLU lässt Neuronen nur dann feuern, wenn die Eingabe positiv ist, Dies hilft, das Problem des Gradientenverblassens zu mildern. Es hat sich gezeigt, dass seine Verwendung die Leistung bei verschiedenen Deep-Learning-Aufgaben verbessert, ReLU zu einer Option machen..) nichtlinear. Was ist mehr, aquí una de las redes contiene NormalisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.... de respuesta local (LRN), eine solche Normalisierung verbessert nicht die Leistung des trainierten Datensatzes, seine Verwendung führt jedoch zu einem höheren Speicherverbrauch und einer höheren Rechenzeit.
Architekturzusammenfassung:
• Die Eingabe in das Modell ist ein RGB-Bild mit fester Größe 224 × 224224 × 224
• Die Vorverarbeitung besteht darin, den Mittelwert des RGB-Werts des Trainingssatzes von jedem Pixel zu subtrahieren
• Faltungsschichten 17
– Fester Schritt zu 1 Pixel
– die Füllung ist 1 Pixel für 3 × 33 × 3
• Räumliche Gruppierungsebenen
– Diese Schicht wird konventionsgemäß nicht auf die Tiefe der Bahn angerechnet
– Die räumliche Gruppierung erfolgt mit maximalen Gruppierungsebenen
– die fenstergröße ist 2 × 22 × 2
– Schritt auf eingestellt 2
– Verwendete Convnets 5 maximale Gruppierungsebenen
• Vollständig verbundene Schichten:
• 1º: 4096 (Lebenslauf).
▪ 2do: 4096 (Lebenslauf).
▪ 3º: 1000 (Softmax).
Architekturkonfiguration
La siguiente Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... contiene la configuración de la red neuronal de convolución de la red VGG con el
nächste Schichten:
• VGG-11
• VGG-11 (LRN)
• VGG-13
• VGG-16 (Conv1)
• VGG-16
• VGG-19
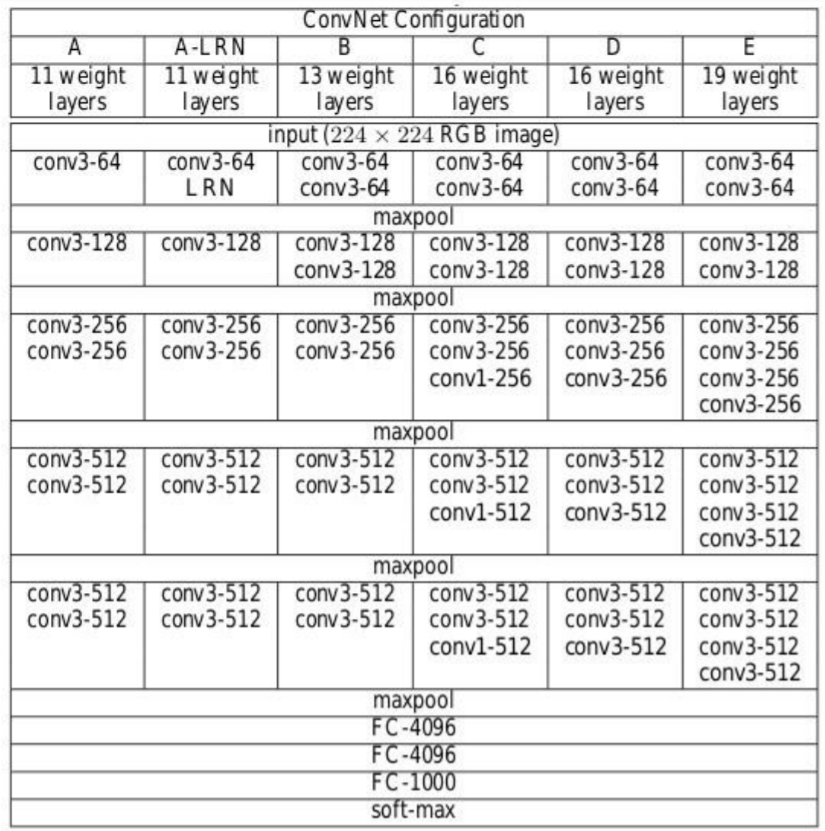
Quelle: „Sehr tiefe Faltungsnetzwerke für großflächige Bilderkennung“
Konvolutionelle neuronale Netzwerkkonfigurationen sind oben eine pro Spalte erwähnt.
Dann, Netzwerke werden mit ihren Namen bezeichnet (A - E). Alle Konfigurationen folgen dem traditionellen Design und unterscheiden sich nur in der Tiefe: von 11 Gewichtungsschichten in Netzwerk A, die 8 Conv. Ja 3 Schichten FC a 19 Gewichtsschichten im E-Netzwerk, das ist 16 Conv. Ja 3 FC-Schichten. Die Breite jeder Conv. Schicht ist die Anzahl der Kanäle ist ziemlich klein, das beginnt bei 64 in der ersten Schicht und erhöht sich dann weiter um den Faktor 2 nach jeder Schicht maximaler Gruppierung bis zum Erreichen von 512.
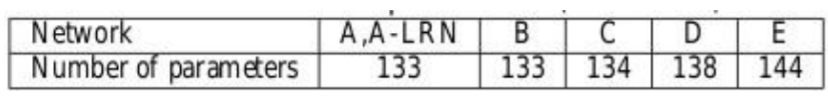
El número de ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... para cada configuración se describe a continuación. Obwohl es eine große Tiefe hat, die Anzahl der Gewichtungen in den Netzwerken ist nicht größer als die Anzahl der Gewichtungen in einem flacheren Netzwerk mit höherem conv. Schichtbreiten und Aufnahmefelder
Ausbildung
• La Verlust-FunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und... es una regresión logística multinomial
• El algoritmo de aprendizaje es un descenso de SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... stochastisch (SGD) Mini-Batch basierend auf Momentum-Backspread.
· Die Losgröße war 256
· Der Impuls war 0,9
• RegulierungDie Regularisierung ist ein administrativer Prozess, der darauf abzielt, die Situation von Personen oder Organisationen zu formalisieren, die außerhalb des gesetzlichen Rahmens tätig sind. Dieses Verfahren ist unerlässlich, um Rechte und Pflichten zu gewährleisten, sowie zur Förderung der sozialen und wirtschaftlichen Inklusion. In vielen Ländern, Die Regularisierung wird in Migrationskontexten angewendet, Arbeit und Steuern, denjenigen, die sich in irregulären Situationen befinden, den Zugang zu Leistungen zu ermöglichen und sich vor möglichen Sanktionen zu schützen....
· L2-Gewichtsverfall (der Strafmultiplikator war 0,0005)
· Dropout für die ersten beiden vollständig verbundenen Layer ist auf eingestellt 0.5
• Lernrate
· Initial: 0.01
· Als die Genauigkeit des Validierungssatzes aufhörte, sich zu verbessern, se reduzieren a 10.
• Obwohl es eine größere Anzahl von Parametern und auch eine größere Tiefe hat als Alexnet, CNN benötigte weniger Zeiten für die Konvergenz der Verlustfunktion aufgrund von
· Kleine Faltungskörner und mehr Regularisierung durch große Tiefe.
· Vorinitialisierung bestimmter Layer.
• Trainingsbildgröße
· S ist die kleinste Seite des isotopenreskalierten Bildes
· Zwei Ansätze zur Etablierung von S
▪ Fix S, bekannt als einstufiges Training
▪ Hier S = 256 y S = 384
▪ Variieren S, bekannt als Multiskalentraining
▪ S de [Smin, Smax] wobei Smin = 256, Smax = 512
– Später 224 × 224224 × 224
Das Bild wurde zufällig aus dem neu skalierten Bild der SGD-Iteration abgeschnitten.
Hauptmerkmale
• VGG16 hat insgesamt 16 Schichten, die einige Gewichte haben.
• Es werden nur Faltungs- und Gruppierungsschichten verwendet.
• Verwenden Sie immer einen Kern von 3 x 3 für Faltung. 20
• Größe 2 × 2 maximaler Pool.
• 138 Millionen Parameter.
• In ImageNet-Daten geschult.
• Hat eine Genauigkeit von 92,7%.
• Eine andere Version, die VGG . ist 19, hat insgesamt 19 Schichten mit Gewichten.
• Es ist eine sehr gute Deep-Learning-Architektur für das Benchmarking einer bestimmten Aufgabe.
• Vortrainierte Netzwerke für VGG sind Open Source, so können sie allgemein für verschiedene Arten von Anwendungen verwendet werden.
Implementemos VGG Net
Zuerst, Lassen Sie uns eine Filterzuordnung für jede Version des VGG-Netzwerks erstellen. Die Anzahl der Filter entnehmen Sie bitte dem Konfigurationsbild oben. Nämlich, Erstellen Sie ein Wörterbuch für die Version mit einem Schlüssel namens VGG11, VGG13, VGG16, VGG19 und erstellen Sie eine Liste entsprechend der Anzahl der Filter in jeder Version.. Hier „m“ in der Liste ist es als Maxpool-Operation bekannt.
Taschenlampe importieren
brenner.nn als nn importieren
VGG_types = {
"VGG11": [64, "m", 128, "m", 256, 256, "m", 512, 512, "m", 512, 512, "m"],
"VGG13": [64, 64, "m", 128, 128, "m", 256, 256, "m", 512, 512, "m", 512, 512, "m"],
"VGG16": [64,64,"m",128,128,"m",256,256,256,"m",512,512,512,"m",512,512,512,"m",],
"VGG19": [64,64,"m",128,128,"m",256,256,256,256,"m",512,512,512,512,
          "m",512,512,512,512,"m",],}
Cree una VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... global para mencionar la versión de la arquitectura. Erstellen Sie dann eine Klasse namens VGG_net mit Eingaben wie in_channels und num_classes. Nimmt Eingaben als Anzahl von Bildkanälen und die Anzahl von Ausgabeklassen.
Sequenzielle Ebenen initialisieren, nämlich, in der folge, Lineare Schicht–> ReLU–> Überspringen.
Erstellen Sie dann eine Funktion namens create_conv_layers, die die VGGnet-Architekturkonfiguration als Eingabe verwendet, Dies ist die Liste, die wir zuvor für verschiedene Versionen erstellt haben. Wenn er den Brief trifft „m“ aus der Liste oben, Führen Sie die MaxPool2d-Operation durch.
VGGTyp = "VGG16"
Klasse VGGnet(nn.Modul):
    def __init__(selbst, in_channels=3, num_classes=1000):
        Super(VGGnet, selbst).__drin__()
        self.in_channels = in_channels
        self.conv_layers = self.create_conv_layers(VGG_Typen[VGGTyp])
self.fcs = nn.Sequential(
nn.Linear(512 * 7 * 7, 4096),
nn.ReLU(),
nn.Ausfall(p=0,5),
nn.Linear(4096, 4096),
nn.ReLU(),
nn.Ausfall(p=0,5),
nn.Linear(4096, Anzahl_Klassen),
)

def vorwärts(selbst, x):
x = self.conv_layers(x)
x = x.umformen(x.form[0], -1)
x = self.fcs(x)
Rückgabe x

def create_conv_layers(selbst, die Architektur):
Schichten = []
in_channels = self.in_channels

für x in der Architektur:
wenn Typ(x) == int:
out_channels = x

Schichten += [
nn.Conv2d(
in_channels=in_channels,
out_channels=out_channels,
kernel_size=(3, 3),
Schritt =(1, 1),
Polsterung=(1, 1),
),
nn.BatchNorm2d(x),
nn.ReLU(),
]
in_channels = x
elif x == "m":
Schichten += [nn.MaxPool2d(kernel_size=(2, 2), Schritt =(2, 2))]

return nn.Sequential(*Schichten)
Sobald dies erledigt ist, Schreiben Sie einen kleinen Testcode, um zu überprüfen, ob unsere Implementierung einwandfrei funktioniert.
Im folgenden Testcode, die anzahl der gegebenen klassen ist 500.
wenn __name__ == "__hauptsächlich__":
    Gerät = "Wunder" wenn fackel.cuda.is_verfügbar() anders "Zentralprozessor"
    Modell = VGGnet(in_channels=3, Anzahl_Klassen=500).zu(Gerät)
    # drucken(Modell)
    x = fackel.randn(1, 3, 224, 224).zu(Gerät)
    drucken(Modell(x).Form)
Die Ausgabe sollte so aussehen:
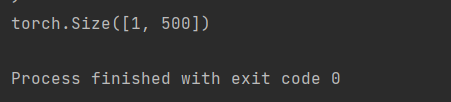
Wenn Sie die Netzwerkarchitektur sehen möchten, du kannst das auskommentieren zu drucken (Modell) obige Code-Deklaration. Sie können auch verschiedene Versionen ausprobieren, indem Sie die VGG-Versionen in der VGGType-Variable ändern.
Den vollständigen Code finden Sie hier:
https://github.com/BakingBrains/Deep_Learning_models_implementation_from-scratch_using_pytorch_/blob/main/VGG.py
[1]. K. Simonyan und A. Zisserman: Sehr tiefe Faltungsnetzwerke für großflächige Bilderkennung, April von 2015, DOI: https://arxiv.org/pdf/1409.1556.pdf
Vielen Dank
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





