
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction:
Comme nous le savons tous, L'intelligence artificielle est largement utilisée autour de nous: de la lecture des actualités sur votre appareil mobile ou de l'analyse de ces données complexes sur votre lieu de travail, L'IA a amélioré la vitesse, précision et efficacité de l'effort humain. Les progrès de l'IA nous ont aidés à réaliser des choses que nous pensions auparavant impossibles. Même avoir une pizza de votre restaurant préféré à la maison est à portée de clic, grâce à l'IA.
En peu de mots, intelligence artificielle désigne un ordinateur ou un programme informatique qui imite l'intelligence humaine. Il est atteint en apprenant comment vous pensez, apprendre, décide et travaille le cerveau humain tout en résolvant un problème. Les résultats de cette étude sont ensuite utilisés comme base pour développer des systèmes et logiciels intelligents..
Il y a 4 types d'apprentissage:
● Enseignement superviséL’apprentissage supervisé est une approche d’apprentissage automatique dans laquelle un modèle est formé à l’aide d’un ensemble de données étiquetées. Chaque entrée du jeu de données est associée à une sortie connue, permettre au modèle d’apprendre à prédire les résultats pour de nouvelles entrées. Cette méthode est largement utilisée dans des applications telles que la classification d’images, Reconnaissance vocale et prédiction de tendances, soulignant son importance dans....
● Apprentissage non supervisé.
● Apprentissage semi-supervisé.
● Apprentissage renforcé.
| Supervisé | Non supervisé | Semi-supervisé | Renforcé |
| L'apprentissage supervisé se produit lorsque le modèle est formé sur un ensemble de données étiqueté. | Le Apprentissage non superviséL’apprentissage non supervisé est une technique d’apprentissage automatique qui permet aux modèles d’identifier des modèles et des structures dans des données sans étiquettes prédéfinies. Grâce à des algorithmes tels que les k-moyennes et l’analyse en composantes principales, Cette approche est utilisée dans une variété d’applications, comme la segmentation de la clientèle, Détection d’anomalies et compression de données. Sa capacité à révéler des informations cachées en fait un outil précieux dans le... c'est lorsque le modèle est entraîné sur un ensemble de données non étiqueté, c'est à l'algorithme de trouver des modèles sous-jacents dans les données. | Il se situe entre l'apprentissage supervisé et non supervisé, dans ce, certaines données d'apprentissage sont étiquetées et d'autres non. | L'algorithme évalue ses performances en fonction des réponses de rétroaction et réagit en conséquence. |
Ce blog couvre l'apprentissage supervisé et non supervisé de l'IA, en utilisant l'ensemble de données Python et Iris.
Table des matières:
- introduction
- Ensemble de données d'iris
- Enseignement supervisé
- Arbre de décision
- Régression logistique
- Apprentissage non supervisé
- Regroupement des bas K
- Conclusion et références
Ensemble de données d'iris:
L'ensemble de données contient 3 cours avec 50 cas chacun et 150 nombre total d'instances, où chaque classe fait référence à un type de plante d'iris.
Classe: Iris soyeux, Iris Versicolor, Iris Virginie
Le format des données: (longueur des sépales, largeur des sépales, longueur des pétales, largeur des pétales)
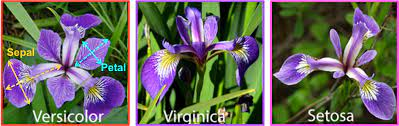
Nous entraînerons nos modèles en fonction de ceux-ci paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... et nous les utiliserons pour prédire les classes de fleurs.
Comprendre les données:
Téléchargez le jeu de données Iris à partir de https://www.kaggle.com/uciml/iris
importer numpy en tant que np
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
iris = pd.read_csv("Iris.csv") #Iris.csv est maintenant un dataframe pandas
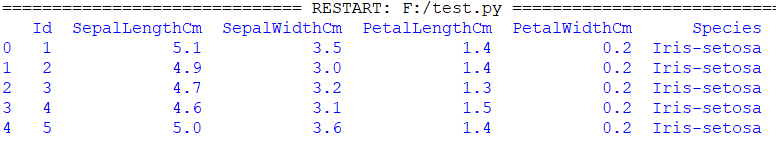
imprimer(tête.iris()) #imprime en premier 5 valeurs
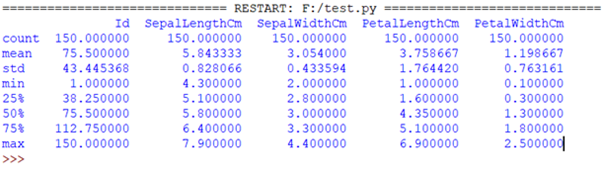
imprimer(iris.décrire()) #imprime quelques détails statistiques de base comme le centile,moyenne, norme etc.. de la trame de données |
Visualiser les données à l'aide de matplotlib:
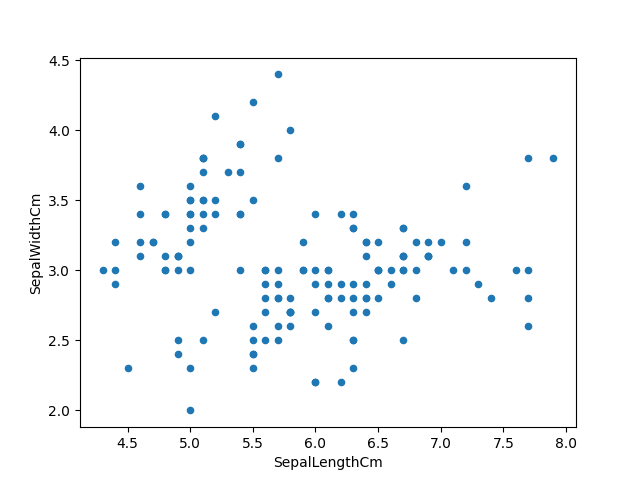
iris.plot(genre ="dispersion", x="SépaleLongueurCm", y ="SepalLargeurCm") plt.show() |
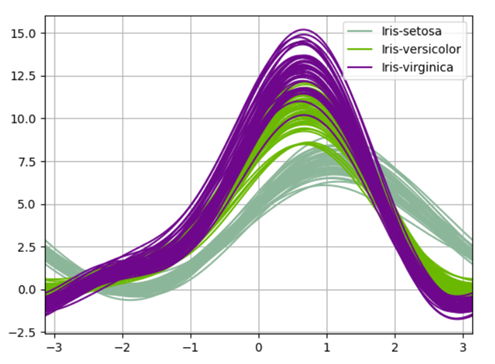
Visualisation des données à l'aide des courbes d'Andrew des pandas:
Les courbes d'Andrews ont la forme fonctionnelle:
F
x_4 sans (2t) + x_5 car (2t) +…
Où les coefficients x correspondent aux valeurs de chaque dimension"Dimension" C’est un terme qui est utilisé dans diverses disciplines, comme la physique, Mathématiques et philosophie. Il s’agit de la mesure dans laquelle un objet ou un phénomène peut être analysé ou décrit. En physique, par exemple, On parle de dimensions spatiales et temporelles, alors qu’en mathématiques, il peut faire référence au nombre de coordonnées nécessaires pour représenter un espace. Sa compréhension est fondamentale pour l’étude et... et t est espacée linéairement entre -pi et + pi. Chaque rangée du cadre correspond à une seule courbe.
de pandas.plotting importer andrews_curves
andrews_curves(iris.goutte("Identifiant", axe=1), "Espèce")
plt.show()
|
Pré-traitement du jeu de données:
En utilisant une bibliothèque intégrée appelée ‘train_test_split’, qui divise notre ensemble de données en une proportion de 80:20. Le 80% sera utilisé pour entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines...., évaluation et sélection entre nos modèles et les 20% sera conservé comme un ensemble de données de validation.
de sklearn.model_selection importer train_test_split x = iris.iloc[:, :-1].valeurs #dernière colonne valeurs exclues y = iris.iloc[:, -1].valeurs #dernière valeur de colonne de sklearn.model_selection importer train_test_split x_train,x_test,y_train,y_test = train_test_split(X,Oui,test_size=0.2,random_state=0) #Diviser l'ensemble de données en ensemble d'entraînement et ensemble de test |
Enseignement supervisé :
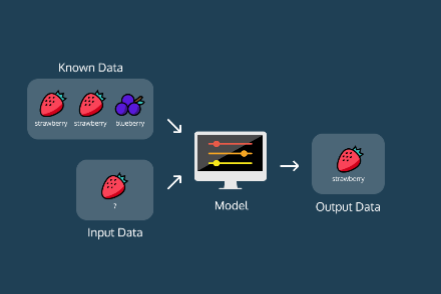
Des algorithmes d'apprentissage automatique supervisés sont entraînés pour trouver des modèles à l'aide d'un ensemble de données. Le processus est simple, prend ce qui a été appris dans le passé et l'applique ensuite à de nouvelles données. L'apprentissage supervisé utilise des exemples étiquetés pour prédire des modèles et des événements futurs.
Par exemple, quand nous enseignons à un enfant que 2 + 2 = 4 ou nous indiquons l'image de n'importe quel animal afin que vous connaissiez son nom.
L'apprentissage supervisé est à son tour divisé en:
● Classification: La classification prédit les étiquettes de classe catégorielles, qui sont discrets et désordonnés. C'est un processus en deux étapes, composé d'une étape d'apprentissage et d'une étape de classification. Il existe différents algorithmes de classification comme: « Classificateur d'arbre de décision », « Forêt aléatoire », « Classificateur naïf de Bayes », etc.
● Régression: La régression est généralement décrite comme la détermination d'une relation entre deux ou plusieurs variables, comment prédire le travail d'une personne en fonction des données d'entrée X. Certains des algorithmes de régression sont: « Régression logistique », « Régression de boucle », « Régression de crête », etc. .
Classificateur d'arbre de décision:
La raison générale de l'utilisation d'un arbre de décision est de créer un modèle d'apprentissage qui peut être utilisé pour prédire la classe ou la valeur des variables cibles en apprenant les règles de décision déduites des données précédentes. (données d'entraînement).
Essayez de résoudre le problème en utilisant la représentation arborescente. Tous nœudNodo est une plateforme digitale qui facilite la mise en relation entre les professionnels et les entreprises à la recherche de talents. Grâce à un système intuitif, Permet aux utilisateurs de créer des profils, Partager des expériences et accéder à des opportunités d’emploi. L’accent mis sur la collaboration et le réseautage fait de Nodo un outil précieux pour ceux qui souhaitent élargir leur réseau professionnel et trouver des projets qui correspondent à leurs compétences et à leurs objectifs.... l'intérieur de l'arbre correspond à un attribut et chaque nœud feuille correspond à une étiquette de classe.
Utilisation de l'arbre de décision dans l'ensemble de données Iris:
depuis sklearn.tree importer DecisionTreeClassifier
de sklearn.metrics importer precision_score
classificateur = DecisionTreeClassifier() classificateur.fit(x_train, y_train) #former le classificateur y_pred = classifier.predict(x_test) #faire des prédictions imprimer(classement_rapport(y_test, y_pred)) #Résumé des prédictions faites par le classificateur imprimer(confusion_matrice(y_test, y_pred)) #évaluer la qualité de la production imprimer('la précision est',score_précision(y_pred,y_test)) #Note de précision
|
Précision: précision des prédictions positives.
Récupération: fraction de positifs qui ont été correctement identifiés.
Score F1: Quel pourcentage de prédictions positives étaient correctes?
moyenne macro – moyenne non pondérée par étiquette
moyenne pondérée: faire la moyenne de la moyenne pondérée du soutien par étiquette
Carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées.... pour la matrice de confusion:
importer seaborn comme sns cm = confusion_matrice(y_test, y_pred) #Transformer en df cm_df = pd.DataFrame(cm,indice = ['setosa','versicolor','virginica'], colonnes = ['setosa','versicolor','virginica']) plt.figure(taille de la figue=(5.5,4)) sns.heatmap(cm_df, annot=Vrai) plt.ylabel('Étiquette réelle')
plt.xlabel('Étiquette prédite')
plt.show() |
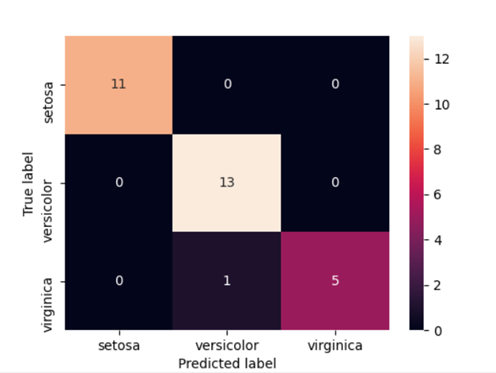
Une idée que nous pouvons tirer de la matrice est que le modèle était très précis lors de la classification de Setosa et Virginica (Vraiment positif / Tout = 1.0). Cependant, La précision de Versicolor était inférieure (13/14 = 0,928).
Apprentissage non supervisé:
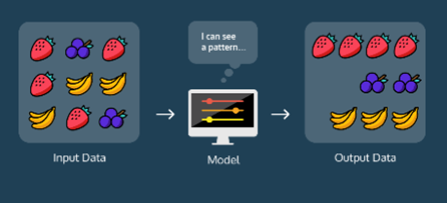
L'apprentissage non supervisé est utilisé sur des données sans étiquettes historiques. Le système n'est pas soumis à un ensemble prédéterminé de sorties, corrélations entre les entrées et les sorties ou un « bonne réponse ». L'algorithme doit comprendre ce qu'il voit par lui-même, car il n'a pas de stockage de waypoint. L'objectif est d'explorer les données et de trouver une sorte de modèles ou de structures.
L'apprentissage non supervisé peut être classé en:
● Regroupement: Le clustering est la tâche de diviser la population ou les points de données en plusieurs groupes, de sorte que les points de données d'un groupe soient homogènes entre eux par rapport à ceux de différents groupes. Il existe de nombreux algorithmes de regroupement, Certains d'entre eux sont: « Algorithmes de clustering K-means », « changement moyen », « regroupement hiérarchique », etc.
● Association: Une règle d'association est une méthode d'apprentissage non supervisée utilisée pour trouver des relations entre les variables dans un grand base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes..... Déterminer l'ensemble des éléments qui se produisent ensemble dans l'ensemble de données.
Regroupement des bas K:
Le but de l'algorithme de clustering K-means est de trouver des clusters dans les données, avec le nombre de groupes représenté par le variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... K. L'algorithme fonctionne de manière itérative pour attribuer chaque point de données à l'un des K groupes en fonction des caractéristiques fournies.. .
Les résultats de l'exécution d'un K-means sur un ensemble de données sont:
● Centroïdes K: centroïdes pour chacun des K groupes identifiés dans l'ensemble de données.
● Étiquettes pour les données d'entraînement: ensemble de données complet étiqueté pour garantir que chaque point de données est mappé à l'un des clusters.
Utilisation du clustering K-means sur l'ensemble de données Iris:
à partir de sklearn.datasets importer load_iris
à partir de sklearn.cluster importer KMeans
iris_data=load_iris() #chargement du jeu de données d'iris à partir de sklearn.datasets iris_df = pd.DataFrame(iris_data.data, colonnes = iris_data.feature_names) #création d'un cadre de données kmeans = KMeans(n_clusters=3,init="k-moyen++", max_iter = 100, n_init = 10, état_aléatoire = 0) #Application du classificateur Kmeans y_kmeans = kmeans.fit_predict(X) imprimer(kmeans.cluster_centers_) #afficher les centres de cluster plt.scatter(X[y_kmeans == 0, 0], X[y_kmeans == 0, 1],s = 100, c="rouge", étiquette="Iris-soyeux") plt.scatter(X[y_kmeans == 1, 0], X[y_kmeans == 1, 1],s = 100, c="bleu", étiquette="Iris versicolor") plt.scatter(X[y_kmeans == 2, 0], X[y_kmeans == 2, 1],s = 100, c="vert", étiquette="Iris-virginica") #Visualiser les clusters - Sur les deux premières colonnes plt.scatter(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:,1],s = 100, c="le noir", étiquette="Centroïdes") #tracer les centroïdes des clusters plt.légende() plt.show() |
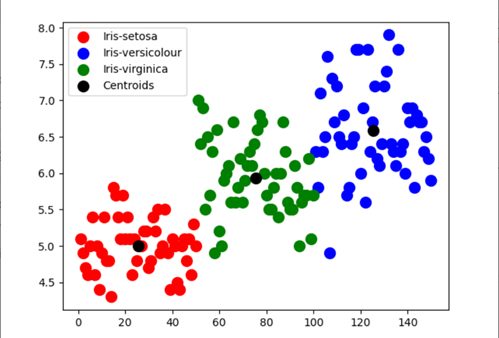
Une idée que nous pouvons tirer de Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées.... es que la precisión del modelo para determinar Setosa y Virginica es comparativamente más a Versicolour.
conclusion:
Nous avons exploré et prétraité l'ensemble de données Iris à l'aide de sklearn. base de données, ainsi que d'utiliser le fichier Iris.csv. En outre, aprendí sobre el aprendizaje supervisado y no supervisado e implementé el algoritmo de árbol de decisión y el algoritmo de regroupementLe "regroupement" Il s’agit d’un concept qui fait référence à l’organisation d’éléments ou d’individus en groupes ayant des caractéristiques ou des objectifs communs. Ce procédé est utilisé dans diverses disciplines, y compris la psychologie, Éducation et biologie, faciliter l’analyse et la compréhension de comportements ou de phénomènes. Dans le domaine de l’éducation, par exemple, Le regroupement peut améliorer l’interaction et l’apprentissage entre les élèves en encourageant le travail.. de K-means.
Les références:
https://www.kaggle.com/sixteenpython/machine-learning-with-iris-dataset
https://scikit-learn.org/stable/
https://certes.co.uk/types-of-artificial-intelligence-a-detailed-guide/
A propos de l'auteur:
Bonjour lecteur, je suis yashi saxena, et je travaille actuellement chez TCS en tant qu'ingénieur système. À LA, Le ML et la PNL ont toujours été mon intérêt, donc ici je fais un effort pour en savoir plus sur ce domaine. Vous pouvez me joindre sur Linkedin: https://www.linkedin.com/in/yashi-saxena-7a9522194/
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





