
Exigences précédentes: Langage de programmation R de base et connaissances de base en classification
Alors que l'approche de l'ensemble de validation fonctionne en divisant l'ensemble de données une fois, k-Fold le fait cinq ou dix fois. Imaginez que vous effectuez l'approche de l'ensemble de validation dix fois en utilisant un ensemble de données différent.
Disons que nous avons 100 lignes de données. Nous les divisons au hasard en dix groupes de plis. Chaque pli comprendra environ 10 lignes de données. Le premier pli sera utilisé comme ensemble de validation et le reste constitue l'ensemble de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines..... Nous entraînons ensuite notre modèle à l'aide de cet ensemble de données et calculons la précision ou la perte. Ensuite, nous répétons ce processus mais en utilisant un pli différent pour l'ensemble de validation. Voir l'image ci-dessous.
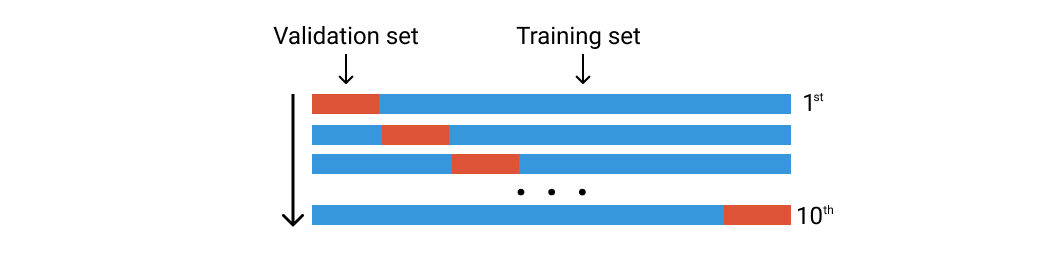
Validation croisée du K-Fold. Image de l'auteur
Passons au code
Les bibliothèques que nous utilisons sont ces deux:
une bibliothèque(bien rangé)
une bibliothèque(caret)
Les données utilisées ici sont des données sur les maladies cardiaques des soins intensifs qui peuvent être téléchargées sur Kaggle. Vous pouvez également utiliser toutes les données de classification pour cette expérience.
Les données <- lire.csv("../input/heart-disease-uci/heart.csv")
diriger(Les données)
Voici les six premières lignes des données chargées. Il y a treize prédicteurs et la dernière colonne est la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... de réponse. Vous pouvez également vérifier les dernières lignes à l'aide de la fonction tail ().
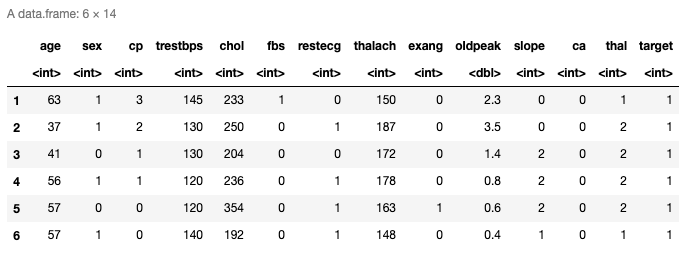
Diffusion des données
Ici, nous voulons confirmer que la distribution entre les données de deux étiquettes n'est pas très différente. Parce que des ensembles de données déséquilibrés peuvent conduire à une précision déséquilibrée. Cela signifie que votre modèle prédit toujours vers une seule étiquette., ou prédira toujours 0 O 1.
hist(data$cible,col="corail")
prop.table(tableau(data$cible))
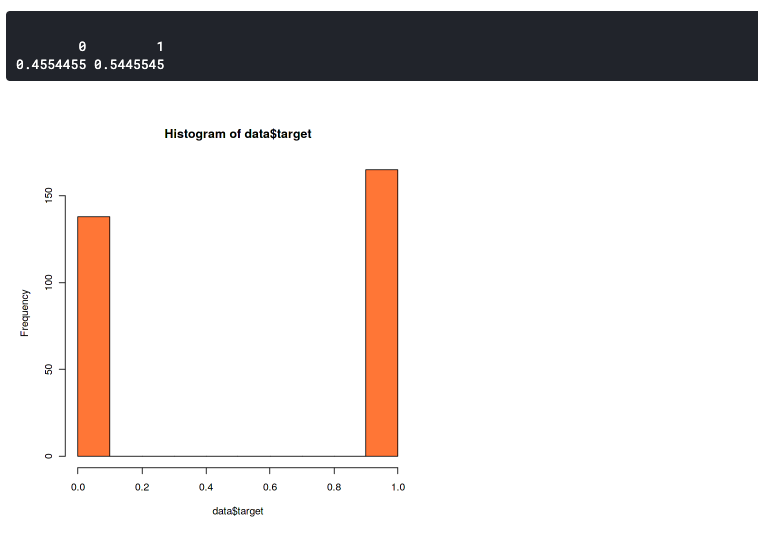
Ce graphique montre que notre ensemble de données est légèrement déséquilibré mais toujours assez bon. Il a un rapport de 46:54. Vous devriez commencer à vous inquiéter si votre ensemble de données est supérieur à 60% des données d'une classe. Dans ce cas, vous pouvez utiliser SMOTE pour gérer un ensemble de données déséquilibré.
Le pli k
set.seed(100)
trctrl <- trainControl(méthode = "CV", nombre = 10, savePredictions=TRUE)
nb_fit <- former(facteur(cible) ~., données = données, méthode = "naïve_bayes", trControl=trctrl, tuneLength = 0)
nb_fit
La première ligne consiste à définir la graine du pseudo-aléatoire afin que le même résultat puisse être reproduit. Vous pouvez utiliser n'importe quel nombre pour la valeur initiale.
Ensuite, nous pouvons définir le paramètre k-Fold dans la fonction trainControl (). Réglez le paramètre de méthode sur "cv" et le paramètre numérique sur 10. Cela signifie que nous définissons la validation croisée avec dix plis. Nous pouvons définir le numéro de pli avec n'importe quel nombre, mais le moyen le plus courant est de le régler sur cinq ou dix.
La fonction train () est utilisé pour déterminer la méthode que nous utilisons. Ici, nous utilisons la méthode Naive Bayes et définissons tuneLength sur zéro car nous nous concentrons sur l'évaluation de la méthode sur chaque pli. Nous pouvons également définir tuneLength si nous voulons effectuer le réglage de paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... pendant la validation croisée. Par exemple, si nous utilisons la méthode K-NN et que nous voulons analyser combien de K sont les meilleurs pour notre modèle.
Vous pouvez voir la méthode prise en charge dans Documentation R.
Veuillez noter que la validation croisée de k-Fold peut prendre un certain temps car vous exécutez le processus de formation dix fois.
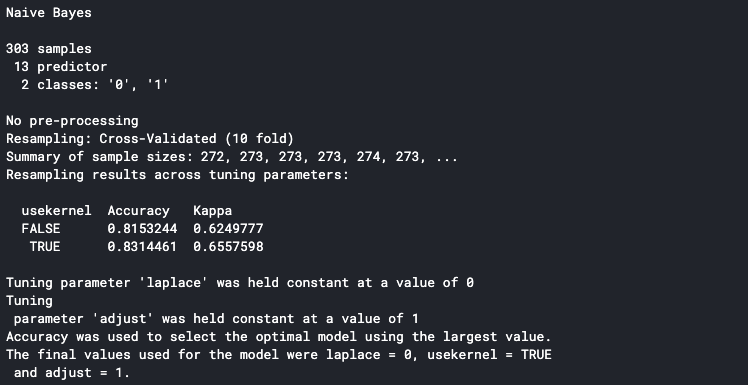
Il imprimera le détail sur la console une fois que c'est fait. La précision affichée sur la console est la précision moyenne de tous les plis d'entraînement. Nous pouvons voir que notre modèle a une précision moyenne de 83%.
Dépliez le pli en K
Nous pouvons déterminer que notre modèle fonctionne bien dans chaque pli en examinant la précision de chaque pli.. Pour faire ceci, assurez-vous de régler le enregistrerPrédictions paramètre à TRUE dans la fonction trainControl ().
pred <- nb_fit$pred
pred$equal <- sinon(pred $ pred == pred $ obs, 1,0)
chaque fois <- avant%>%
  par groupe(Rééchantillonner) %>%
  résumé_à(dont(égal),
               liste(Précision = moyenne))
chaque fois
Voici le tableau de précision dans chaque pli.
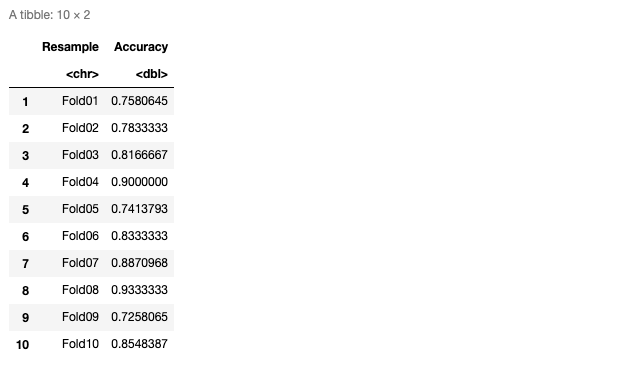
Nous pouvons également le tracer sur le graphique pour le rendre plus facile à analyser. Dans ce cas, nous utilisons le box plot pour représenter nos précisions.
ggplot(data=chaque fois, aes(x=Rééchantillonner, y=Précision, groupe=1)) +
geom_boxplot(couleur="bordeaux") +
geom_point() +
theme_minimal()
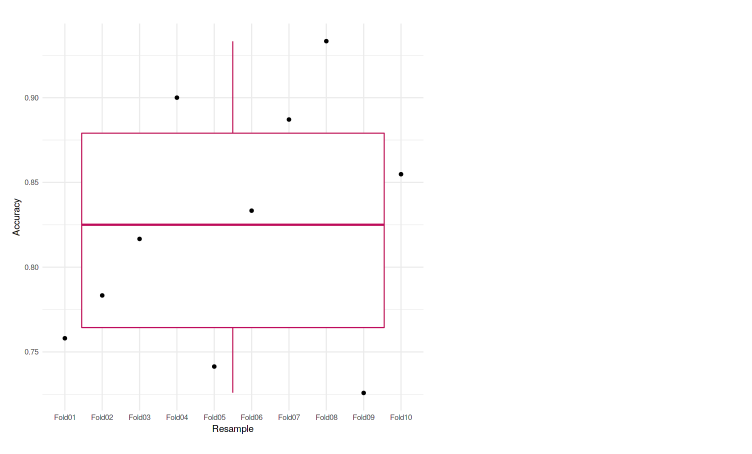
Nous pouvons voir que chacun des plis atteint une précision qui ne diffère pas beaucoup les uns des autres. La précision la plus faible est 72,58%, et aussi dans le box plot, nous ne voyons pas de valeurs aberrantes. Ce qui signifie que notre modèle fonctionnait bien sur la validation croisée de k fois.
Suivant
- Essayez un nombre différent de plis
- Faire un paramétrage
- Utiliser d'autres ensembles de données et méthodes
Brève biographie de l'auteur
Je m'appelle Mohamed Arnold, un passionné de machine learning et de science des données. Actuellement étudiante en Master en informatique en Indonésie.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





