
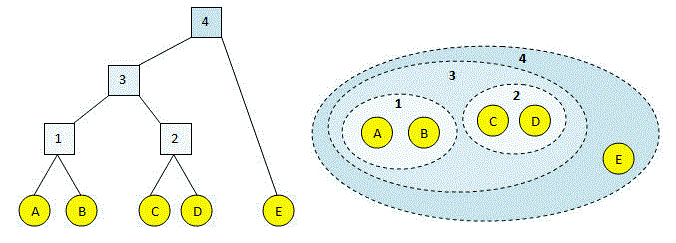
Comme nous le savons tous, Le regroupement hiérarchique aggloméré commence par le traitement de chaque observation comme un groupe individuel, puis la fusion itérative des groupes jusqu'à ce que tous les points de données soient fusionnés en un seul groupe. Los dendrogramas se utilizan para representar resultados de regroupementLe "regroupement" Il s’agit d’un concept qui fait référence à l’organisation d’éléments ou d’individus en groupes ayant des caractéristiques ou des objectifs communs. Ce procédé est utilisé dans diverses disciplines, y compris la psychologie, Éducation et biologie, faciliter l’analyse et la compréhension de comportements ou de phénomènes. Dans le domaine de l’éducation, par exemple, Le regroupement peut améliorer l’interaction et l’apprentissage entre les élèves en encourageant le travail.. jerárquico.
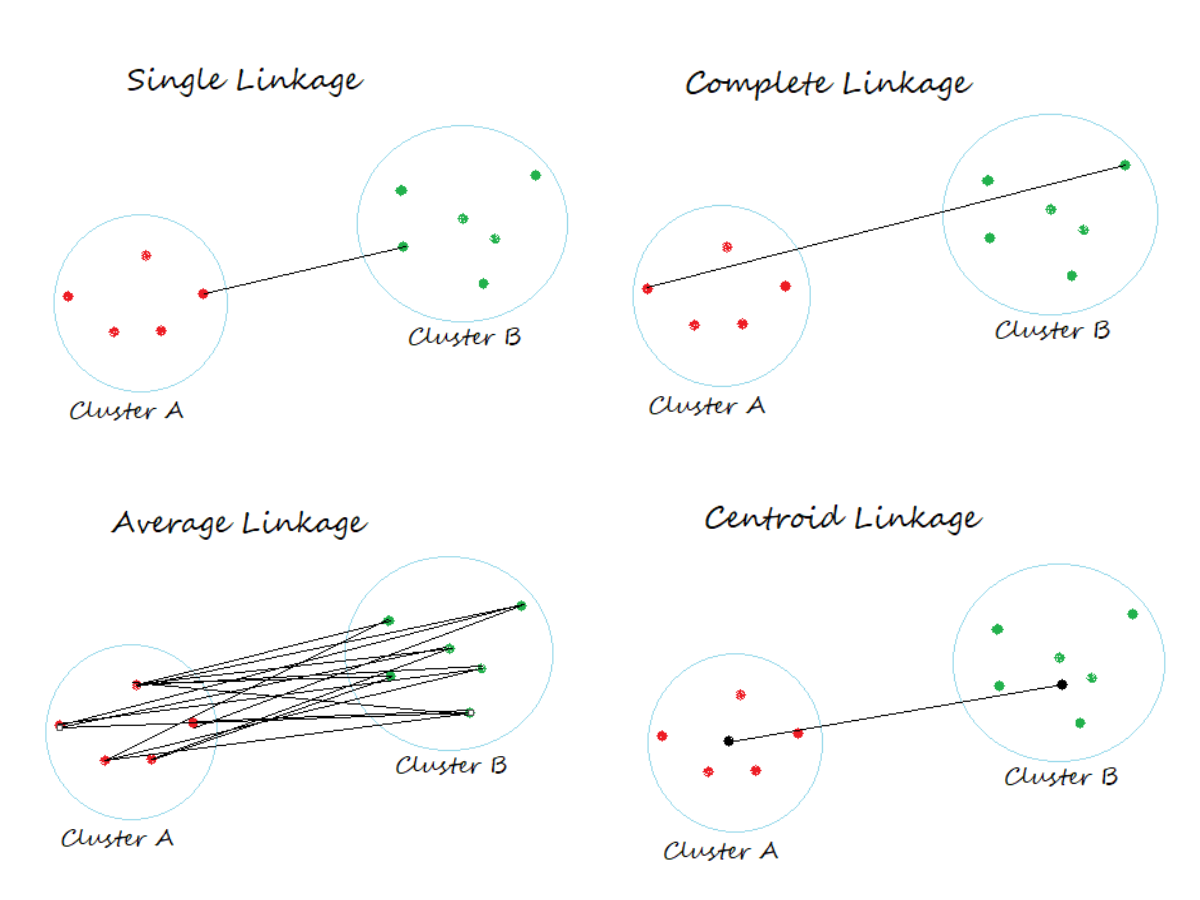
Les clusters sont fusionnés en fonction de la distance entre eux et pour calculer la distance entre les clusters, nous avons différents types de liens.
Critères de liaison:
Déterminer la distance entre les ensembles d'observations en fonction de la distance par paires entre les observations.
- Dans Lien unique, la distance entre deux groupes est la distance minimale entre les membres des deux groupes
- Dans Appairage complet, la distance entre deux groupes est la distance maximale entre les membres des deux groupes
- Dans Lien moyen, la distance entre deux clusters est la moyenne de toutes les distances entre les membres des deux clusters
- Dans Lien centroïde, la distance entre deux groupes est la distance entre leurs centroïdes
Dans cet article, notre objectif est de comprendre le processus de clustering en utilisant la méthode du lien unique.
Regroupement à lien unique:
Commencez par importer les bibliothèques nécessaires
importer numpy en tant que np
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
%matplotlib en ligne
importer scipy.cluster.hierarchy en tant que shc
à partir de scipy.spatial.distance importer squareform, pdist
Créons des données de jouets en utilisant numpy.random.random_sample
a = np.random.random_sample(taille = 5)
b = np.random.random_sample(taille = 5)
Une fois que nous avons généré les points de données aléatoires, nous allons créer un cadre de données pandas.
pointe = ['P1','P2','P3','P4','P5']
données = pd.DataFrame({'Point':point, 'une':np.tour(une,2), 'b':np.tour(b,2)})
données = données.set_index('Point')
Les données
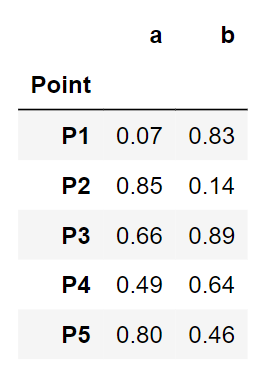
Un regard sur les données de nos jouets. A l'air propre. Passons aux étapes de regroupement.
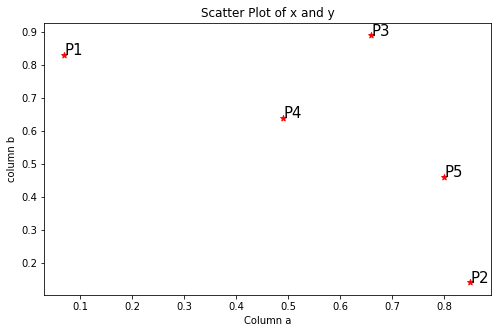
Paso 1: visualice los datos usando un Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées....
plt.figure(taille de la figue=(8,5))
plt.scatter(Les données['une'], Les données['b'], c="r", marqueur="*")
plt.xlabel('Column a')
plt.ylabel('column b')
plt.titre('Scatter Plot of x and y')pour j dans data.itertuples():
    plt.annoter(j.Index, (j.a, j.b), taille de police=15)
Paso 2: calcul de la matrice des distances dans la méthode euclidienne en utilisant pdist
dist = pd.DataFrame(forme carrée(pdist(Les données[['une', 'b']]), « euclidien »), colonnes=données.index.valeurs, index=données.index.valeurs)
Pour notre confort, nous ne considérerons que les valeurs limites inférieures du tableau comme indiqué ci-dessous.
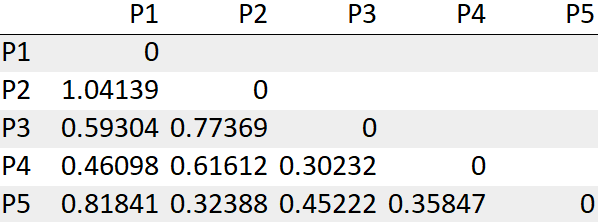
Paso 3: trouver la distance la plus courte et les combiner en un groupe
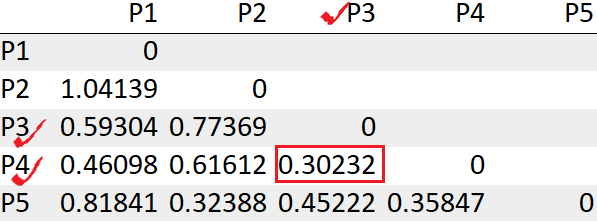
On voit les points P3, P4 a la distance minimale « 0.30232 ». Ensuite, nous allons d'abord les fusionner dans un groupe.
Paso 4: Recalculer la matrice de distance après avoir formé un groupe
Mettre à jour la distance entre le groupe (P3, P4) a P1
= Min (dist (P3, P4), P1)) -> Min (dist (P3, P1), dist (P4, P1))
= Min (0.59304, 0.46098)
= 0,46098
Mettre à jour la distance entre le groupe (P3, P4) un P2
= Min (dist (P3, P4), P2) -> Min (dist (P3, P2), dist (P4, P2))
= Minimum (0,77369, 0,61612)
= 0,61612
Mettre à jour la distance entre le groupe (P3, P4) un P5
= Min (dist (P3, P4), P5) -> Min (dist (P3, P5), dist (P4, P5))
= Minimum (0.45222, 0.35847)
= 0.35847
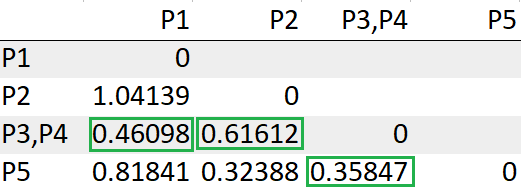
Répétez les étapes 3, 4 jusqu'à ce que nous restions avec un seul groupe.
Après avoir recalculé la matrice de distance, debemos buscar nuevamente la distancia mínima para hacer un grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois.....
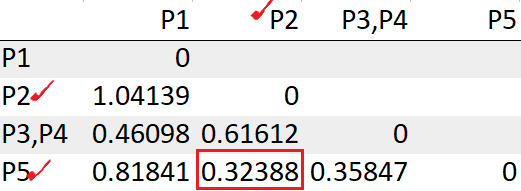
On voit les points P2, P5 a la distance minimale « 0.32388 ». Nous allons donc les regrouper dans un groupe et recalculer la matrice des distances.
Mettre à jour la distance entre le groupe (P2, P5) a P1
= Min (dist ((P2, P5), P1)) -> Min (dist (P2, P1), dist (P5, P1))
= Min (1.04139, 0.81841)
= 0,81841
Mettre à jour la distance entre le groupe (P2, P5) une (P3, P4)
= Min (dist ((P2, P5), (P3, P4))) -> = Min (dist (P2, (P3, P4)), dist (P5, (P3, P4)))
= Min (dist (0.61612, 0.35847))
= 0.35847
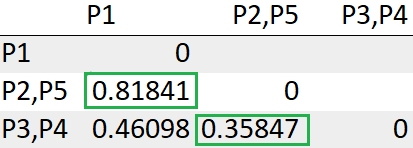
Après avoir recalculé la matrice de distance, il faut encore chercher la distance minimale.
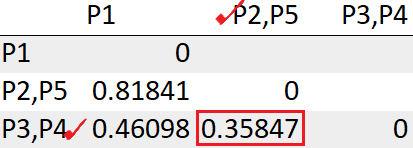
Le groupe (P2, P5) a le moins de distance du groupe (P3, P4) « 0.35847 ». Nous allons donc les regrouper.
Mettre à jour la distance entre le groupe (P3, P4, P2, P5) a P1
= Min (dist (((P3, P4), (P2, P5)), P1))
= Min (0,46098, 0,81841)
= 0,46098
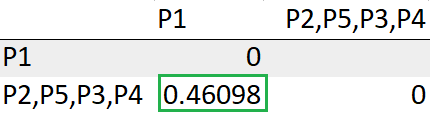
Avec ça, nous finissons par obtenir un seul cluster.
Théoriquement, ci-dessous regroupent les étapes:
- Points P3, P4 ont la distance la plus courte et sont fusionnés
- Points P2, P5 ont la distance la plus courte et sont fusionnés
- Les groupes (P3, P4), (P2, P5) ils sont regroupés
- Le groupe (P3, P4, P2, P5) fusionne avec le point de données P1
Nous pouvons visualiser la même chose en utilisant un dendrogramme.
plt.figure(taille de la figue=(12,5))
plt.titre("Dendrogramme avec encrage unique")
dend = shc.dendrogram(shc.liaison(Les données[['une', 'b']], method='single'), étiquettes=données.index)
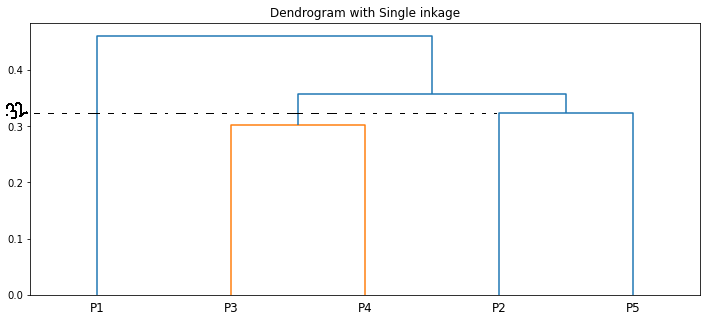
La longueur des lignes verticales dans le dendrogramme indique la distance. Par exemple, la distance entre les points P2, P5 est 0.32388.
Le regroupement pas à pas que nous avons fait est le même que celui du dendrogramme🙌
Remarques finales:
A la fin de cet article, nous connaissons le travail de fond du regroupement hiérarchique à lien unique. Dans le prochain article, nous apprendrons les autres méthodes de liaison.
Les références:
Lien du référentiel GitHub pour payer Jupyter Notebook
J'espère que ce blog vous aidera à comprendre comment fonctionne le regroupement hiérarchique à lien unique. S'il vous plait, donne-lui une tape 👏. Bon apprentissage !! 😊
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





