
introduction
Le e-commerce a révolutionné notre façon de faire nos achats. Ce téléphone que vous avez économisé pour acheter pendant des mois? C'est juste une recherche et quelques clics. Les articles sont livrés en quelques jours (Parfois même le lendemain!).
Pour les détaillants en ligne, il n'y a pas de restrictions liées à la gestion des stocks ou à la gestion de l'espace. Ils peuvent vendre autant de produits différents qu'ils le souhaitent. Les magasins physiques ne peuvent conserver qu'un nombre limité de produits en raison de l'espace limité dont ils disposent.
Je me souviens quand je commandais des livres dans ma librairie locale, et il fallait plus d'une semaine pour arriver. Cela ressemble à une histoire des temps anciens maintenant!
La source: http://www.yeebaplay.com.br
Mais les achats en ligne ont leurs propres mises en garde. L'un des plus grands défis est de vérifier l'authenticité d'un produit. Est-ce aussi bon qu'annoncé sur le site de commerce électronique? Le produit va-t-il durer plus d'un an? Les opinions des autres clients sont-elles vraiment vraies ou s'agit-il de publicité trompeuse? Ce sont des questions importantes que les clients devraient se poser avant de gaspiller leur argent.
C'est un endroit idéal pour expérimenter et appliquer des techniques de traitement du langage naturel. (PNL). Cet article vous aidera à comprendre l'importance de tirer parti des critiques de produits en ligne à l'aide de Topic Modeling.
Consultez les articles ci-dessous au cas où vous auriez besoin d'un rappel rapide sur la modélisation de thème:
Table des matières
- Importance des avis en ligne
- Approche du probléme
- Pourquoi la modélisation de thèmes pour cette tâche?
- Implémentation Python
- Lire les données
- Prétraitement des données
- Construire un modèle LDA
- Affichage des thèmes
- Autres méthodes pour profiter des avis en ligne
- Suivant?
Importance des avis en ligne
Il y a des jours, Je me suis lancé dans le commerce électronique et j'ai acheté un smartphone en ligne. C'était dans mon budget et avait une note décente de 4.5 sur 5.
Malheureusement, cela s'est avéré être une mauvaise décision car la batterie de secours était bien en dessous de la moyenne. Je n'ai pas vérifié les avis sur les produits et j'ai pris la décision hâtive de l'acheter en me basant uniquement sur ses notes. Et je sais que je ne suis pas le seul à avoir fait cette erreur!
Les évaluations seules ne donnent pas une image complète des produits que nous voulons acheter, comme je l'ai découvert à mon détriment. Donc, Par mesure de précaution, Je recommande toujours aux gens de lire les critiques d'un produit avant de décider de l'acheter ou non.
Mais alors un problème intéressant se pose. Que faire si le nombre d'avis est de centaines ou de milliers? Il n'est tout simplement pas possible de passer en revue toutes ces critiques, vérité? Et c'est là que le traitement du langage naturel triomphe.
Énoncez l'énoncé du problème
Un énoncé de problème est la graine à partir de laquelle votre analyse germe. Donc, il est vraiment important d'avoir un énoncé solide du problème, clair et bien défini.

Comment analyser un grand nombre d'avis en ligne à l'aide du traitement du langage naturel (PNL)? Définissons ce problème.
Les avis sur les produits en ligne sont une excellente source d'informations pour les consommateurs. Du point de vue des vendeurs, les avis en ligne peuvent être utilisés pour évaluer les commentaires des consommateurs sur les produits ou services qu'ils vendent. Cependant, car ces avis en ligne sont souvent accablants en termes de nombre et d'informations, un système intelligent, capable de trouver des informations clés (les sujets) de ces critiques, sera d'une grande aide pour les consommateurs et les vendeurs. Ce système aura deux objectifs:
- Laissez les consommateurs extraire rapidement les sujets clés couverts par les avis sans avoir à les parcourir tous.
- Aider les vendeurs / détaillants pour obtenir les commentaires des consommateurs sous forme de sujets (tirés des avis des consommateurs)
Pour résoudre cette tâche, nous utiliserons le concept de modélisation thématique (LDA) dans les données d'Amazon Automotive Review. Vous pouvez le télécharger à partir de ce Relier. Des ensembles de données similaires peuvent être trouvés pour d'autres catégories de produits ici.
Pourquoi devriez-vous utiliser la modélisation de thème pour cette tâche?
Comme le nom le suggère, la modélisation de sujets est un processus d'identification automatique des sujets présents dans un objet texte et de dérivation des modèles cachés présentés par un corpus de texte. Les modèles de thème sont très utiles à plusieurs fins, comprenant:
- Regroupement de documents
- Organiser de gros blocs de données textuelles
- Récupération d'informations textuelles non structurées
- Sélection de fonctionnalité
Un bon modèle de thème, lors de la formation dans un texte sur le marché boursier, devrait aboutir à des sujets comme « offre », « négociation », « dividende », « échange », etc. L'image suivante illustre le fonctionnement d'un modèle de thème typique:

Dans notre cas, au lieu de documents texte, tenemos miles de reseñas de productos en línea para los artículos enumerados en la categoría ‘Automotriz’. Notre but ici est d'extraire un certain nombre de groupes de mots importants des revues.. Ces groupes de mots sont essentiellement les sujets qui aideraient à déterminer de quoi les consommateurs parlent vraiment dans les avis..

Implémentation Python
Dans cette section, nous allons activer nos notebooks Jupyter (Ou tout autre IDE que vous utilisez pour Python!). Ici, nous allons travailler sur l'énoncé du problème défini ci-dessus pour extraire des sujets utiles de notre ensemble de données de revues en ligne en utilisant le concept de cartographie Dirichlet latente. (LDA).
Noter: Comme je l'ai mentionné dans l'introduction, Je recommande fortement de lire cet article pour comprendre ce qu'est LDA et comment cela fonctionne.
Chargeons d'abord toutes les bibliothèques nécessaires:
importer nltk
depuis nltk importer FreqDist
nltk.télécharger('stopwords') # exécuter cette fois
importer des pandas au format pd
pd.set_option("display.max_colwidth", 200)
importer numpy en tant que np
importation re
espace d'importation

importer des gensim
à partir de corpus d'importation de gensim

# bibliothèques de visualisation
importer pyLDavis
importer pyLDavis.gensim
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
%matplotlib en ligne
Pour importer les données, extrayez d'abord les données dans votre répertoire de travail, puis utilisez le read_json () fonction pandas pour le lire dans une trame de données pandas.
df = pd.read_json('Automotive_5.json', lignes=Vrai)
df.head()
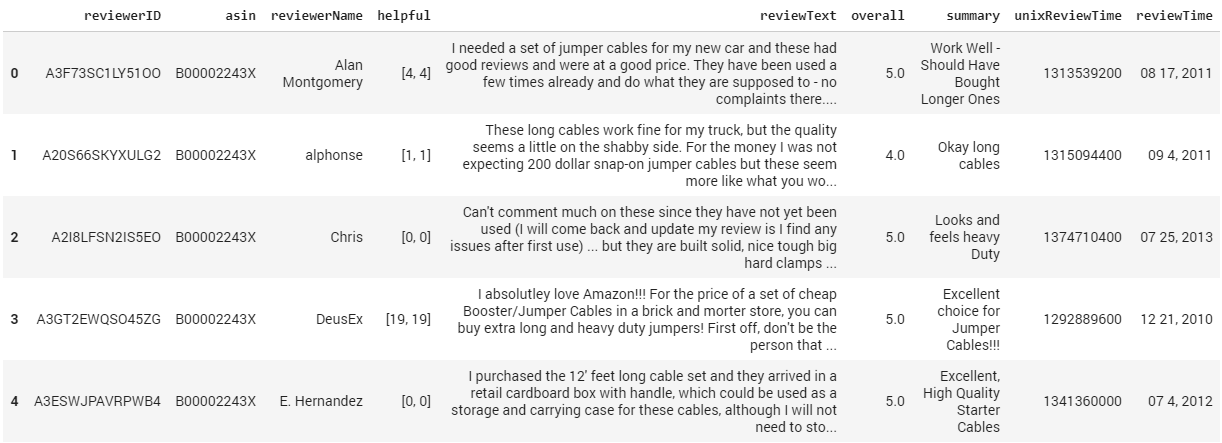
Comme tu peux le voir, les données contiennent les colonnes suivantes:
- ID de l'examinateur – ID du réviseur
- comme dans – Identifiant du produit
- nom de l'examinateur – nom de l'évaluateur
- utile – examiner la cote d'utilité, par exemple, 2/3
- reviewTexte – revoir le texte
- en général – évaluation du produit
- résumé – Résumé des commentaires
- unixReviewTime – temps de révision (heure unix)
- temps de révision – temps de révision (sans traitement)
Pour la portée de notre analyse et de cet article, nous n'utiliserons que la colonne des avis, c'est-à-dire, reviewTexte.
Prétraitement des données
Le prétraitement et le nettoyage des données est une étape importante avant toute tâche de text mining, dans cette étape, nous éliminerons les signes de ponctuation, les mots vides et nous normaliserons les révisions autant que possible. Après chaque étape de prétraitement, il est recommandé de vérifier les mots les plus fréquents dans les données. Donc, definamos una función que trazaría un graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité.... de n palabras más frecuentes en los datos.
# fonction pour tracer les termes les plus fréquents
def freq_words(X, termes = 30):
  all_words=" ".rejoindre([texte pour texte en x])
  all_words = all_words.split()

  fdist = FreqDist(tous les mots)
  mots_df = pd.DataFrame({'word':liste(fdist.keys()), 'count':liste(fdist.values())})

  # sélection du haut 20 mots les plus fréquents
  d = mots_df.nlargest(colonnes="compter", n = termes)
  plt.figure(taille de la figue=(20,5))
  ax = sns.barplot(données=d, x= "mot", y = "compter")
  hache.set(ylabel="Compter")
  plt.show()
Essayons cette fonctionnalité et découvrons quels sont les mots les plus courants dans notre ensemble de données d'examen.
mots_freq(df['reviewText'])
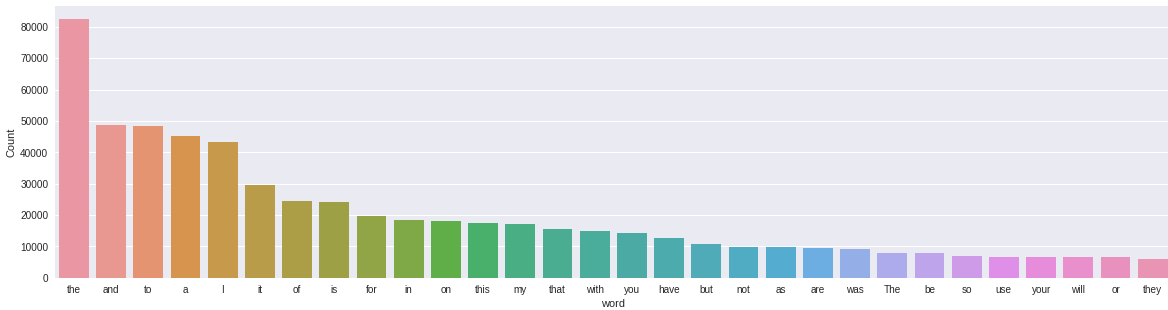
Les mots les plus courants sont « les », « Oui », « à », etc. Ces mots ne sont pas si importants pour notre tâche et ils ne racontent aucune histoire.. Il faut se débarrasser de ce genre de mots. Avant que, supprimons les scores et les nombres de nos données textuelles.
# supprimer les caractères indésirables, chiffres et symboles
df['reviewText'] = df['reviewText'].str.remplacer("[^ a-zA-Z #]", " ")
Essayons d'éliminer les mots vides et les mots courts (<2 des lettres) des critiques.
à partir de nltk.corpus importer des mots vides
mots_arrêts = mots arrêtés.mots('english')
# fonction pour supprimer les mots vides
def remove_stopwords(tour):
    rev_new = " ".rejoindre([i pour i dans rev si je ne suis pas dans stop_words])
    return rev_new

# supprimer les mots courts (longueur < 3)
df['reviewText'] = df['reviewText'].appliquer(lambda x: ' '.join([w pour w dans x.split() si len(w)>2]))

# supprimer les mots vides du texte
avis = [remove_stopwords(r.split()) pour r dans df['reviewText']]

# mettre tout le texte en minuscules
avis = [r.inférieur() pour r dans les critiques]
Retraçons les mots les plus fréquents et voyons si les mots les plus significatifs sont sortis.
mots_freq(Commentaires, 35)
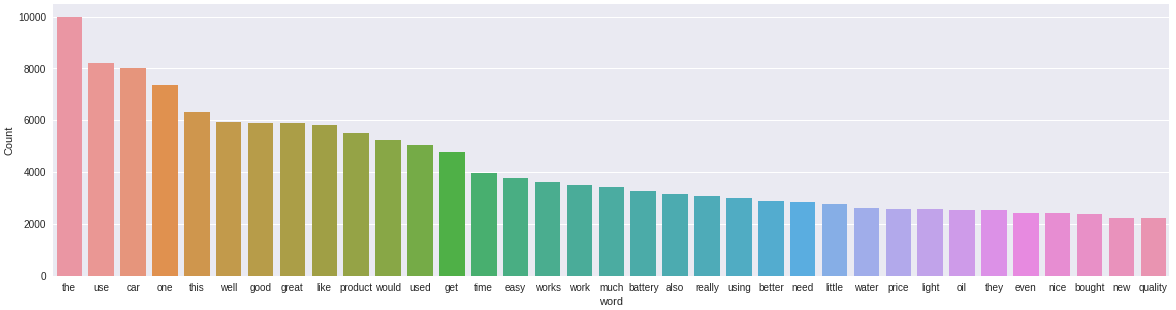
Nous pouvons voir quelques améliorations ici. Des termes tels que « batterie », « le prix », « produit », « huile », qui sont tout à fait pertinents pour la catégorie automobile. Cependant, todavía tenemos términos neutrales como ‘les’, ‘ce’, ‘beaucoup’, ‘elles ou ils’ qui ne sont pas si pertinents.
Pour supprimer davantage le bruit du texte, on peut utiliser la lemmatisation de la librairie spaCy. Réduire un mot donné à sa forme de base, réduisant ainsi plusieurs formes d'un mot à un seul mot.
!python -m spacy télécharger fr # course unique
nlp = spacy.load('en', désactiver=['parser', 'ner'])

déf lemmatisation(les textes, balises=['NOUN', 'ADJ']): # filter noun and adjective
       output = []
       for sent in texts:
             doc = pnl(" ".rejoindre(envoyé))
             output.append([token.lemma_ pour le jeton dans la doc si token.pos_ dans les balises])
       return output
Tokenize les avis, puis lemmatisons les avis tokenisés.
tokenized_reviews = pd.Series(Commentaires).appliquer(lambda x: x.split())
imprimer(tokenized_reviews[1])
['these', 'long', 'cables', 'work', 'fine', 'truck', 'quality', 'seems', 'little', 'shabby',
'side', 'pour', 'money', 'expecting', 'dollar', 'snap', 'jumper', 'cables', 'seem', 'like',
'would', 'see', 'chinese', 'knock', 'shop', 'like', 'harbor', 'freight', 'bucks']
reviews_2 = lemmatisation(tokenized_reviews)
imprimer(avis_2[1]) # imprimer la revue lemmatisée
['long', 'cable', 'fine', 'truck', 'quality', 'little', 'shabby', 'side', 'money', 'dollar',
'jumper', 'cable', 'chinese', 'shop', 'harbor', 'freight', 'buck']
Comme tu peux le voir, nous n'avons pas seulement lemmatisé les mots, mais nous avons également filtré uniquement les noms et les adjectifs. Supprimons les jetons des critiques de slogans et retraçons les mots les plus courants.
avis_3 = []
pour moi à portée(longueur(avis_2)):
    reviews_3.append(' '.join(avis_2[je]))

df['reviews'] = avis_3

mots_freq(df['reviews'], 35)
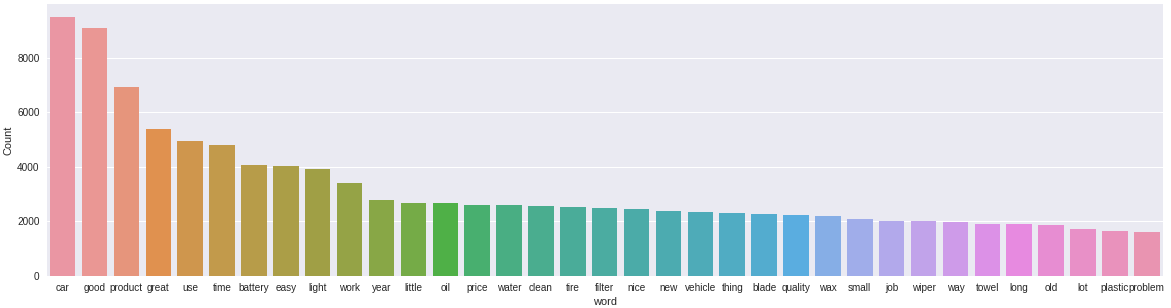
Il semble que maintenant les termes les plus fréquents dans nos données soient pertinents. Nous pouvons maintenant aller de l'avant et commencer à créer notre modèle de thème.
Construire un modèle LDA
Nous allons commencer par créer le dictionnaire des termes de notre corpus, donde a cada término único se le asigna un indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines....
dictionnaire = corpus.Dictionnaire(avis_2)
Alors, nous allons convertir la liste des révisions (avis_2) dans une matrice de termes de document en utilisant le dictionnaire préparé ci-dessus.
doc_term_matrix = [dictionnaire.doc2bow(tour) pour rev dans reviews_2]
# Création de l'objet pour le modèle LDA à l'aide de la bibliothèque gensim
LDA = gensim.models.ldamodel.LdaModel

# Construire le modèle LDA
lda_model = LDA(corpus=doc_term_matrice, id2word=dictionnaire, nombre_sujets=7, état_aléatoire=100,
                chunksize=1000, passe=50)
Le code ci-dessus prendra un certain temps. Notez que j'ai spécifié le nombre de thèmes comme 7 pour ce modèle en utilisant le nombre_sujets paramètre. Vous pouvez spécifier n'importe quel nombre de thèmes en utilisant le même paramètre.
Nous imprimons les sujets que notre modèle LDA a appris.
lda_model.print_topics()
[(0, '0.030*"auto" + 0.026*"huile" + 0.020*"filtre" + 0.018*"moteur" + 0.016*"dispositif" + 0.013*"code"
+ 0.012*"véhicule" + 0.011*"application" + 0.011*"monnaie" + 0.008*"bosch"'),
(1, '0.017*"facile" + 0.014*"installer" + 0.014*"porte" + 0.013*"ruban" + 0.013*"jeep" + 0.011*"de face" +
0.011*"tapis" + 0.010*"côté" + 0.010*"phare" + 0.008*"ajuster"'),
(2, '0.054*"lame" + 0.045*"essuie-glace" + 0.019*"pare-brise" + 0.014*"pluie" + 0.012*"neiger" +
0.012*"bon" + 0.011*"année" + 0.011*"vieille" + 0.011*"auto" + 0.009*"temps"'),
(3, '0.044*"auto" + 0.024*"serviette" + 0.020*"produit" + 0.018*"nettoyer" + 0.017*"bon" + 0.016*"la cire" +
0.014*"l'eau" + 0.013*"utilisation" + 0.011*"temps" + 0.011*"lavage"'),
(4, '0.051*"léger" + 0.039*"batterie" + 0.021*"ampoule" + 0.019*"Puissance" + 0.018*"auto" + 0.014*"brillant"
+ 0.013*"unité" + 0.011*"chargeur" + 0.010*"téléphone" + 0.010*"charger"'),
(5, '0.022*"pneu" + 0.015*"tuyau" + 0.013*"utilisation" + 0.012*"bon" + 0.010*"facile" + 0.010*"pression" +
0.009*"petit" + 0.009*"bande annonce" + 0.008*"joli" + 0.008*"l'eau"'),
(6, '0.048*"produit" + 0.038*"bon" + 0.027*"le prix" + 0.020*"super" + 0.020*"cuir" +
0.019*"qualité" + 0.010*"travail" + 0.010*"revoir" + 0.009*"amazone" + 0.009*"valeur"')]
Le quatrième thème Thème 3 a des termes comme « serviette », « nettoyer », « cera », « Eau », ce qui indique que le sujet est étroitement lié au lavage de voiture. Similaire, Thème 6 semble avoir à voir avec la valeur globale du produit, car il a des termes comme « le prix », « qualité » Oui « valeur ».
Affichage des thèmes
Pour visualiser nos thèmes dans un espace à deux dimensions, nous utiliserons le bibliothèque pyLDavis. Cette visualisation est de nature interactive et affiche les sujets ainsi que les mots les plus pertinents..
# Visualisez les sujets
pyLDAvis.enable_notebook()
vis = pyLDAvis.gensim.prepare(lda_model, doc_term_matrice, dictionnaire)
vis

Le code complet est disponible ici.
Autres méthodes pour profiter des avis en ligne
En plus des thèmes de modélisation, il existe de nombreuses autres méthodes de PNL utilisées pour analyser et comprendre les avis en ligne. Certains d'entre eux sont énumérés ci-dessous:
- Résumé du texte: Résumez les avis en un paragraphe ou en quelques puces.
- Reconnaissance d'entité: Extraire les entités des avis et identifier les produits les plus populaires (ou impopulaire) parmi les consommateurs.
- Identifier les tendances émergentes: Selon l'horodatage des avis, des thèmes ou entités nouveaux et émergents peuvent être identifiés. Cela nous permettrait de découvrir quels produits deviennent populaires et lesquels perdent leur emprise sur le marché..
- Analyse des sentiments: Pour les détaillants, comprendre le sentiment des avis peut être utile pour améliorer vos produits et services.
Suivant?
La récupération d'informations nous évite d'avoir à examiner les avis sur les produits un par un. Cela nous donne une idée claire de ce que les autres consommateurs parlent du produit.
Cependant, ne nous dit pas si les critiques sont positives, neutre ou négatif. Cela devient une extension du problème de recherche d'informations où nous devons non seulement extraire les problèmes, mais aussi déterminer le sentiment. C'est une tâche intéressante que nous aborderons dans le prochain article..
Remarques finales
La modélisation de sujet est l'une des techniques de PNL les plus populaires avec diverses applications du monde réel, comme réduction de dimensionnalité, résumé du texte, moteur de recommandation, etc. Le but de cet article était de démontrer l'application de LDA dans le texte brut généré par la foule. Les données. Je vous encourage à implémenter le code dans d'autres ensembles de données et à partager vos conclusions.
Si vous avez des suggestions, questions ou toute autre chose que vous souhaitez partager concernant la modélisation thématique, n'hésitez pas à utiliser la section commentaire ci-dessous.
Si vous cherchez à entrer dans le domaine du traitement du langage naturel, alors nous avons un cours vidéo conçu pour vous couvrant le prétraitement de texte, modélisation de thème, reconnaissance des entités nommées, l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... para PNL y muchos más temas.





