
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
Imaginez entrer dans une librairie pour acheter un livre sur l'économie mondiale et ne pas être en mesure de trouver la section du magasin qui a ce livre., en supposant que la librairie a simplement empilé toutes sortes de livres. Vous réalisez alors à quel point il est important de diviser la bibliothèque en différentes sections selon le type de livre..
La modélisation thématique est similaire à la division d'une bibliothèque en fonction du contenu des livres, car il fait référence au processus de découverte de sujets dans un corpus de texte et d'annotation des documents en fonction des sujets identifiés.
Quand vous avez besoin de segmenter, comprendre et résumer une grande collection de documents, la modélisation de sujets peut être utile.
Modélisation de thèmes à l'aide de LDA:
La mission latente de Dirichlet (LDA) est l'un des moyens de mettre en œuvre la modélisation thématique. Il s'agit d'un modèle probabiliste génératif dans lequel chaque document est supposé être composé d'une proportion différente de sujets..
Comment fonctionne l'algorithme LDA?
Les étapes suivantes sont effectuées dans LDA pour attribuer des sujets à chacun des documents:
1) Pour chaque document, initialiser aléatoirement chaque mot à un sujet parmi les K sujets où K est le nombre de sujets prédéfinis.
2) Pour chaque document de:
Pour chaque mot w dans le document, calculer:
- P (thème t | document d): Proportion de mots dans le document d qui sont affectés au sujet t
- P (palabre w | thème t): Proportion d'affectations au sujet t dans tous les documents Word provenant de w
3) Reasignar el tema T ‘a la palabra w con probabilidad p (t’ | ré) * p (w | t ‘) en tenant compte de tous les autres mots et de leurs affectations de sujet
La dernière étape est répétée plusieurs fois jusqu'à ce que nous atteignions un état stable où les affectations de sujets ne changent plus. Le ratio de sujets pour chaque document est déterminé à partir de ces affectations de sujets.
Exemple illustratif de LDA:
Disons que nous avons ce qui suit 4 documents en tant que corpus et nous souhaitons effectuer une modélisation thématique sur ces documents.
Document 1: Nous regardons beaucoup de vidéos sur YouTube.
Document 2: Les vidéos YouTube sont très instructives.
Document 3: Lire un blog technique me fait comprendre les choses facilement.
Document 4: Je préfère les blogs aux vidéos YouTube.
La modélisation LDA nous aide à découvrir des sujets dans le corpus précédent et à attribuer des mélanges de sujets pour chacun des documents. Exemple, le modèle pourrait produire quelque chose comme ci-dessous:
Thème 1: 40% vidéos, 60% Youtube
Thème 2: 95% blogs, 5% Youtube
Les documents 1 Oui 2 appartiendrait alors à 100% au sujet 1. Le document 3 appartiendrait à 100% au sujet 2. Le document 4 appartiendrait à 80% au sujet 2 et le 20% au sujet 1.
Cette affectation de sujets aux documents se fait par modélisation LDA en suivant les étapes que nous avons discutées dans la section précédente. Appliquons maintenant LDA à certaines données textuelles et analysons les résultats réels en Python.
Modélisation de thèmes à l'aide de LDA en Python:
Hemos tomado los datos de ‘Amazon Fine Food Reviews’ de Kaggle (https://www.kaggle.com/snap/amazon-fine-food-reviews) ici pour illustrer comment nous pouvons implémenter la modélisation de thèmes à l'aide de LDA en Python.
Lecture des données:
Nous commençons par importer la bibliothèque Pandas pour lire le CSV et l'enregistrer dans une trame de données.
importer des pandas au format pd
rev = pd.read_csv(r"Avis.csv")
tête.rév.()
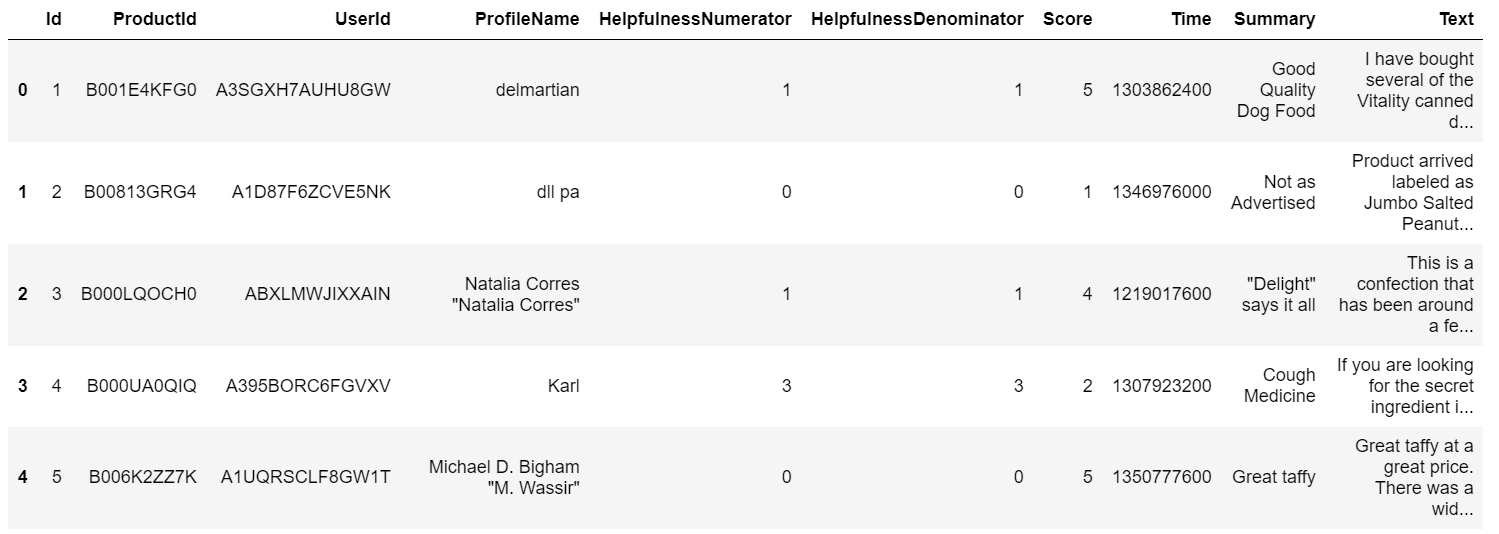
Estamos interesados en realizar un modelado de temas para la columna ‘Texte’ dans cet ensemble de données.
Importation des bibliothèques nécessaires:
Nous devrons importer la bibliothèque NLTK car nous utiliserons le stemming pour le prétraitement. En outre, nous supprimerions également les mots vides avant d'effectuer le LDA. Pour effectuer la modélisation de thème, nous devons convertir notre colonne de texte en une forme vectorisée et donc nous importons le TfidfVectorizer.
importer nltk
de nltk.corpus importer des mots vides #mots vides
à partir de nltk.stem importer WordNetLemmatizer
de sklearn.feature_extraction.text importer TfidfVectorizer
stop_words=définir(nltk.corpus.stopwords.words('english'))
Pré-traitement du texte:
Nous appliquerons la radicalisation aux mots afin que les mots racines de tous les mots dérivés soient utilisés. En outre, les mots vides sont éliminés et les mots dont la longueur est supérieure à 3.
def clean_text(gros titre):
      le=WordNetLemmatizer()
      word_tokens=word_tokenize(gros titre)
      jetons=[le.lemmatize(w) pour w dans word_tokens si w pas dans stop_words et len(w)>3]
        cleaned_text=" ".rejoindre(jetons)
      return cleaned_text
rev['cleaned_text']=tr['Text'].appliquer(texte_propre)
Vectorisation TFIDF en colonne de texte:
Réaliser une vectorisation TFIDF dans la colonne de texte nous fournit une matrice de termes du document sur laquelle nous pouvons modéliser le thème.. TFIDF fait référence à la fréquence du terme Fréquence inverse des documents, puisque cette vectorisation compare le nombre de fois où un mot apparaît dans un document avec le nombre de documents qui le contiennent.
vect =TfidfVectorizer(mots_arrêts=mots_arrêts,max_fonctionnalités=1000)
vect_text=vect.fit_transform(tour['cleaned_text'])
LDA en texte vectorisé:
Les paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... que le hemos dado al modelo LDA, comme il est montré dans ce qui suit, inclure le nombre de sujets, la méthode d'apprentissage (c'est la façon dont l'algorithme met à jour les affectations de sujets aux documents), le nombre maximum d'itérations à effectuer. out et l'état aléatoire. Les paramètres que nous avons donnés au modèle LDA, comme il est montré dans ce qui suit, inclure le nombre de sujets, la méthode d'apprentissage (c'est la façon dont l'algorithme met à jour les affectations de sujets aux documents), le nombre maximum d'itérations à effectuer. out et l'état aléatoire.
de sklearn.decomposition import LatentDirichletAllocation
lda_model=LatentDirichletAllocation(n_composants=10,
learning_method='online',random_state=42,max_iter=1)
lda_top=lda_model.fit_transform(vect_text)
Vérification des résultats:
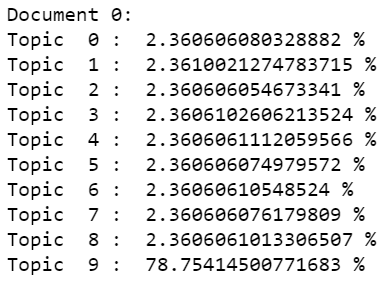
On peut vérifier la proportion de sujets qui ont été assignés au premier document à l'aide des lignes de code indiquées ci-dessous.
imprimer("Document 0: ")
pour moi,sujet à énumérer(lda_top[0]):
  imprimer("Sujet ",je,": ",sujet*100,"%")
Analyser les problèmes:
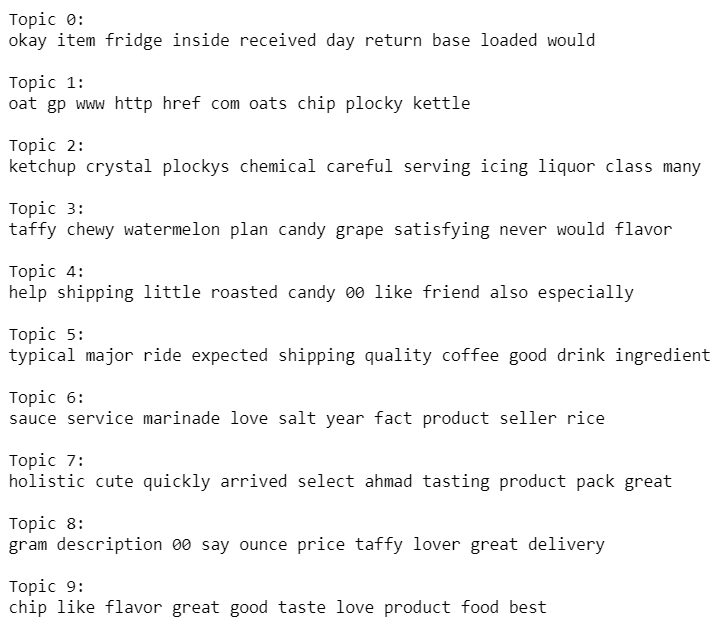
Voyons quels sont les mots principaux qui composent les sujets. Cela nous donnerait une vision de ce qui définit chacun de ces thèmes..
vocab = vect.get_feature_names()
pour moi, comp dans énumérer(lda_model.components_):
     vocab_comp = zip(vocabulaire, maquette)
     sorted_words = trié(vocab_comp, clé = lambda x:X[1], inverse=Vrai)[:10]
     imprimer("Sujet "+str(je)+": ")
     pour t en sorted_words:
            imprimer(t[0],fin=" ")
            imprimer("m")
En plus de LDA, d'autres algorithmes peuvent être utilisés pour effectuer la modélisation de thème. Indexation sémantique latente (LSI), la factorisation matricielle non négative sont quelques-uns des autres algorithmes qui peuvent être essayés pour effectuer la modélisation de thème. Tous ces algorithmes, en tant que LDA, impliquent l'extraction de caractéristiques à partir des tableaux de termes du document et la génération d'un groupe de termes qui diffèrent les uns des autres, qui a finalement conduit à la création de thèmes. Ces thèmes peuvent aider à évaluer les thèmes principaux d'un corpus et, donc, organiser de grandes collections de données textuelles.
A propos de l'auteur
Nibedita
a obtenu sa maîtrise en génie chimique de l'IIT Kharagpur en 2014 Oui
travaille actuellement en tant que consultant senior chez AbsolutData Analytics. Dans son
capacité actuelle, travaille à la création de solutions basées sur l'IA / ML pour les clients de
une variété d'industries.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





