
Cet article a été publié dans le cadre du Blogathon sur la science des données.
Vue d'ensemble
- En savoir plus sur l'algorithme d'arbre de décision dans l'apprentissage automatique pour les problèmes de classification.
- ici nous avons couvert l'entropie, gain d'information et impureté de Gini
Algorithme d'arbre de décision
algorithmes. Ce peut être utilisé à la fois pour un problème de classification et un problème de régression.
Le but de cet algorithme est de créer un modèle qui prédit la valeur d'une variable cible, pour lequel l'arbre de décision utilise la représentation de l'arbre pour résoudre le problème dans lequel le nœud feuille correspond à une étiquette de classe et les attributs sont représentés dans le nœud interne. de l'arbre.
Prenons un exemple de jeu de données pour aller plus loin....
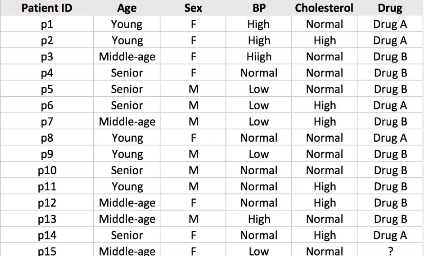
Supposons que nous ayons un échantillon de 14 ensembles de données sur les patients et nous devons prédire quel médicament suggérer au patient A ou B.
Disons que nous choisissons le cholestérol comme premier attribut pour diviser les données
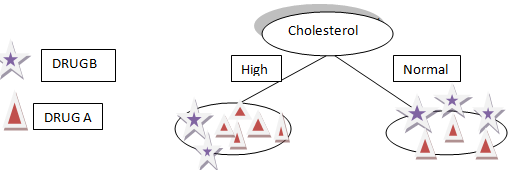
Il divisera nos données en deux branches Élevé et Normal selon le cholestérol, comme vous pouvez le voir dans la chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.... antérieur.
Supposons que notre nouveau patient a un taux de cholestérol élevé d'après la division ci-dessus de nos données que nous ne pouvons pas dire Soit Le médicament B ou le médicament A sera approprié pour le patient.
En outre, si le cholestérol du patient est normal, nous n'avons pas encore d'idée ou d'information pour déterminer si le médicament A ou le médicament B convient au patient.
Prenons un autre âge d'attribut, comme nous pouvons le voir, l'âge a trois catégories: Un jeune homme, médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes.... âge et plus, essayons de diviser.
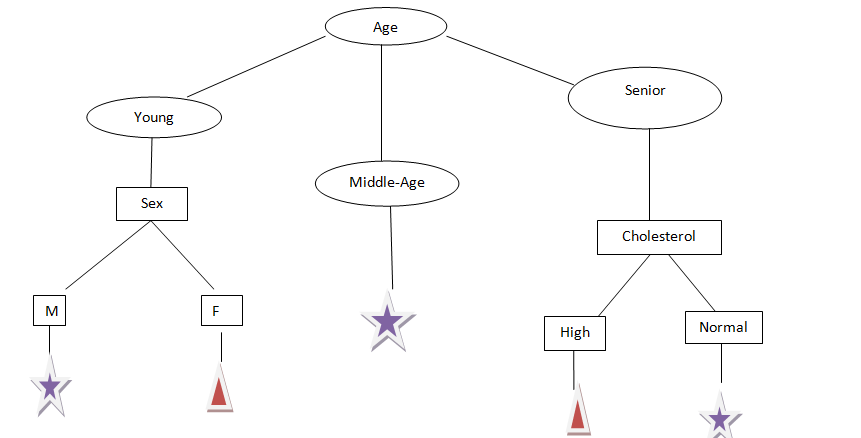
De la figure précédente, maintenant, nous pouvons dire que nous pouvons facilement prédire quel médicament administrer à un patient en fonction de ses rapports.
Hypothèses que nous faisons lors de l'utilisation de l'arbre de décision:
– Au début, nous considérons l'ensemble de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... comme la racine.
-Les valeurs caractéristiques sont préférées pour être catégorielles, si les valeurs continuent, sont convertis en discrets avant de construire le modèle.
-Basé sur les valeurs d'attribut, les enregistrements sont distribués de manière récursive.
-Nous utilisons une méthode statistique pour classer les attributs tels que nœudNodo est une plateforme digitale qui facilite la mise en relation entre les professionnels et les entreprises à la recherche de talents. Grâce à un système intuitif, Permet aux utilisateurs de créer des profils, Partager des expériences et accéder à des opportunités d’emploi. L’accent mis sur la collaboration et le réseautage fait de Nodo un outil précieux pour ceux qui souhaitent élargir leur réseau professionnel et trouver des projets qui correspondent à leurs compétences et à leurs objectifs.... racine ou nœud interne.
Les mathématiques derrière l'algorithme d'arbre de décision: Avant de passer à l'acquisition d'informations, il faut d'abord comprendre l'entropie.
Entropie: Entropie sont les mesures de impureté, désordre, O incertitude dans beaucoup d'exemples.
But de l'entropie:
L'entropie contrôle la façon dont un arbre de décision décide briser Les données. Cela affecte la façon dont un Arbre de décision tracer ses limites.
"Les valeurs d'entropie vont de 0 un 1", moins la valeur d'entropie est plus fiable.
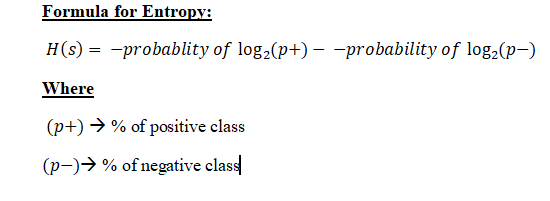
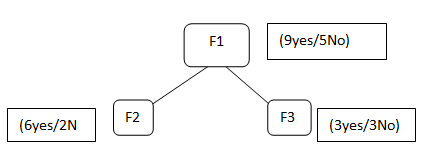
Supposons que nous ayons les caractéristiques F1, F2, F3, nous sélectionnons la caractéristique F1 comme nœud racine
F1 contient 9 étiqueter oui et 5 pas de label, après avoir divisé le F1 nous obtenons F2 qui a 6 Oui / 2 Non et F3 vous avez 3 Oui / 3 non.
À présent, si nous essayons de calculer l'entropie des deux F2 en utilisant la formule d'entropie …
Mettre les valeurs dans la formule:
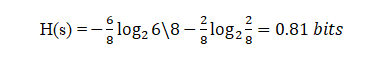
Ici, 6 est le nombre de oui pris comme positifs puisque nous calculons la probabilité divisée par 8 est le nombre total de lignes présentes dans F2.
De la même manière, si nous effectuons l'Entropie pour F3, nous obtiendrons 1 bit qui est un cas d'attribut puisqu'il y a dedans 50%, Oui et 50% non.
Cette division continuera à moins et jusqu'à ce que nous obtenions un sous-ensemble pur.
Qu'est-ce qu'un sous-ensemble pur?
Le sous-ensemble pur est une situation dans laquelle nous obtiendrons tout oui ou tout non dans ce cas.
Nous l'avons fait par rapport à un nœud, Et si après avoir divisé F2, nous pouvons également exiger un autre attribut pour accéder au nœud feuille et nous devons également prendre l'entropie de ces valeurs et les ajouter pour envoyer toutes ces valeurs d'entropie pour cela? nous avons le concept de gain d'information.
Gain d'informations: Le gain d'information est utilisé pour décider en quelle fonction diviser à chaque étape de la construction de l'arbre. La simplicité est la meilleure, c'est pourquoi nous voulons que notre arbre soit petit. Pour le faire, à chaque étape, nous devons choisir la division qui donne les nœuds enfants les plus purs. Une mesure de pureté couramment utilisée est appelée information.
Pour chaque nœud de l'arbre, la valeur d'information mesure la quantité d'informations qu'une caractéristique nous donne sur la classe. La division avec le gain d'informations le plus élevé sera considérée comme la première division et le processus se poursuivra jusqu'à ce que tous les nœuds secondaires soient purs ou jusqu'à ce que le gain d'informations soit 0.
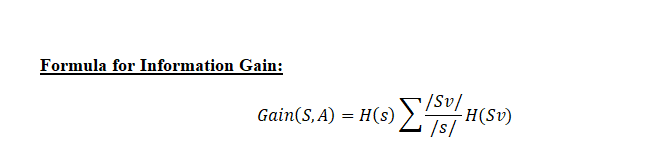
L'algorithme calcule le gain d'informations pour chaque division et la division qui donne la valeur de gain d'informations la plus élevée est sélectionnée.
Nous pouvons dire que dans Information Gain, nous allons calculer la moyenne de toutes les entropies en fonction de la division spécifique.
Sv = Échantillon total après division comme dans F2 il y a 6 Oui
S = Échantillon total comme en F1 = 9 + 5 = 14
Calculer maintenant le gain d'information:
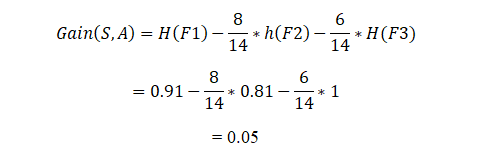
De cette manière, l'algorithme le fera pour n nombre de divisions, et le gain d'information pour la division qui est le plus grand sera pris pour construire l'arbre de décision.
Plus la valeur du gain d'information de la division est élevée, plus grande est la probabilité qu'il soit sélectionné pour la division particulière.
Gini impureté:
L'impureté de Gini est une mesure utilisée pour construire des arbres de décision afin de déterminer comment les caractéristiques d'un ensemble de données doivent diviser les nœuds pour former l'arbre. Plus précisément, l'impureté de Gini d'un ensemble de données est un nombre compris entre 0-0,5, indiquant la probabilité que des données nouvelles et aléatoires soient mal classées si elles reçoivent une étiquette de classe aléatoire en fonction de la distribution des classes dans l'ensemble de données.
Entropie vs impureté de Gini
La valeur d'entropie maximale est 1, tandis que la valeur maximale d'impureté Gini est 0,5.
Comme l'impureté de Gini
Dans cet article, nous avons couvert beaucoup de détails sur l'arbre de décision, comment ça marche et les maths derrière ça, mesures de sélection d'attributs telles que l'entropie, Gain d'informations, L'impureté de Gini avec ses formules et comment l'algorithme d'apprentissage automatique la résout.
À ce point, J'espère que vous avez une idée sur l'arbre de décision, l'un des meilleurs algorithmes d'apprentissage automatique pour résoudre un problème de classification.
Comme neuf, Je vous conseille d'apprendre ces techniques et de comprendre leur mise en oeuvre puis de les implémenter dans vos modèles.
pour mieux comprendre, voir https://scikit-learn.org/stable/modules/tree.html
Les supports présentés dans cet article ne sont pas la propriété d'Analytics Vidhya et sont utilisés à la discrétion de l'auteur..





