
introduction
Au lieu de commencer par la définition des statistiques, Je veux commencer par la citation de la définition de la statistique de Karl Pearson, « Les statistiques sont le
grammaire des sciences".
Récemment, tout le monde parle de données. Après avoir entendu le mot « Données » Les Les questions fondamentales qui se posent dans nos esprits sont,
Qu'est-ce que les données?
Comment les données sont-elles collectées?
Comment analyser les données?
Comment les données sont-elles interprétées?
Pour répondre à toutes ces questions, le terme « Statistiques » on utilise. Les statistiques sont l'outil de base et important pour traiter les données. Venons-en maintenant à la définition des statistiques, il s'agit de la compilation, descriptif, analyse des données et conclusion.
Il existe deux types de statistiques, Statistiques descriptives et inférentielles.
Dans Statistiques descriptives, à partir de l'observation donnée, les données sont résumées. Le résumé est effectué en considérant l'échantillon de population en utilisant la moyenne ou l'écart type.
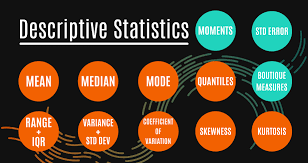
Il existe quatre catégories différentes dans les statistiques descriptives. Fils,
- Mesure de fréquence
- Mesure de dispersion
- Mesure de tendance centrale
- Mesure de position.
Basé sur le nombre de fois qu'une donnée particulière s'est produite, la mesure de fréquence est définie. La mesure de dispersion peut être définie en fonction de la plage, l'écart, l'écart type, etc. La moyenne, la médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes...., le mode et l'asymétrie des données respectives sont inclus dans la mesure de la tendance centrale. Finalement, Sur la base du centile et du quartile, la position est mesurée.
Puis en regardant Statistiques déductives, une fois les données collectées, tabuler et analyser, le résumé ou l'inférence est dérivé en utilisant des statistiques inférentielles. Les inférences sont tirées sur la base de la variation de l'échantillon et de l'erreur d'observation.
Sur la base des informations et de la conclusion tirées de l'échantillon, les statistiques déductives nous aident à prédire et à estimer les résultats pour la population.
ANALYSE DES DONNÉES STATISTIQUES
Les statistiques sont utilisées dans divers secteurs de notre vie quotidienne pour analyser les données correctes. Sur la base de l'interprétation, des mesures de développement sont prises dans les secteurs public et privé.
Avant de commencer l'analyse des données, il y a des choses à retenir.
Définir votre question, collecter les bonnes données, comprendre les données, nettoyer les données, analyser les données et enfin interpréter les résultats des questions.
Qu'est-ce qui définit la question? Pour une organisation, les étapes d'amélioration sont tirées de l'analyse des données précédentes. Pour de meilleurs pas, il y aura des objectifs à répondre parfaitement pour donner une bonne interprétation. La question doit donner la solution possible au problème. Pour ce cadre, une question pertinente est plus importante. Basé uniquement sur les questions, les données seront collectées. Ensuite, la définition de la question joue un rôle important.
Par exemple, dans une entreprise, si l'attrition des employés est élevée. La solution pour réduire le transfert du salarié de l'entreprise doit être tracée afin que les variables de base telles que l'expérience du salarié, votre niveau satisfaisant, votre promo, durée de la journée de travail, etc., sont déterminés afin que le problème puisse être résolu pour donner une solution possible.
Comment collecter les bonnes données? La collecte de données a deux classifications. L'un correspond aux données primaires et l'autre aux données secondaires. Dans les données primaires, les données seront recueillies au moyen de questionnaires, en envoyant des e-mails ou en contactant chaque personne. Par exemple le recensement. Tandis que, en données secondaires, son los datos que ya están disponibles en la fuente secundaria como agencia o base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.....
À présent, avant de collecter les nouvelles données, identifier les données existantes disponibles dans la base de données. À part ça, recueille les données pertinentes pour satisfaire l'objectif. Alors, organiser les données existantes avec de nouvelles données pour poursuivre l'analyse. Par exemple: Reprenant le même cas de cessation d'emploi, les données à collecter sont l'expérience dans l'entreprise, les heures de travail, Qualification pour l'éducation, distance de la maison, temps de voyage, ascension, âge de l'employé, incrémenter ou marcher, etc., ces Il est important de collecter des données pour trouver la raison de l'abandon des employés. Il peut y avoir peu de variables qui sont déjà disponibles dans la base de données et de nouvelles variables peuvent être ajoutées au besoin.
Pourquoi devons-nous comprendre les données? Une fois les données collectées, de nombreuses variables peuvent être directement ou indirectement liées à l'objectif.. Pour ça, nous devons d'abord étudier toutes les variables, ya mer nominal u ordinal. La préparation des données pour l'analyse se fait après avoir compris les données. Alors que nous comprenons, nous apprenons à connaître les types de données, lignes et colonnes, manquant dans les données, trouver les variables indépendantes et dépendantes, etc.
Il peut y avoir peu de variables qui ne sont pas liées à la question de l'organisation et ces variables peuvent être utilisées à l'avenir pour une analyse future.. Pour trouver ce genre de variables, il est plus important de comprendre les données. Prenant le même exemple d'attrition des employés, il peut y avoir des données relatives à la famille, en tant que membres de la famille, années d'expérience dans une entreprise précédente, statut social, etc., y cada variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... debe entenderse de manera que dividir los datos de tal manera por responder a la pregunta.
Comment se fait le nettoyage des données? Le nettoyage des données est le processus de modification des données, supprimer les variables en double et créer des variables factices si nécessaire. Supprimer les colonnes indésirables qui ne sont pas liées à la question. Si le nettoyage des données n'est pas adéquat, peut conduire à une précision moindre du modèle et peut conduire à des conclusions trompeuses.
Une fois le nettoyage des données terminé, les données correctes pour répondre à la question sont prêtes. La manipulation des données se fait de plusieurs manières, comment tracer les données, créer des tableaux croisés dynamiques pour les variables, corrélation, régression et détecter les valeurs aberrantes. Le processus peut avoir lieu. Pendant la phase de manutention, il peut être nécessaire de continuer avec un ensemble de données existant ou de supprimer un ensemble de données ou il peut être nécessaire d'ajouter des données supplémentaires pour répondre à la question. Après toutes ces étapes, les données requises seront prêtes pour l'analyse.
Comment analyser les données? Quand il s'agit de parler d'analyse, l'essentiel est que la sélection des modèles. La sélection du modèle joue un rôle important dans l'analyse des données et la réponse à l'objectif. La définition des variables dépendantes et indépendantes est l'étape importante de l'analyse des données.. Actuellement, les techniques d'apprentissage automatique sont utilisées pour l'analyse des données, afin que les prédictions et les interprétations puissent être faites facilement. Mais reste, certains objectifs peuvent être répondus directement tout en effectuant une visualisation des données et une analyse statistique de base. Les outils utilisés pour analyser les données sont, Python, Exceller, programmation R, SPSS, ÉTAIT, etc.,
Corrélation est utilisé pour trouver la relation ou l'association entre deux ou plusieurs variables. La corrélation est entre les valeurs -1 une +1. L'interprétation est que, si la corrélation est +1 alors il est fortement corrélé positivement, -1 alors il est fortement corrélé négativement et 0 implique qu'il n'y a pas de corrélation. La corrélation fonctionne à la fois pour les données quantitatives et qualitatives.
Arriver à régression, cette analyse est utilisée lorsque nous avons besoin de trouver les dépendances d'une variable sur l'autre. La valeur de régression est comprise entre 0 Oui 1. Si la valeur de régression est 1, donc c'est un ajustement parfait et 0, donc pas bien adapté. Le modèle prédictif peut être réalisé à l'aide d'une analyse de régression. Cela utilise également des données quantitatives et qualitatives. Il existe deux types d'analyse de régression. Régression linéaire et régression linéaire multiple.
Dans Régression linéaire, a une variable dépendante et une variable indépendante. Par exemple, si le prix est bas, les ventes seront élevées. Dans le cas d la régression linéaire multiple maquette, a une variable indépendante et plusieurs variables dépendantes. Par exemple, le prix de la maison dépend du nombre de pièces de la maison, superficie de chaque pièce, nombre de places de parking, installations, Lieu, etc.
Dans le cas d Analyse de survie, si les données se réfèrent au moment de survenance d'un événement, alors l'analyse de survie peut être appliquée. L'événement aura comme résultat 0 O 1. Par exemple, la survie du patient à une crise cardiaque peut être indiquée par 0 O 1. 0 désigne la personne qui n'a pas survécu et 1 indique qu'il a survécu. Ceci peut être prédit en prenant les variables comme âge, fumeur ou non-fumeur, personne vivant en milieu urbain ou rural, avoir une tension artérielle ou non. Sur la base de tous les facteurs pris en compte, le statut de survie de la personne peut être estimé. Actuellement, l'analyse de survie peut être appliquée dans le cas des patients COVID.
Enfin arriver à la partie de Techniques d'apprentissage automatique, comme la forêt aléatoire, Arbre de décision, KNN, etc., peut être appliqué dans le cas de la technique de prédiction et de classification. Sur l'exemple de l'attrition des employés, le ciblage de l'employé qui peut quitter l'entreprise peut être déterminé à l'aide de la technique de classification. Différents modèles peuvent être développés et, basé sur la précision des modèles, vous pouvez déterminer quel modèle peut prédire l'attrition future des employés. Si la précision est plus grande, ce modèle particulier peut être utilisé pour prédire les données futures.
Interprétation le résultat: Après avoir analysé les données, il est temps d'interpréter le résultat. Lors de l'interprétation du résultat, vérifiez si l'analyse a répondu à toutes les questions qui ont été formulées, les données recueillies ont aidé à l'analyse, et de l'interprétation il y a un résultat positif pour l'amélioration de l'objectif. En considérant notre exemple d'attrition des employés, la partie analyse devrait suggérer de meilleures mesures ou améliorations pour réduire l'attrition des employés de l'entreprise.
Ce sont les bases les plus importantes à faire et à observer lors de la réalisation d'une analyse de données statistiques.
Finalement, Je souhaite citer les paroles de Seth Godin: « Les données ne sont pas utiles tant qu'elles ne sont pas converties en informations «
J'espère que tout le monde a trouvé des informations de base sur les statistiques et l'analyse des données à l'aide de statistiques.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





