
Si tu sais 10 des personnes qui travaillent dans le domaine de la science des données depuis plus de 5 ans, Tout le monde connaît ou a probablement utilisé SQL à un moment donné d'une manière ou d'une autre !! Tel est le degré d'influence que SQL a eu sur tout ce qui concerne les données structurées.
Dans ce billet, nous allons apprendre les bases de SQL et nous concentrer sur SQL pour SGBDR. Comme vous le verrez, SQL est assez facile à apprendre et à comprendre.
Qu'est-ce que SQL?
SQL signifie Structured Query Language. C'est un langage de programmation standard pour accéder à une base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.... relationnel. Il a été conçu pour la gestion des données dans les systèmes de gestion de bases de données relationnelles (SGBDR) como Oracle, MySQL, Serveur MS SQL, IBM DB2.
SQL est l'un des premiers langages commerciaux utilisés pour le modèle relationnel d'Edgar F.. Morue, décrit plus en détail dans son article influent de 1970, "Un modèle de données relationnel pour les grandes bases de données partagées. «
Précédemment, SQL était un langage de facto pour la génération de professionnels des technologies de l'information. Cela était dû au fait que les magasins de données étaient constitués de l'un ou l'autre des SGBDR. La simplicité et la beauté du langage ont permis aux professionnels de l'entreposage de données d'interroger et de fournir des données aux analystes commerciaux.
Malgré cela, le problème avec les SGBDR est qu'ils ne conviennent souvent que pour des informations structurées. Pour des informations non structurées, aux bases de données les plus récentes comme MongoDB et HBaseHBase est une base de données NoSQL conçue pour gérer de grands volumes de données distribuées dans des clusters. Basée sur le modèle en colonnes, permet un accès rapide et évolutif à l'information. HBase s'intègre facilement avec Hadoop, ce qui en fait une option populaire pour les applications nécessitant le stockage et le traitement de grandes quantités de données. Sa flexibilité et sa capacité de croissance la rendent idéale pour les projets de big data.... (le Hadoop) s'avérer plus adapté. Une partie de cela est une compensation dans les bases de données, ce qui est dû au théorème CAP.
Qu'est-ce que le théorème CAP?
Le théorème CAP indique que, Dans le meilleur des cas, nous pouvons aspirer à deux des trois propriétés suivantes. CAP signifie:
Cohérence – Cela signifie que les données de la base de données restent cohérentes après l'exécution d'une opération.
Disponibilité – Cela signifie que le système de base de données est toujours opérationnel pour garantir la disponibilité..
Tolérance de partition – Cela signifie que le système continue de fonctionner même si le transfert d'informations entre les serveurs n'est pas fiable..
Les différentes bases de données et leurs relations avec le théorème CAP sont présentées ci-dessous:
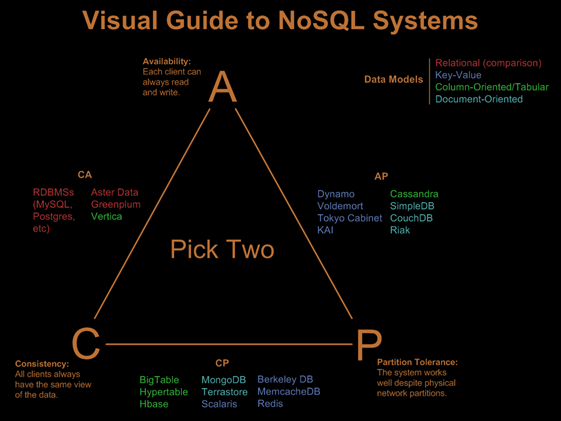
Propriétés de la base de données:
Malgré cela, ongle transactionLa "transaction" fait référence au processus par lequel un échange de biens a lieu, services ou argent entre deux ou plusieurs parties. Ce concept est fondamental dans le domaine économique et juridique, puisqu’il implique un accord mutuel et la prise en compte de conditions spécifiques. Les transactions peuvent être formelles, sous forme de contrats, ou informel, et sont essentielles au fonctionnement des marchés et des entreprises.... la base de données doit être compatible avec ACID. ACID signifie atomique, cohérent, isolé et durable, comme expliqué ci-dessous:
Atomique: Une transaction doit être complétée avec toutes vos modifications de données ou non.
Cohérent: A la fin de l'opération, toutes les données doivent rester cohérentes.
Isolé : Les modifications de données effectuées par une transaction doivent être indépendantes des autres transactions.
Durable : A la fin de l'opération, les effets des modifications apportées par la transaction doivent être permanents dans le système.
Pour contrer l'ACIDE, des services cohérents fournissent des fonctionnalités BASE (Disponible simplement, état doux, cohérence à terme).
Jeu de commandes en SQL
SÉLECTIONNER- Voici un exemple d'une requête SÉLECTIONNERLa commande "SÉLECTIONNER" est fondamental en SQL, utilisé pour interroger et récupérer des données d'une base de données. Permet de spécifier des colonnes et des tables, en filtrant les résultats avec des clauses telles que "OÙ" et en triant avec "COMMANDÉ PAR". Sa polyvalence en fait un outil essentiel pour la manipulation et l'analyse des données, facilitant l'obtention d'informations spécifiques de manière efficace.... qui renvoie une liste de livres bon marché. La requête récupère toutes les lignes du Une bibliothèque tableau dans lequel le le prix La colonne contient une valeur inférieure à 10,00. Le résultat est trié par ordre croissant par le prix. L'astérisque dans le choisir la liste indique que toutes les colonnes du Livre
SÉLECTIONNER *
 DE  Bibliothèque
 OÙ"OÙ" est un terme anglais qui se traduit par "où" en espagnol. Utilisé pour poser des questions sur l’emplacement des personnes, Objets ou événements. Dans des contextes grammaticaux, Il peut fonctionner comme un adverbe de lieu et est fondamental dans la formation des questions. Son application correcte est essentielle dans la communication quotidienne et dans l’enseignement des langues, faciliter la compréhension et l’échange d’informations sur les positions et les orientations.... le prix < 10.00
 ORDRE PAR le prix;
Le tableau doit être inclus dans le jeu de résultats.
AMÉLIORER –
Cette requête permet de mettre à jour les tables d'une base de données. De plus, il est possible de combiner la requête SELECT avec l'opérateur GROUP BYLa clause "GROUP BY" en SQL est utilisée pour regrouper les lignes partageant des valeurs dans des colonnes spécifiques. Cela permet d'effectuer des fonctions d'agrégation, comme SOMME, COUNT ou AVG, sur les groupes résultants. Son utilisation est essentielle pour analyser les données et obtenir des résumés statistiques. Il est important de se rappeler que toutes les colonnes sélectionnées qui ne font pas partie d'une fonction d'agrégation doivent être incluses dans la clause "GROUP BY".... pour ajouter des statistiques d'une variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... numérique par une variable catégorielle.
LES ARTICULATIONS-
Pour cela, SQL est largement utilisé non seulement pour interroger des données, mais aussi de joindre les données renvoyées par de telles requêtes ou tables. La Fusion de donnéesLa fusion de données est un processus qui intègre des informations provenant de sources diverses pour obtenir un ensemble unifié et cohérent. Cette technique est fondamentale dans des domaines tels que l’intelligence artificielle, Exploration et analyse de données, car il améliore la précision et la qualité des analyses. En combinant des données hétérogènes, On peut découvrir des modèles et des tendances qui, d'une autre manière, passerait inaperçu.... en SQL, cela se fait via ‘syndicats’. L'infographie suivante est souvent utilisée pour expliquer les jointures SQL:
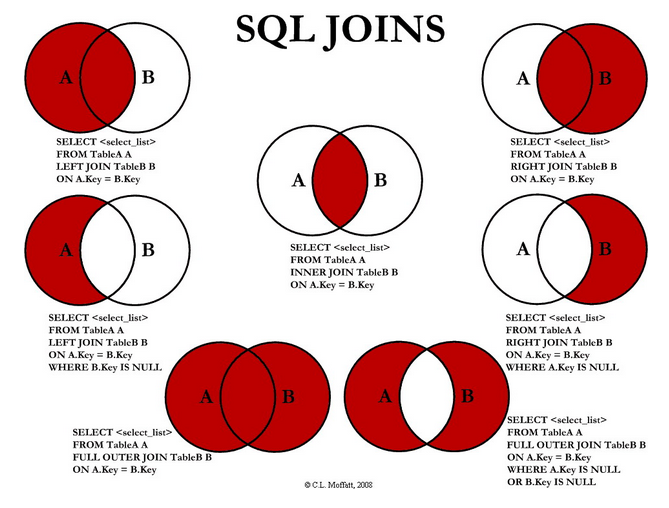
Comment utiliser rejoindre"REJOINDRE" est une opération fondamentale dans les bases de données qui permet de combiner des enregistrements de deux tables ou plus en se basant sur une relation logique entre elles. Il existe différents types de JOIN, comme INNER JOIN, LEFT JOIN et RIGHT JOIN, chacun avec ses propres caractéristiques et usages. Cette technique est essentielle pour effectuer des requêtes complexes et obtenir des informations plus pertinentes et détaillées à partir de plusieurs sources de données.... et SQL
CAS- Nous avons l'opérateur de cas / lorsque / alors / autre / qu'un SQL. Fonctionne comme mais
dans d'autres langages de programmation:
CAS LORSQUE m > 0
 ALORS 'positif'
 LORSQUE m < 0
 ALORS 'négatif'
 AUTRE 'zéro'
 FINIR
Sous-requêtes imbriquées – Les requêtes peuvent être imbriquées afin que les résultats d'une requête puissent être utilisés dans une autre requête via un opérateur relationnel ou une fonction d'agrégation. Une requête imbriquée est également appeléesous-requêteUne sous-requête est une requête à l'intérieur d'une autre requête en SQL. Elle est utilisée pour obtenir des résultats d'une base de données qui dépendent des résultats d'une requête externe. Les sous-requêtes peuvent apparaître dans les clauses SELECT, WHERE ou FROM, et permettent de réaliser des opérations plus complexes en filtrant ou en modifiant les données de manière efficace. Une utilisation appropriée optimise les performances et la clarté du code SQL....
.
Où utilisons-nous SQL?
- SQL a été largement utilisé pour récupérer des données, fusionner des données, groupe de requêtes et cas imbriqués sur des décennies. Même pour la science des données, SQL a été largement adopté. Ensuite, quelques exemples d'utilisation spécifique de l'analyse SQL sont présentés:
- Dans le cas du langage SAS qui utilise PROC SQL, nous pouvons écrire des requêtes SQL pour interroger, mettre à jour et manipuler les données.
- Un R, Le package sqldf peut être utilisé pour exécuter des requêtes SQL sur des trames de données.
Et Python, La bibliothèque pandasql vous permet d'interroger les Pandas DataFrames à l'aide de la syntaxe SQL.
SQL influence-t-il également d'autres langages?
L'inconvénient des bases de données relationnelles est qu'elles ne peuvent pas gérer les données non structurées. Pour faire face à l'apparence, De nouvelles bases de données ont émergé et reçoivent NoSQL comme nom alternatif au SGBD. Mais SQL n'est pas encore mort. Voir également:
Un mappage de SQL vers MongoDB
Voici quelques langages dans lesquels SQL a une influence significative:
.
SQL-Mapreduce
– Teradata utilise la base de données Aster qui utilise SQL avec CarteRéduireMapReduce est un modèle de programmation conçu pour traiter et générer efficacement de grands ensembles de données. Propulsé par Google, Cette approche décompose le travail en tâches plus petites, qui sont répartis entre plusieurs nœuds d’un cluster. Chaque nœud traite sa partie, puis les résultats sont combinés. Cette méthode vous permet de faire évoluer les applications et de gérer d’énormes volumes d’informations, fondamental dans le monde du Big Data.... pour de grands ensembles de données à l'ère du Big Data. SQL-MapReduce® est un framework créé par Teradata Aster pour permettre aux développeurs d'écrire des fonctions SQL-MapReduce puissantes et très expressives dans des langages tels que Java, C #, Python, C ++ et R et les amener sur la plate-forme de découverte pour des analyses hautes performances. Après, les analystes peuvent invoquer les fonctions SQL-MapReduce en utilisant SQL standard ou R via la base de données Aster.
Spark SQL – Le projet Spark d'Apache est destinéTraitement en temps réel, données Hadoop en mémoire et parallèles
. Spark SQL s'appuie dessus pour permettre l'écriture de requêtes SQL dans les données. Dans Impala de Cloudera, les données stockées dans HDFSHDFS, o Système de fichiers distribués Hadoop, Il s’agit d’une infrastructure clé pour stocker de gros volumes de données. Conçu pour fonctionner sur du matériel commun, HDFS permet la distribution des données sur plusieurs nœuds, Garantir une disponibilité élevée et une tolérance aux pannes. Son architecture est basée sur un modèle maître-esclave, où un nœud maître gère le système et les nœuds esclaves stockent les données, faciliter le traitement efficace de l’information.. ou HBase peuvent être interrogées, et la syntaxe SQL est la même que celle d'Apache RucheHive est une plateforme de réseaux sociaux décentralisée qui permet à ses utilisateurs de partager du contenu et de se connecter avec d'autres sans l'intervention d'une autorité centrale. Elle utilise la technologie blockchain pour garantir la sécurité et la propriété des données. Contrairement à d'autres réseaux sociaux, Hive permet aux utilisateurs de monétiser leur contenu via des récompenses en cryptomonnaies, ce qui favorise la création et l'échange actif d'informations.....
Voir également: En savoir plus sur les manières d'interroger Hadoop à l'aide de SQLici
.
Remarques finales
Dans cet article, nous discutons de SQL, ses utilisations, le théorème CAP et l'influence de SQL sur d'autres langages. Une connaissance de base de SQL est très pertinente dans le monde d'aujourd'hui, où python, R, Les SAS sont des langages dominants en science des données. SQL est toujours d'actualité à l'ère du BIG DATA. La beauté de la langue reste sa structure élégante et simple. Pot de réflexion:
Pensez-vous que SQL est devenu une arme incontournable pour la gestion des données? Recommanderiez-vous d'autres langues de base de données?
Partagez vos points de vue / opinion / commentaires avec nous dans la section commentaire ci-dessous. Nous serions ravis de vous entendre!! Si vous aimez ce que vous venez de lire et souhaitez continuer à apprendre sur l'analyse,abonnez-vous à nos e-mails , Suivez-nous sur Twitter ou comme le nôtrepage le Facebook
.
En rapport





