
avant de continuer, analysons brièvement Gratté et après Grattoir automatique:
Qu'est-ce que le grattage?
Le grattage Web est une technique fondamentale utilisée pour extraire des informations utiles telles que les contacts, courriers électroniques, images, URL, etc... des sites. L'autre forme de grattage Web est l'exploration. Utilisé lorsque nous avons besoin d'une grande quantité de données structurées et étiquetées pour les fondamentaux industriels. Le logiciel de grattage Web peut accéder directement au World Wide Web à l'aide de protocoles HTML.
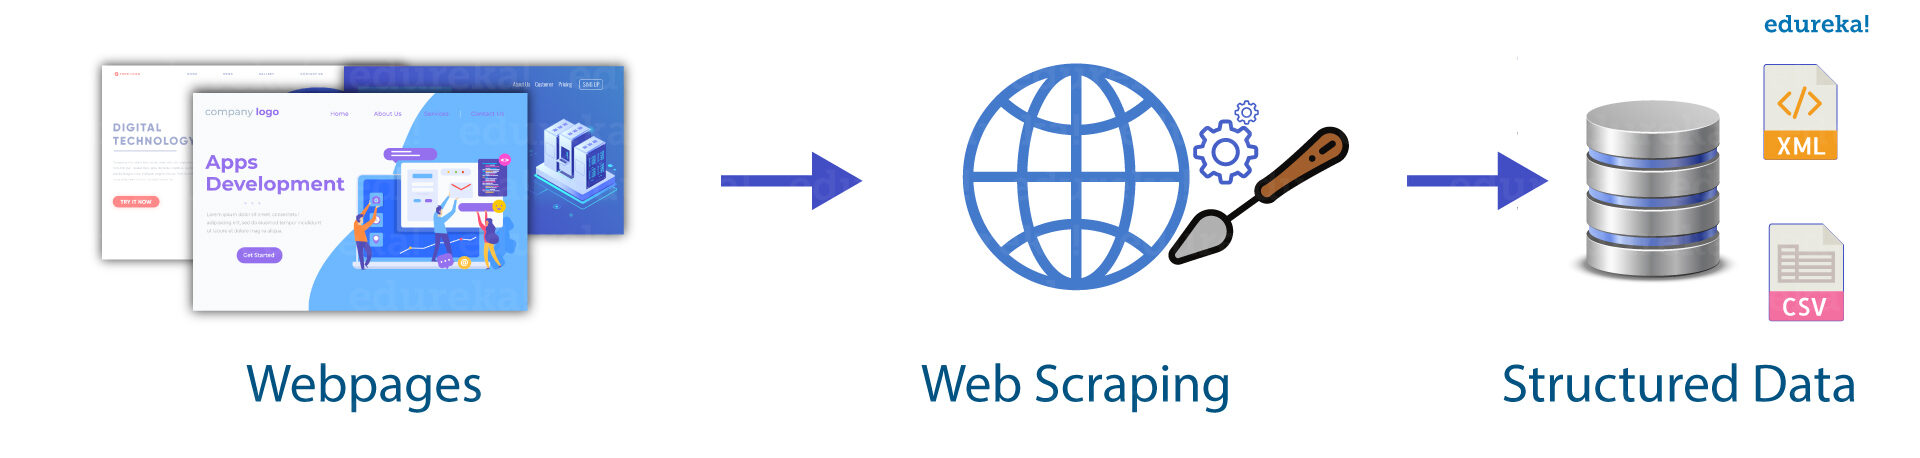
Vous savez que les nouvelles formes de web scraping consistent à observer le flux de données sur les serveurs web, par exemple, un archivo JSONJSON, o Notation d’objet JavaScript, Il s’agit d’un format d’échange de données léger, facile à lire et à écrire pour les humains, et facile à analyser et à générer pour les machines. Il est couramment utilisé dans les applications Web pour envoyer et recevoir des informations entre un serveur et un client. Sa structure est basée sur des paires clé-valeur, ce qui le rend polyvalent et largement adopté dans le développement de logiciels.. que se utiliza como transportador entre el cliente y el servidor web.
Il existe de nombreux grands sites Web qui Google, Facebook, Amazone, etc. fournir des API qui vous permettent d'accéder à vos données dans un format structuré ou étiqueté.
À présent, nous analysons brièvement la bibliothèque AutoScraper:
Qu'est-ce qu'AutoScraper?
Quand on parle de grattage, il y a beaucoup de choses sur le site Web que nous voulons supprimer, mais les scripts inscriptibles mettent beaucoup de temps à supprimer les données et c'est un processus très long, pour surmonter ce problème, un groupe de développeurs Python développe une bibliothèque. qui extraira toutes les données d'un site Web de manière simple. Ensuite Grattoir automatique La bibliothèque python de grattage Web est-elle utilisée pour extraire les données d'un site Web de manière simple, facile et rapide. Il dispose d'un environnement convivial grâce à ce grattoir, vous pouvez facilement interagir avec cette bibliothèque.
Utilise les URL de sites Web et le contenu HTML pour extraire des informations et des données fiables.
Point à considérer: apprendre les règles de grattage et retourner les articles similaires dans un bon format.
Il est facile de supprimer le contenu d'un site Web qui était facile à examiner en tant que titre, le prix, nom, notes, etc. Attendez une minute! Que ferons-nous des images? C'est une grande question qui se pose, on peut donner l'image lors de l'exécution du programme😅. Je trouve un moyen de supprimer les images des sites Web. Analysons ci-dessous:
Premier, c'est parti pour l'installation de cette librairie:
Installer AutoScraper
Il y a deux façons d'installer AutoScraper:
Utiliser pip: –
Entrez le code suivant à l'invite de commande,
pip installer le grattoir automatique
ou avec le dépôt git,
clone de git https://github.com/brandonrobertz/autoscrape-py
cd autoscrape-py /
pip installer.[tous]
Maintenant, nous importons des modules importants:
Importation de modules
# Importation d'AutoScraper
à partir de l'autoscraper importer AutoScraper
Ici, nous importons la classe AutoScraper de la bibliothèque.
Maintenant, nous transmettons l'URL à la fonction AutoScraper pour continuer à gratter:
URL: – https://www.bookswagon.com/
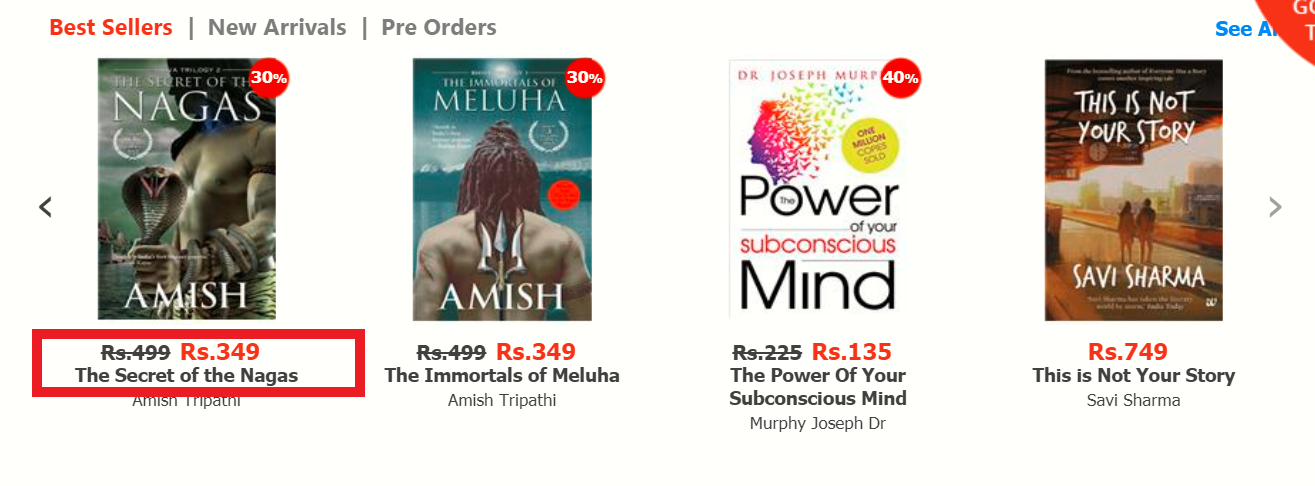
Ici, nous transmettons l'URL du site Web de commerce électronique à la classe AutoScraper pour extraire ou gratter les images du livre.
À présent, avant de continuer, nous voyons d'abord la démo en grattant les titres et les prix des livres pour avoir une meilleure compréhension de base du code de grattage:
Démo de grattage
À présent, nous allons alimenter la liste des articles à gratter, donc d'abord nous devons initialiser la classe AutoScraper avec son objet:
Liste des personnes recherchées:
créer une liste d'articles
# créer une liste d'éléments
articles = ['Rs.349' , 'The Secret of the Nagas']
Création d'objets:
# créer un objet
gratter = AutoScraper()
# alimentation pour le grattage
résultat_final = scrape.build(URL,éléments)
# afficher le résultat
imprimer(résultat final)
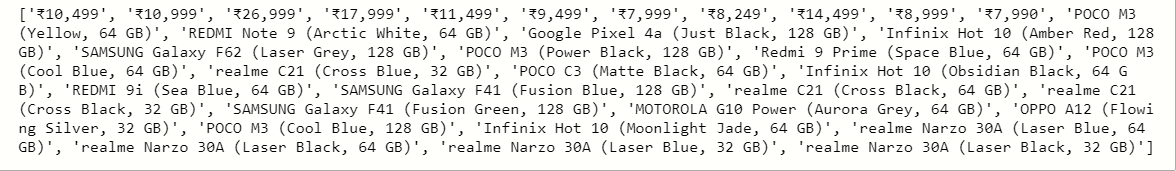
Il est temps de supprimer l'image
À présent, avoir une idée du code de grattage Web dont nous avons parlé plus tôt, nous utilisons donc cette même méthode pour gratter les images du site Web avec quelques modifications. Donc, nous discuterons de la méthode ou de la technique pour extraire les images des données. voyons la suite:
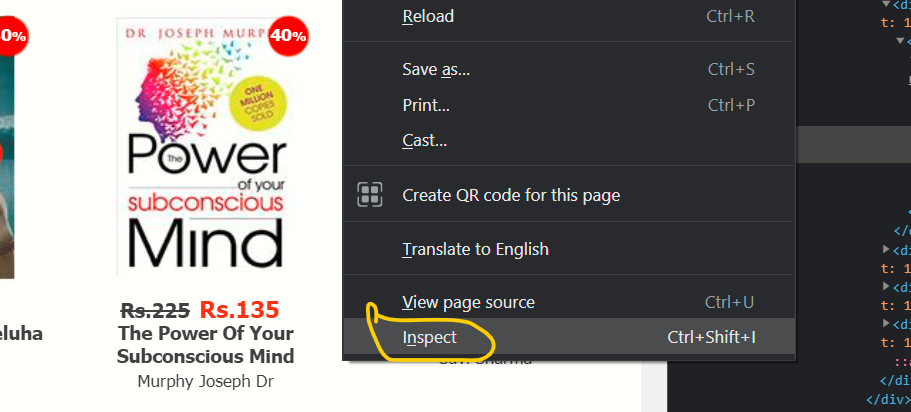
Paso 1:
Dans la première étape, nous devons cliquer avec le bouton droit de la souris, puis sélectionner l'option inspecter dans la liste du menu:
Paso 2:
Après avoir sélectionné l'option d'inspection, une page de contenu HTML s'ouvre à côté de l'écran, puis il survolera l'image du livre; à ce moment là, avis sur la page de contenu HTML que vous trouverez le URL de l'image.
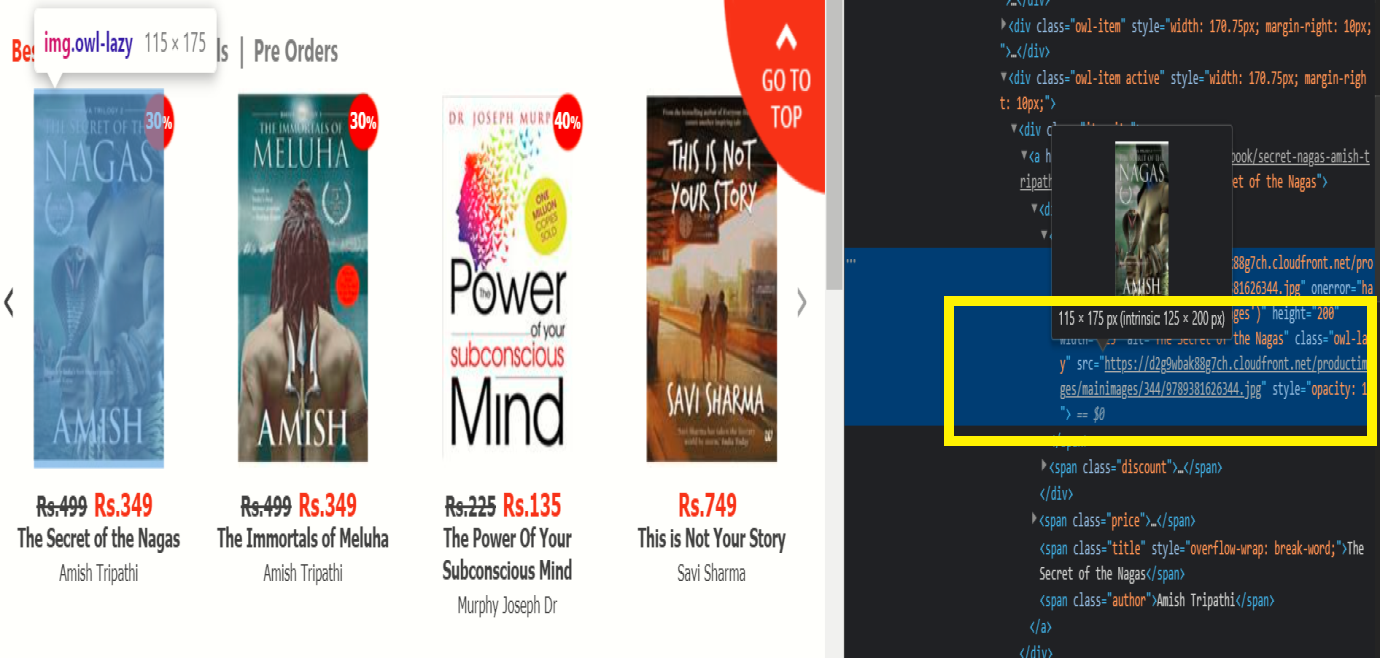
Lorsque vous trouvez l'URL de l'image particulière, copiez-le et nous l'utiliserons dans la liste de souhaits. C'est juste le changement qui est nécessaire pour gratter les images du site Web.
Paso 3:
À présent, nous allons configurer cette URL d'image avec les livres qui sont entrés dans notre liste de recherche,
article = ['https://d2g9wbak88g7ch.cloudfront.net/productimages/mainimages/344/9789381626344.jpg','This is Not Your Story']
Après avoir créé une liste, nous faisons le même processus que nous avons fait ci-dessus:
# création d'objet
gratter = AutoScraper()
# building result
final_result = scrap.build( URL, Objet )
# afficher le résultat
imprimer(résultat final)
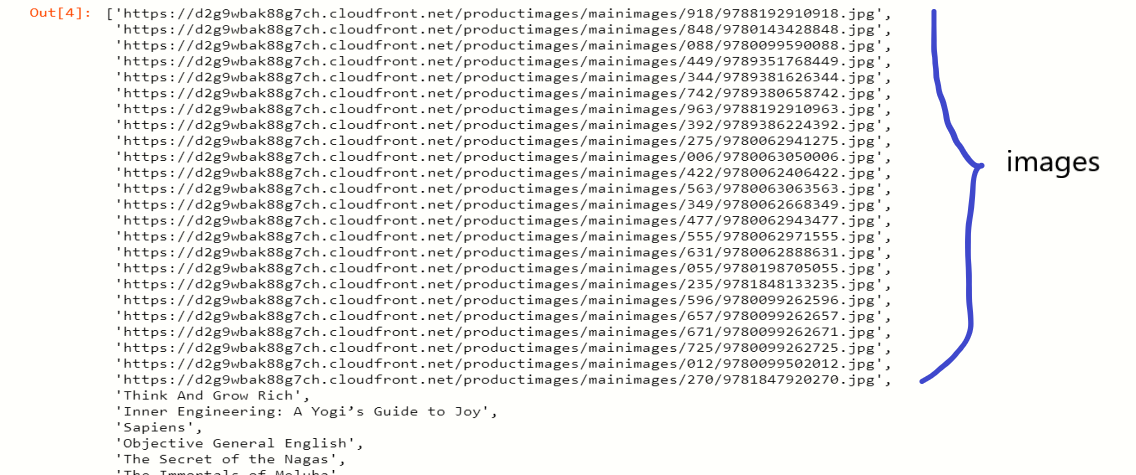
Noter: utiliser l'url des images pour extraire les images du site Web
Ensuite, c'est le processus pour gratter les images de n'importe quel site Web.
Note finale
Ensuite, ici, nous allons discuter du grattage d'image de site Web, si vous souhaitez supprimer des images du site Web, utiliser cette technique. Je suis très surpris d'utiliser cette bibliothèque AutoViz. J'espère que cet article vous a plu et merci d'avoir lu cet article.
Vous pouvez me joindre sur Linkedin: Profil URL
Lisez aussi mes autres articles: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Merci.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





