
Cet article a été publié dans le cadre de la Blogathon sur la science des données
Qu'est-ce que la correspondance de chaîne floue?
La correspondance floue des chaînes est la technique consistant à trouver des chaînes qui correspondent partiellement et pas exactement à une chaîne donnée. Lorsqu'un utilisateur a mal orthographié un mot ou saisit partiellement un mot, la correspondance floue des chaînes aide à trouver le mot correct, comme on le voit dans les moteurs de recherche.
L'algorithme derrière la correspondance floue des chaînes ne se limite pas à observer l'équivalence de deux chaînes, il quantifie plutôt à quel point deux chaînes sont proches l'une de l'autre. Esto de forma general se hace usando una métrica de distancia conocida como ‘distancia de edición’. Cela détermine la proximité de deux chaînes en identifiant les modifications minimales nécessaires pour convertir une chaîne en une autre.. Il existe différents types de distances d'édition qui peuvent être utilisées telles que la distance de Levenshtein, Distance de frappe, La distance de Jaro, etc.
Illustrons comment la distance de Levenshtein est calculée.
Exemple 1:
Chaîne 1 = ‘Poner’
Chaîne 2 = ‘Pat’
La distance de Levenshtein serait 1, puisque nous pouvons convertir la chaîne 1 Dans la chaîne 2 reemplazando ‘vous’ avec ‘une’.
Exemple 2:
Chaîne 1 = ‘Sol’
Chaîne 2 = ‘Saturno’
La distance de Levenshtein serait 3, puisque nous pouvons convertir la chaîne 1 Dans la chaîne 2 à travers de 3 inserts: ‘une’, ‘t’ Oui ‘r’.
Correspondance de chaîne floue en Python:
Comparer des chaînes en Python
Pour comparer deux chaînes en Python, nous pouvons exécuter le code suivant:
Str1 = "Arrière"
Str2 = "Livre"
Résultat = Str1 == Str2
imprimer(Résultat)
El código anterior dará un resultado como ‘Faux’ puisque les deux cordes ne sont pas les mêmes.
Distance de Levenshtein en Python
Distancia de Levenshtein en Python usando el paquete de Python ‘Levenshtein’.
importer Levenshtein en tant que lev
Str1 = "Arrière"
Str2 = "Livre"
lev.distance(Str1.inférieur(),Str2.inférieur())
Le code ci-dessus donnera une sortie de 2, nous pouvons convertir la chaîne 1 Dans la chaîne 2 pour 2 remplaçants.
FuzzyWuzzy et Python
FuzzyWuzzy est un package Python qui peut être utilisé pour la correspondance de chaînes. Nous pouvons exécuter la commande suivante pour installer le package:
pip installer fuzzywuzzy
Comme le package Levenshtein, FuzzyWuzzy a une fonction de liaison qui calcule la liaison de similarité de distance Levenshtein standard entre deux séquences.
de fuzzywuzzy importer du fuzz
Str1 = "Arrière"
Str2 = "Livre"
Ratio = fuzz.ratio(Str1.inférieur(),Str2.inférieur())
imprimer(Rapport)
La sortie du code suivant donne 50, puisque la liaison Levehshtein est calculée en divisant la distance de Levenshtein par le maximum de la longueur de la chaîne 1 et la chaîne 2.
Calculons le motif d'un autre ensemble de chaînes.
de fuzzywuzzy importer du fuzz
Str1 = "Mon nom est Ali"
Str2 = "Ali est mon nom"
Ratio = fuzz.ratio(Str1.inférieur(),Str2.inférieur())
imprimer(Rapport)
La sortie du code donne 50, ce qui indique que même si les mots sont les mêmes, l'ordre des mots est important pour le calcul de la proportion.
Liaison partielle avec FuzzyWuzzy
La liaison partielle nous aide à faire correspondre les sous-chaînes. Cela prend la chaîne la plus courte et la compare à toutes les sous-chaînes de même longueur.
Str1 = "Mon nom est Ali"
Str2 = "Je m'appelle Ali Abdaal"
imprimer(fuzz.partial_ratio(Str1.inférieur(),Str2.inférieur()))
La sortie du code donne 100 comme partial_ratio () il suffit de vérifier si l'une des chaînes est une sous-chaîne de l'autre.
Ce lien pourrait être très utile si, par exemple, nous essayons de faire correspondre le nom d'une personne entre deux ensembles de données. Dans le premier ensemble de données, la chaîne a le prénom et le nom de la personne, et dans le deuxième ensemble de données, la chaîne porte le nom, le deuxième prénom et le nom de la personne. La proportion serait 100 car la première chaîne est une sous-chaîne de la deuxième chaîne.
Ratio de classification des jetons à l'aide de FuzzyWuzzy
Dans le ratio de classement des jetons, les chaînes sont tokenisées et prétraitées en les convertissant en minuscules et en supprimant la ponctuation. Ensuite, les chaînes sont classées par ordre alphabétique et jointes. Publier ceci, le lien de similarité de distance de Levenshtein est calculé entre les cordes.
Str1 = "Mon nom est Ali"
Str2 = "Ali est mon nom"
imprimer(fuzz.token_sort_ratio(Str1,Str2))
La sortie du code donne 100, puisque le taux de tri des jetons est trouvé après avoir trié les chaînes par ordre alphabétique et, pour cela, l'ordre original des mots n'a pas d'importance.
Ratio de jeu de jetons à l'aide de FuzzyWuzzy
La proportion de pool de jetons effectue une opération de pool qui extrait les jetons communs au lieu de simplement tokeniser les chaînes, trier puis coller à nouveau les jetons. Les mêmes mots supplémentaires ou répétés n'ont pas d'importance.
Str1 = "Mon nom est Ali"
Str2 = "Ali est mon nom"
imprimer(fuzz.token_sort_ratio(Str1,Str2))
imprimer(fuzz.token_set_ratio(Str1,Str2))
La sortie de la liaison de classification de jeton devient 85, tandis que celle de la liaison de l'ensemble de jetons atteint 100, puisque la liaison d'ensemble de jetons ne prend pas en compte les mots répétés.
Illustrons un autre exemple de liaison d'ensemble de jetons pour une explication plus approfondie.
Str_A = 'Read the sentence - My name is Ali'
Str_B = 'My name is Ali'
ratio = fuzz.token_set_ratio(Str_A, Str_B)
imprimer(rapport)
La sortie du code ci-dessus nous donne 100. Ceci est dû au fait, sous le capot, la liaison d'ensemble de jetons a une approche plus flexible. Après avoir supprimé les chaînes communes (‘Mi nombre es Ali’), découvrir la liaison fuzz pour les paires suivantes puis retourner la valeur maximale parmi les trois:
- chaîne commune et chaîne commune avec le reste de la chaîne un
- chaîne commune et chaîne commune avec le reste de la chaîne deux
- chaîne commune avec reste de un et chaîne commune avec reste de deux
Module de procédure utilisant FuzzyWuzzy
Si nous avons une liste de chaînes et que nous voulons trouver la chaîne correspondante la plus proche de la liste avec une chaîne donnée, podemos aprovechar el módulo ‘traiter’.
from fuzzywuzzy import process
query = 'My name is Ali'
choices = ['My name Ali', 'My name is Ali', 'My Ali']
# Obtenez une liste des matchs classés par score, limite par défaut à 5
processus.extrait(mettre en doute, les choix)
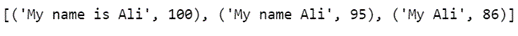
Si nous voulons extraire le meilleur match, nous pouvons exécuter le code suivant:
process.extractOne(mettre en doute, les choix)
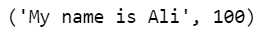
A propos de l'auteur
Nibedita a terminé sa maîtrise en génie chimique de l'IIT Kharagpur en 2014 et aujourd'hui, elle travaille comme consultante senior chez AbsolutData Analytics. Dans votre poste actuel, travaille à la création de solutions basées sur l'IA / ML pour des clients de divers secteurs.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





