
introduction
Au cours des dernières décennies, Le Deep Learning s'est avéré être un outil très puissant en raison de sa capacité à gérer de grandes quantités de données. L'intérêt d'utiliser des couches cachées a dépassé les techniques traditionnelles, surtout dans la reconnaissance de formes. L'un des réseaux de neurones profonds les plus populaires est les réseaux de neurones convolutifs.
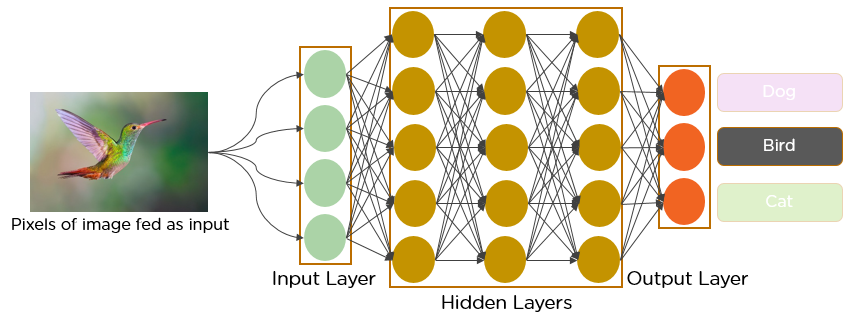
Depuis la décennie de 1950, les débuts de l'IA, les chercheurs ont eu du mal à créer un système capable de comprendre les données visuelles. Dans les années suivantes, ce domaine est devenu connu sous le nom de Computer Vision. Dans 2012, La vision par ordinateur a fait un bond en avant lorsqu’un groupe de chercheurs de l’Université de Toronto a mis au point un modèle d’intelligence artificielle qui surpassait les meilleurs algorithmes de reconnaissance d’images, et ce, de loin margeLa marge est un terme utilisé dans divers contextes, comme la comptabilité, Économie et imprimerie. En comptabilité, fait référence à la différence entre les revenus et les coûts, qui permet d’évaluer la rentabilité d’une entreprise. Dans le domaine de l’édition, La marge est l’espace blanc autour du texte d’une page, qui le rend facile à lire et offre une présentation esthétique. Sa bonne gestion est essentielle...
Le système d'intelligence artificielle, qui est devenu connu sous le nom d'AlexNet (du nom de son principal créateur, Alex Krijevsky), a remporté le concours de vision par ordinateur ImageNet de 2012 avec une précision étonnante de 85 pourcent. Le finaliste a obtenu une modeste 74 pour cent au test.
Au cœur d'AlexNet se trouvaient les réseaux de neurones convolutifs, un type particulier de neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. qui imite grossièrement la vision humaine. Au fil des ans, Les CNN sont devenus une partie très importante de nombreuses applications de vision par ordinateur et, donc, dans une partie de tout cours de vision par ordinateur en ligne. Voyons donc comment fonctionne CNN.
Contexte CNN
Les CNN ont été développés et utilisés pour la première fois vers la décennie de 1980. Tout ce qu'un CNN pouvait faire à l'époque était de reconnaître les chiffres manuscrits. Il était principalement utilisé dans les secteurs postaux pour lire les codes postaux, codes PIN, etc. La chose importante à retenir à propos de tout modèle de l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... c’est qu’il nécessite beaucoup de données pour s’entraîner et qu’il nécessite également beaucoup de ressources informatiques. C'était un inconvénient majeur pour CNN à cette époque et, donc, Les CNN étaient limités aux secteurs postaux et n'ont pas pu entrer dans le monde de l'apprentissage automatique.
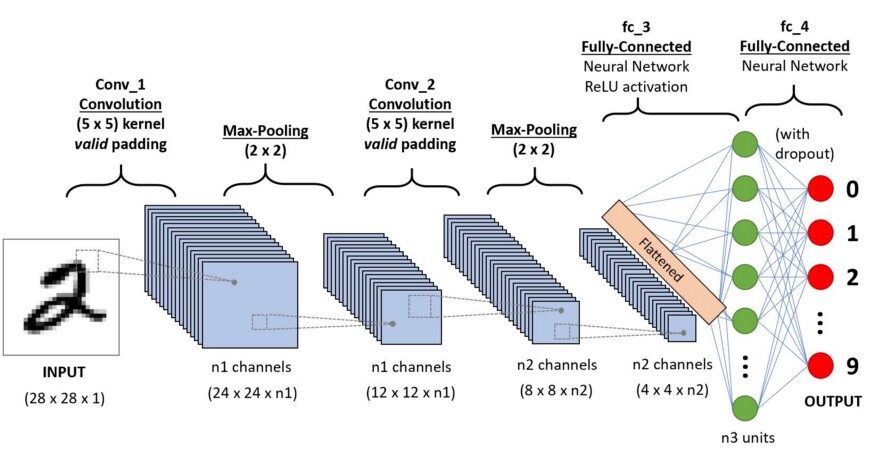
Dans 2012, Alex Krizhevsky s'est rendu compte que le moment était venu de reprendre la branche du deep learning qui utilise les réseaux de neurones multicouches. La disponibilité de grands ensembles de données, pour être plus spécifiques des ensembles de données ImageNet avec des millions d'images étiquetées et une abondance de ressources informatiques, a permis aux chercheurs de relancer CNN.
Qu'est-ce qu'un CNN exactement?
Dans l'apprentissage en profondeur, une convolucional neuronal rougeRéseaux de neurones convolutifs (CNN) sont un type d’architecture de réseau neuronal conçu spécialement pour le traitement de données avec une structure en grille, comme images. Ils utilisent des couches de convolution pour extraire des caractéristiques hiérarchiques, Ce qui les rend particulièrement efficaces dans les tâches de reconnaissance et de classification des formes. Grâce à sa capacité à apprendre à partir de grands volumes de données, Les CNN ont révolutionné des domaines tels que la vision par ordinateur.. (CNN / ConvNet) c'est une sorte de réseaux de neurones profonds, le plus couramment appliqué pour analyser des images visuelles. À présent, quand on pense à un réseau de neurones, on pense aux multiplications matricielles, mais ce n'est pas le cas avec ConvNet. Utilise une technique spéciale appelée convolution. Maintenant en maths convolution est une opération mathématique sur deux fonctions qui produit une troisième fonction qui exprime comment la forme de l'une est modifiée par l'autre.
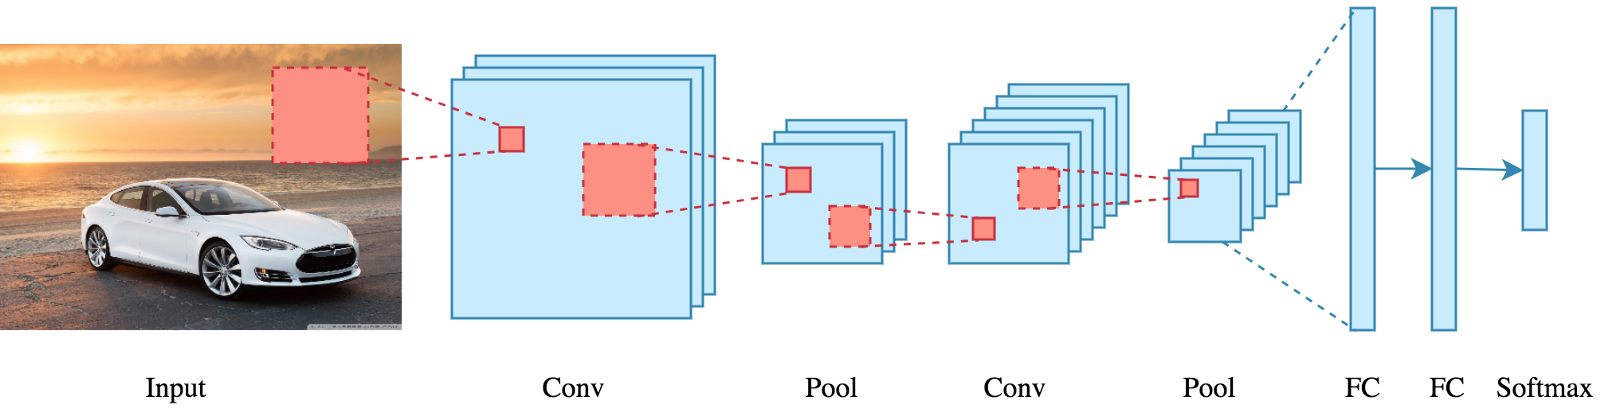
Mais nous n'avons pas vraiment besoin d'aller au-delà de la partie mathématique pour comprendre ce qu'est un CNN ou comment il fonctionne..
L'essentiel est que le rôle de ConvNet est réduire les images à une forme plus facile à traiter, sans perdre les caractéristiques essentielles pour obtenir une bonne prédiction.
Comment ça marche?
Avant de passer à l'exploitation de CNN, couvrons les bases, comme ce qu'est une image et comment est-elle représentée. Une image RVB n'est rien de plus qu'un tableau de valeurs de pixels qui a trois plans, alors qu'une image en niveaux de gris est la même mais n'a qu'un seul plan. Regardez cette image pour mieux comprendre.
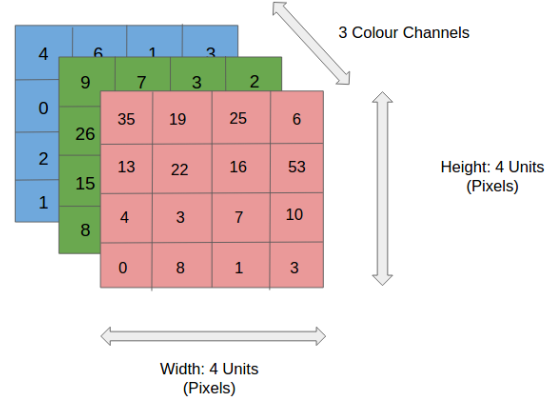
Pour simplifier, passons aux images en niveaux de gris alors que nous essayons de comprendre comment fonctionne CNN.
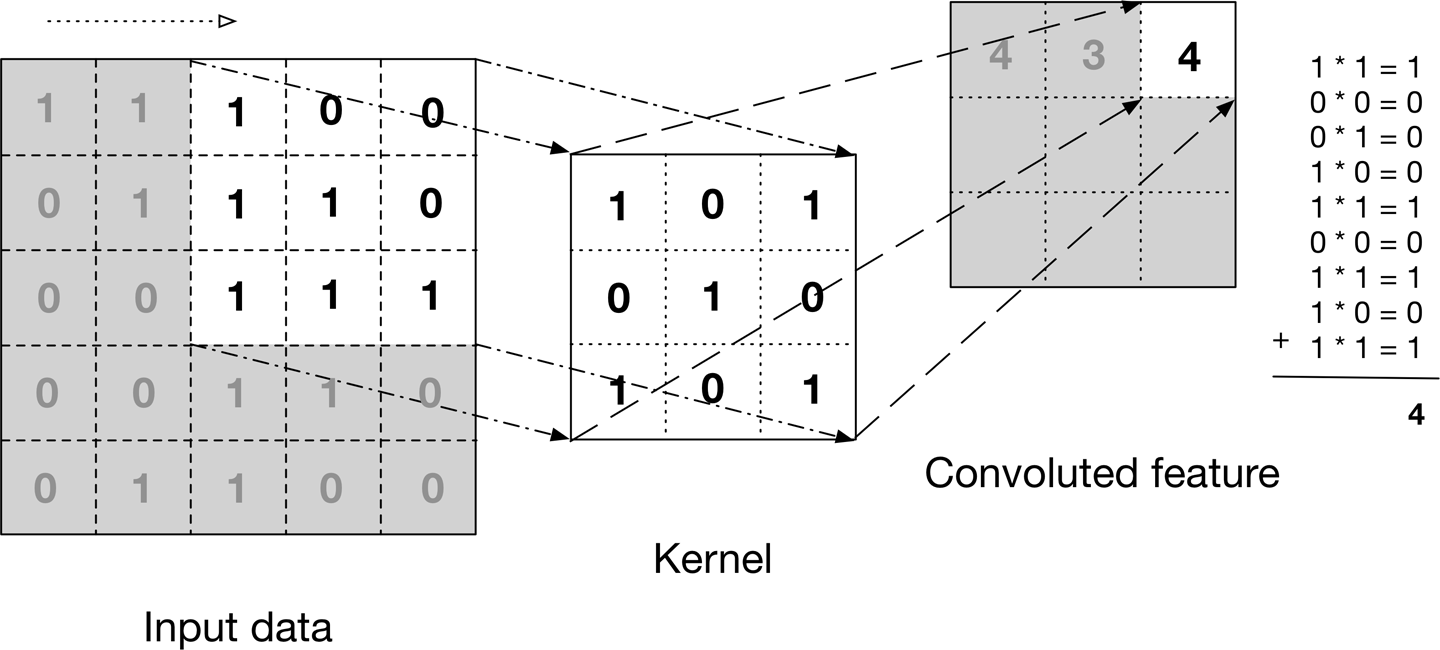
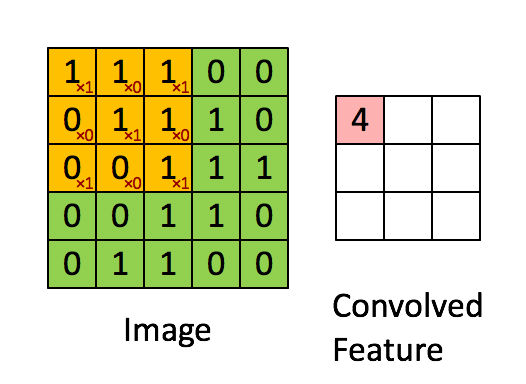
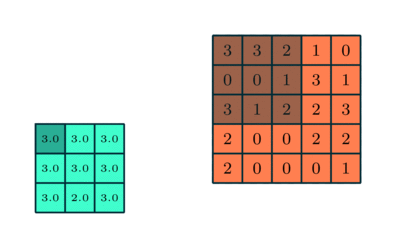
L'image ci-dessus montre ce qu'est une convolution. On prend un filtre / coeur (matrice de 3 × 3) et nous l'appliquons à l'image d'entrée pour obtenir la fonction convoluée. Cette caractéristique convoluée est transmise à la couche suivante.
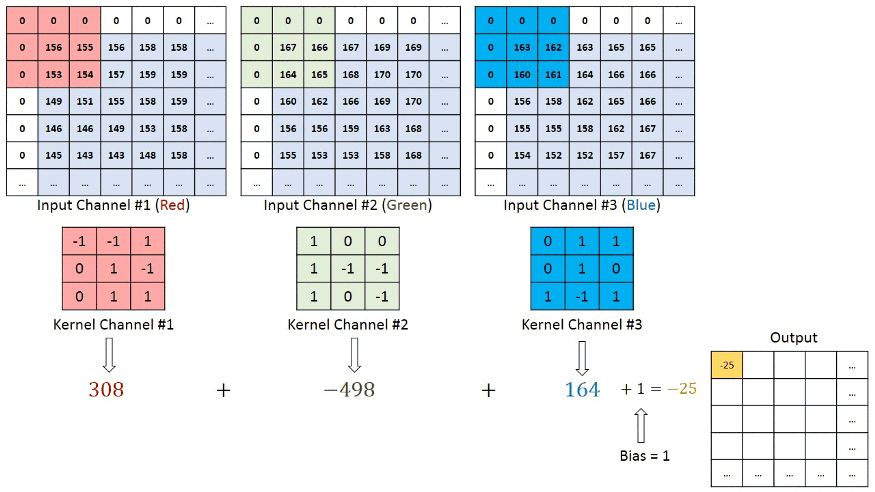
Dans le cas de la couleur RVB, la chaîne regarde cette animation pour comprendre son fonctionnement.
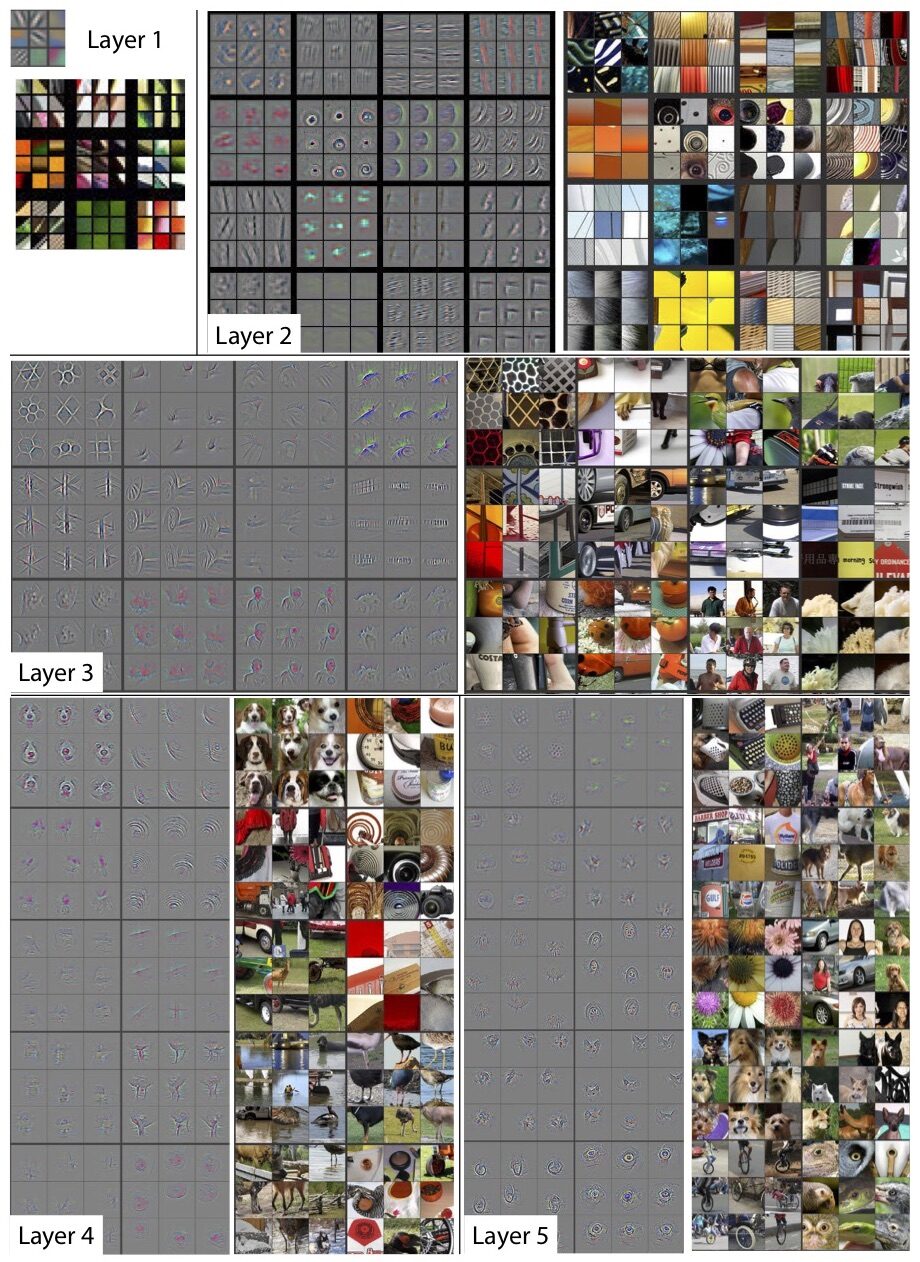
Les réseaux de neurones convolutifs sont composés de plusieurs couches de neurones artificiels. Neurones artificiels, une imitation grossière de leurs homologues biologiques, sont des fonctions mathématiques qui calculent la somme pondérée de plusieurs entrées et sorties d'une valeur de déclenchement. Lorsque vous entrez une image dans un ConvNet, chaque couche génère plusieurs fonctions d'activation qui sont transmises à la couche suivante.
La première couche extrait généralement les caractéristiques de base comme les bords horizontaux ou diagonaux. Cette sortie est transmise à la couche suivante, qui détecte des fonctionnalités plus complexes, comme coins ou bords combinés. Alors que nous entrons sur le Web, nous pouvons identifier des caractéristiques encore plus complexes, comme objets, visages, etc.
D'après la carte d'activation de la couche de convolution finale, la couche de classification génère un ensemble de scores de confiance (valeurs entre 0 Oui 1) qui spécifient la probabilité que l'image appartienne à un « classe ». Par exemple, si vous avez un ConvNet qui détecte les chats, chiens et chevaux, la sortie de la couche finale est la possibilité que l'image d'entrée contienne un de ces animaux.
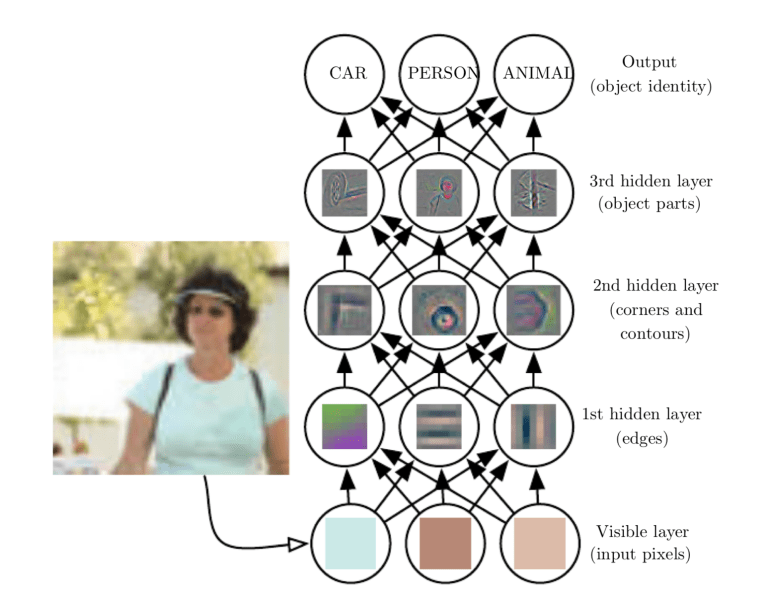
Qu'est-ce qu'une couche de regroupement?
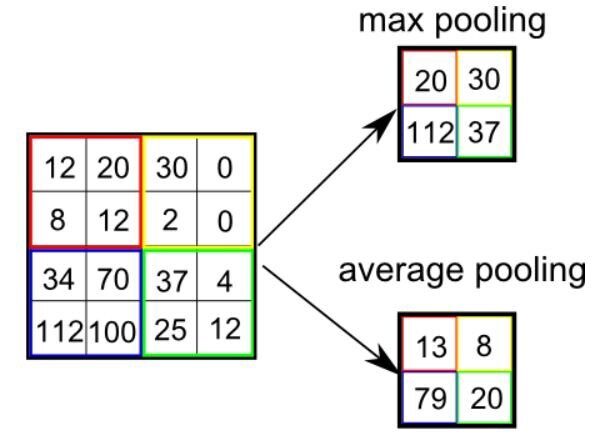
Semblable à la couverture convolutiveLa couche convolutive, Fondamental dans les réseaux de neurones convolutifs (CNN), Il est principalement utilisé pour le traitement de données avec des structures de type grille, comme images. Cette couche applique des filtres qui extraient les caractéristiques pertinentes, tels que les bords et les textures, permettant au modèle de reconnaître des motifs complexes. Sa capacité à réduire la dimensionnalité des données et à maintenir les informations essentielles en fait un outil clé dans les tâches de vision par ordinateur.., la couche de regroupement est responsable de la réduction de la taille spatiale de l'entité convoluée. C'est pour Diminuer la puissance de calcul requise pour traiter les données. réduire les dimensions. Il existe deux types de regroupement, le regroupement moyen et le regroupement maximum. Je n'ai eu jusqu'à présent qu'une expérience avec Max Pooling et je n'ai rencontré aucune difficulté.
Ensuite, ce que nous faisons dans Max Pooling est de trouver la valeur maximale d'un pixel d'une partie de l'image couverte par le noyau. Max Pooling fonctionne également comme Suppresseur de bruit. Il exclut complètement les déclencheurs bruyants et effectue également un débruitage ainsi qu'une réduction de la dimensionnalité.
D'autre part, Regroupement moyen retourner le moyenne de toutes les valeurs de la partie de l'image couverte par le noyau. Le regroupement moyen effectue simplement une réduction de la dimensionnalité en tant que mécanisme de suppression du bruit. Pourtant, on peut dire ça La piscine maximale fonctionne bien mieux que la piscine moyenne.
Limites
Malgré la puissance et la complexité des ressources de CNN, fournir des résultats détaillés. A la racine de tout, il s'agit simplement de reconnaître des motifs et des détails si minuscules et discrets qu'ils passent inaperçus à l'œil humain. Mais quand il s'agit de entente le contenu de l'image échoue.
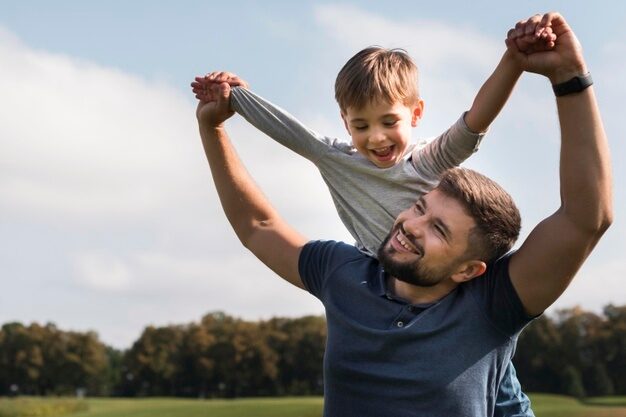
Regardons cet exemple. Quand on passe l'image ci-dessous à un CNN, détecte une personne autour 30 ans et un enfant probablement autour 10 ans. Mais quand on regarde la même image, nous avons commencé à penser à plusieurs scénarios différents. C'est peut-être la fête des pères et des fils, un pique-nique ou peut-être qu'ils campent. C'est peut-être une cour d'école et le garçon a marqué un but et son père est heureux alors il le ramasse.
Ces limitations sont plus qu'évidentes lorsqu'il s'agit d'applications pratiques. Par exemple, Les CNN ont été largement utilisés pour modérer le contenu sur les réseaux sociaux. Mais malgré les vastes ressources d'images et de vidéos sur lesquelles ils ont été formés, vous ne pouvez toujours pas bloquer et supprimer complètement le contenu inapproprié. Il s'avère que vous avez marqué une statue de 30.000 années avec nudité sur Facebook.
Plusieurs études ont montré que les CNN formés par ImageNet et d'autres ensembles de données populaires ne détectent pas les objets lorsqu'ils sont visualisés dans différentes conditions d'éclairage et sous de nouveaux angles..
Cela signifie-t-il que CNN est inutile? Cependant, malgré les limites des réseaux de neurones convolutifs, on ne peut nier qu'ils ont provoqué une révolution dans l'intelligence artificielle. Aujourd'hui, Les CNN sont utilisés dans de nombreux applications de vision industrielle comme reconnaissance faciale, rechercher et modifier des images, réalité augmentée et plus. Comme le montrent les progrès des réseaux de neurones convolutifs, nos réalisations sont remarquables et utiles, mais on est encore loin reproduire les composants clés de l'intelligence humaine.
Merci pour la lecture! Si vous avez aimé lire cet article, S'il vous plait partager pour aider les autres à le trouver! N'hésitez pas à laisser un commentaire ci-dessous. Vous pouvez me joindre à GitHub, LinkedIn
Avez-vous des commentaires? Soyons amis dans Twitter.
Tout le meilleur et bon codage! ??
Les supports présentés dans cet article ne sont pas la propriété d'Analytics Vidhya et sont utilisés à la discrétion de l'auteur..





