
Cet article a été publié dans le cadre du Blogathon sur la science des données
Cet article a pour but d’expliquer le convolucional neuronal rougeRéseaux de neurones convolutifs (CNN) sont un type d’architecture de réseau neuronal conçu spécialement pour le traitement de données avec une structure en grille, comme images. Ils utilisent des couches de convolution pour extraire des caractéristiques hiérarchiques, Ce qui les rend particulièrement efficaces dans les tâches de reconnaissance et de classification des formes. Grâce à sa capacité à apprendre à partir de grands volumes de données, Les CNN ont révolutionné des domaines tels que la vision par ordinateur.. et comment compiler CNN avec la bibliothèque TensorFlow Keras. Cet article traitera des sujets suivants.
Analysons d’abord le neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. convolutif.
Convolucional neuronal rouge (CNN)
Le l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... Il s’agit d’un sous-ensemble très important de l’apprentissage automatique en raison de ses hautes performances dans plusieurs domaines. La convolucional neuronal rouge (CNN) est un type puissant d'apprentissage en profondeur de traitement d'images qui est souvent utilisé dans la vision par ordinateur et comprend la reconnaissance d'images et de vidéos ainsi qu'un système de recommandation et un traitement du langage naturel (PNL).
CNN utilise un système multicouche composé de la couche d'entréeLa "couche d'entrée" fait référence au niveau initial d’un processus d’analyse de données ou d’architectures de réseaux de neurones. Sa fonction principale est de recevoir et de traiter l’information brute avant qu’elle ne soit transformée par les couches suivantes. Dans le contexte de l’apprentissage automatique, Une bonne configuration de la couche d’entrée est cruciale pour garantir l’efficacité du modèle et optimiser ses performances dans des tâches spécifiques...., la Couche de sortieLa "Couche de sortie" est un concept utilisé dans le domaine des technologies de l’information et de la conception de systèmes. Il s’agit de la dernière couche d’un modèle logiciel ou d’une architecture qui est chargée de présenter les résultats à l’utilisateur final. Cette couche est cruciale pour l’expérience utilisateur, puisqu’il permet une interaction directe avec le système et la visualisation des données traitées.... et une couche cachée comprenant plusieurs couches convolutives, calques groupés, couches entièrement connectées. Nous discuterons de toutes les couches dans la section suivante de l'article pendant que nous expliquons la construction de CNN..
Discutons de la construction de CNN à l'aide de la bibliothèque Keras avec une explication du fonctionnement de CNN.
Immeuble CNN
Nous utiliserons le Ensemble de données d'imagerie cellulaire du paludisme. Cet ensemble de données se compose de 27,558 images d'échantillons de sang microscopiques. L'ensemble de données se compose de 2 Dossiers: Dossiers: parasité et non infecté. Exemples d'images
une) échantillon de sang parasité
b) Échantillon de sang non infecté
Nous discuterons de la construction de CNN avec CNN en travaillant sur les points suivants 6 Pas:
Paso 1: importer les bibliothèques requises
Paso 2: initialiser CNN et ajouter un couverture convolutiveLa couche convolutive, Fondamental dans les réseaux de neurones convolutifs (CNN), Il est principalement utilisé pour le traitement de données avec des structures de type grille, comme images. Cette couche applique des filtres qui extraient les caractéristiques pertinentes, tels que les bords et les textures, permettant au modèle de reconnaître des motifs complexes. Sa capacité à réduire la dimensionnalité des données et à maintenir les informations essentielles en fait un outil clé dans les tâches de vision par ordinateur..
Paso 3: opération de regroupement
Paso 4: ajouter deux couches convolutives
Paso 5 – Opération d'aplatissement
Paso 6: couche et couche de sortie entièrement connectées
Ces 6 étapes expliqueront comment CNN fonctionne, montré dans l'image suivante:
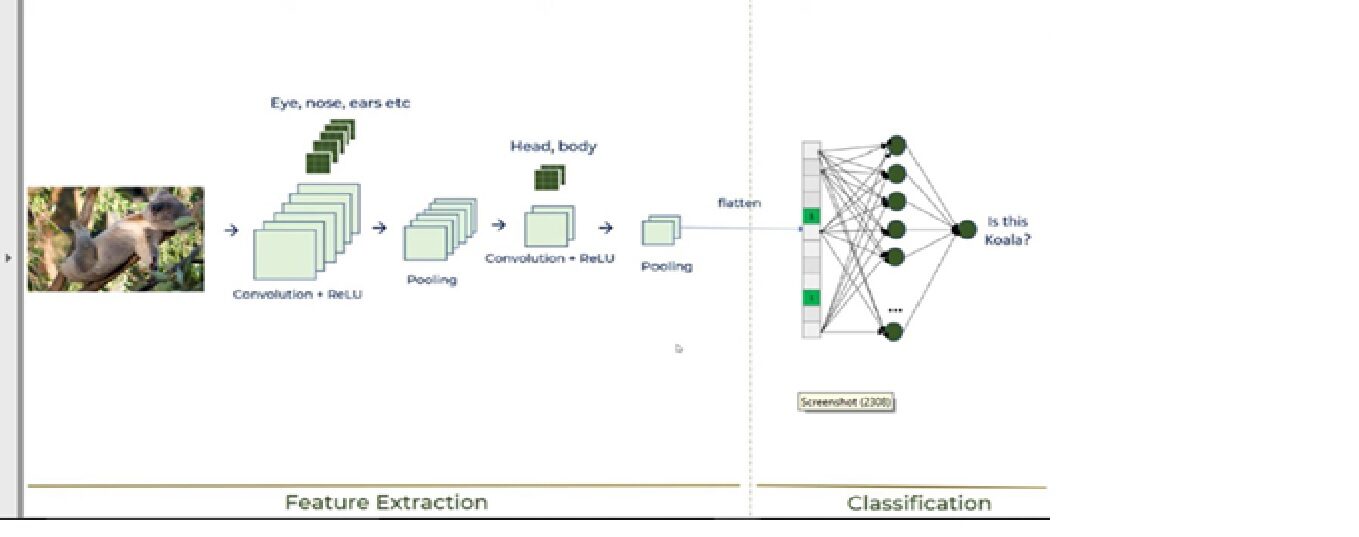
À présent, analysons chaque étape:
1. Importer les bibliothèques requises
S'il vous plait, voir le lien ci-dessous pour des explications détaillées sur les modules Keras.
https://keras.io/getting_started/
Code Python:
From tensorflow.keras.layers import Entrée, Lambda, Dense, Aplatir,Conv2D
depuis tensorflow.keras.models importer le modèle
de tensorflow.keras.applications.vgg19 importer VGG19
depuis tensorflow.keras.applications.resnet50 importer preprocess_input
à partir de l'image d'importation tensorflow.keras.preprocessing
de tensorflow.keras.preprocessing.image importer ImageDataGenerator,load_img
de tensorflow.keras.models import séquentiel
importer numpy en tant que np
de glob importer glob
importer matplotlib.pyplot en tant que plt
de tensorflow.keras.layers importer MaxPooling2D
2. Initialiser CNN et ajouter une couche convolutive
Code Python:
modèle=Séquentiel()

model.ajouter(Conv2D(filtres=16,kernel_size=2,padding="même",activation="reprendre",input_shape=(224,224,3)))
Nous devons d'abord démarrer la classe séquentielle car il y a plusieurs couches pour construire CNN et toutes doivent être en séquence. Ensuite, nous ajoutons la première couche convolutive où nous devons spécifier 5 arguments. Ensuite, Analysons chaque argument et son objectif.
· Filtres
Le but principal de la convolution est de trouver des caractéristiques dans l'image à l'aide d'un détecteur de caractéristiques. Alors, placez-les sur une carte des caractéristiques, qui préserve les caractéristiques distinctives des images.
Le détecteur de caractéristiques, qui est connu comme un filtre, également initialisé de manière aléatoire, puis, après plusieurs itérations, le paramètre de matrice de filtre qui sera le mieux pour séparer les images est sélectionné. Par exemple, l'oeil, le nez, etc. des animaux sera considérée comme une caractéristique utilisée pour classer les images à l'aide de filtres ou de détecteurs de caractéristiques. Ici, nous utilisons 16 les fonctions.
· Kernel_size
Kernel_size fait référence à la taille du tableau de filtres. Ici, nous utilisons une taille de filtre de 2 * 2.
· Remplissage
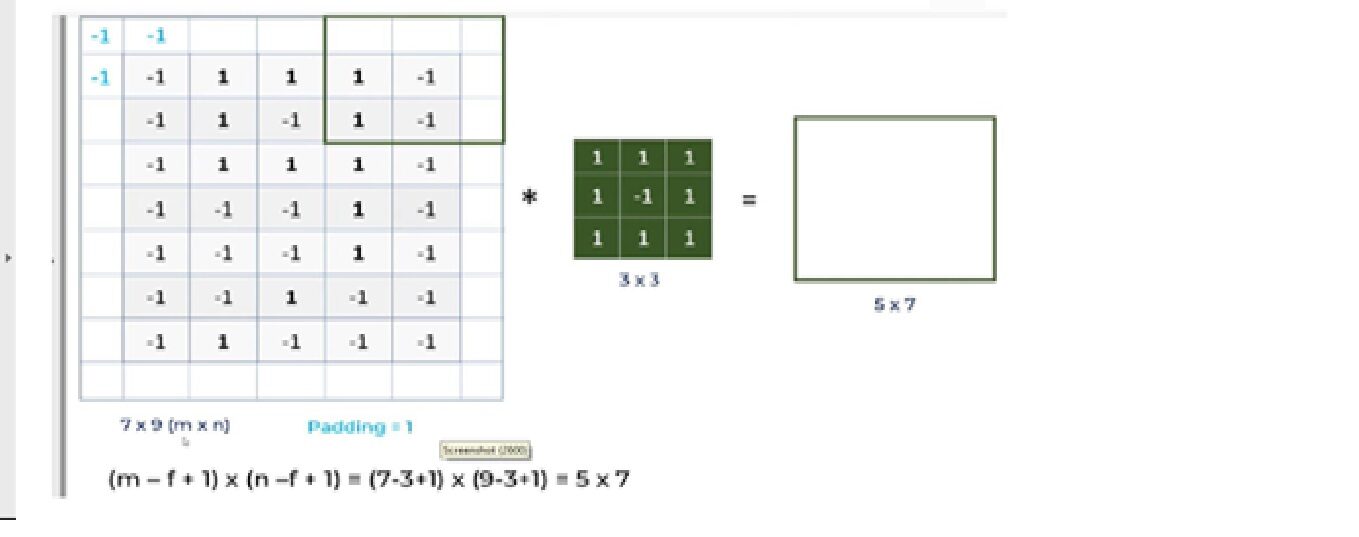
Discutons du problème avec CNN et de la façon dont l'opération de remplissage résoudra le problème.
ongle. Pour une image en niveaux de gris (nxn) et un filtre / coeur (fxf), les dimensions de l'image résultant d'une opération de convolution sont (m – F + 1) X (m – F + 1).
Ensuite, par exemple, une photo de 5 * 7 et une taille de noyau de filtre de 3 * 3, le résultat de sortie après l'opération de convolution serait une taille de 3 * 5. Donc, l'image rétrécit à chaque fois que l'opération convolutive est effectuée.
B. Pixels, situé dans les coins, ont une très faible contribution par rapport aux pixels du milieu.
Ensuite, pour atténuer ces problèmes, l'opération de remplissage est effectuée. Le remplissage est un processus simple d'ajout de couches avec 0 O -1 aux images d'entrée pour éviter les problèmes mentionnés ci-dessus.
Ici, nous utilisons Padding = Mêmes arguments, qui décrit que les images de sortie ont les mêmes dimensions que les images d'entrée.
· Fonction de déclenchementLa fonction d’activation est un composant clé des réseaux de neurones, puisqu’il détermine la sortie d’un neurone en fonction de son entrée. Son objectif principal est d’introduire des non-linéarités dans le modèle, vous permettant d’apprendre des modèles complexes dans les données. Il existe différentes fonctions d’activation, comme le sigmoïde, ReLU et tanh, chacun avec des caractéristiques particulières qui affectent les performances du modèle dans différentes applications.... – reprendreLa fonction d’activation ReLU (Unité linéaire rectifiée) Il est largement utilisé dans les réseaux neuronaux en raison de sa simplicité et de son efficacité. Défini comme suit : ( F(X) = max(0, X) ), ReLU permet aux neurones de se déclencher uniquement lorsque l’entrée est positive, ce qui permet d’atténuer le problème de l’évanouissement en pente. Il a été démontré que son utilisation améliore les performances dans diverses tâches d’apprentissage profond, faire de ReLU une option..
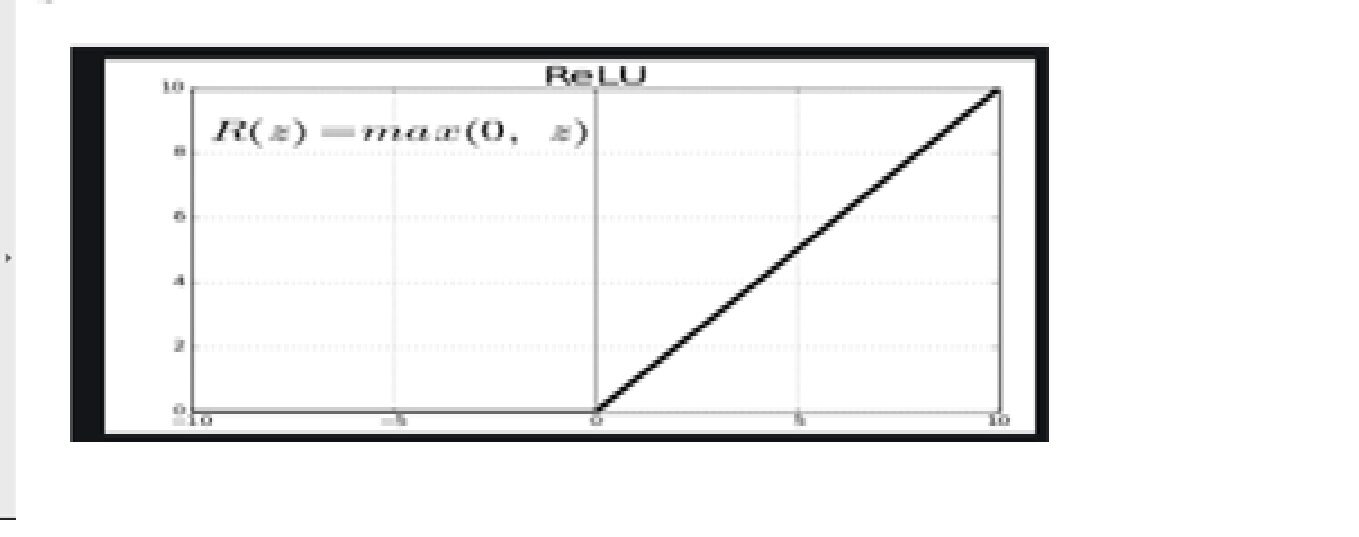
Puisque les images ne sont pas linéaires, fournir la non-linéarité, la Fonction d’activation ReluLa fonction d’activation ReLU (Unité linéaire rectifiée) Il est largement utilisé dans les réseaux neuronaux en raison de sa simplicité et de son efficacité. est défini comme ( F(X) = max(0, X) ), ce qui signifie qu’il produit une sortie de zéro pour les valeurs négatives et un incrément linéaire pour les valeurs positives. Sa capacité à atténuer le problème de l’évanouissement en pente en fait un choix privilégié dans les architectures profondes.... appliqué après un fonctionnement convolutif.
Relu signifie fonction d'activation linéaire rectifiée. La fonction Relu va générer l'entrée directement si elle est positive; au contraire, générera zéro.
· Formulaire de saisie
Cet argument montre la taille de l'image: 224 * 224 * 3. Puisque les images au format RVB sont comme ceci, le troisième dimension"Dimension" C’est un terme qui est utilisé dans diverses disciplines, comme la physique, Mathématiques et philosophie. Il s’agit de la mesure dans laquelle un objet ou un phénomène peut être analysé ou décrit. En physique, par exemple, On parle de dimensions spatiales et temporelles, alors qu’en mathématiques, il peut faire référence au nombre de coordonnées nécessaires pour représenter un espace. Sa compréhension est fondamentale pour l’étude et... de l’image est 3.
3. Fonctionnement de la piscine
Code Python:
model.ajouter(MaxPooling2D(pool_size=2))
Nous devons appliquer l'opération de regroupement après avoir initialisé CNN. Le clustering est une opération de sous-échantillonnage de l'image. La couche de regroupement est utilisée pour réduire les dimensions des cartes de caractéristiques. Donc, la couche Pooling réduit la quantité de paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... pour apprendre et réduire le calcul dans le réseau de neurones.
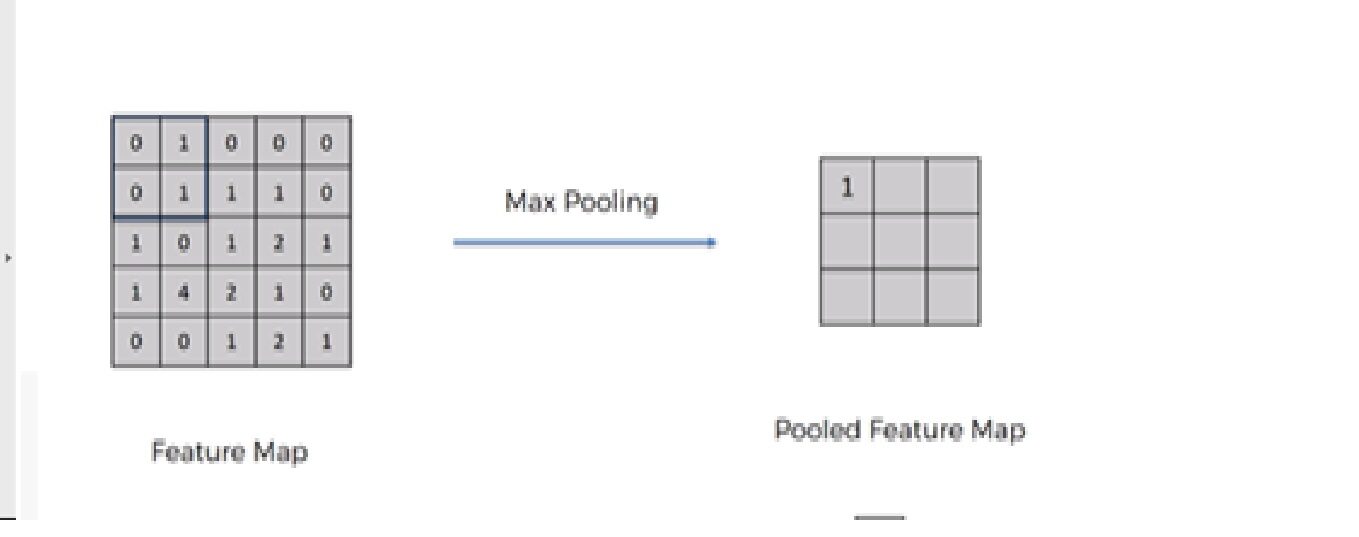
Les opérations futures sont effectuées sur les entités récapitulatives créées par la couche de regroupement. au lieu d'entités localisées avec précision générées par la couche de convolution. Cela conduit au modèle plus robuste aux variations de l'orientation de la caractéristique dans l'image..
Il y a principalement 3 types de regroupement: –
1. Regroupement maximal
2. Regroupement moyen
3. Regroupement global
4. Ajouter deux couches convolutives
Pour ajouter deux autres couches convolutives, nous devons répéter les étapes 2 Oui 3 avec une légère modification du nombre de filtres.
Code Python:
model.ajouter(Conv2D(filtres=32,kernel_size=2,padding="même",activation ="reprendre"))
model.ajouter(MaxPooling2D(pool_size=2))
model.ajouter(Conv2D(filtres=64,kernel_size=2,padding="même",activation="reprendre"))
model.ajouter(MaxPooling2D(pool_size=2))
Nous modifions le 2Dakota du nord Oui 3rd couches convolutives avec numéro de filtre 32 Oui 64 respectivement.
5. Opération d'aplatissement
Code Python:
model.ajouter(Aplatir())
L'opération d'aplatissement consiste à convertir l'ensemble de données en une matrice 1D pour entrer dans la couche suivante, qui est la couche entièrement connectée.
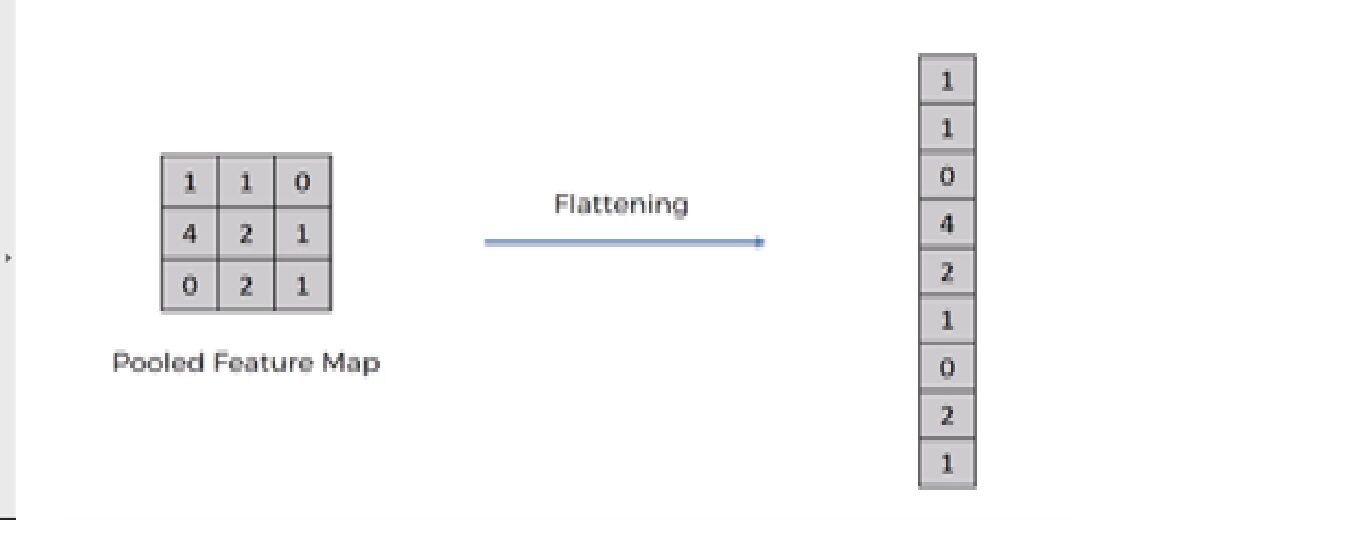
Après avoir terminé le 3 Pas, maintenant nous avons regroupé la carte des caractéristiques. Maintenant, nous aplatissons notre sortie après deux pas dans une colonne. Parce que nous devons insérer ces données 1D dans une couche de réseau de neurones artificiels.
6. Couche et couche de sortie entièrement connectées
La sortie de l'opération d'aplatissement fonctionne comme entrée du réseau neuronal. L'objectif du réseau de neurones artificiels rend le réseau de neurones convolutif plus avancé et suffisamment capable pour classer les images.
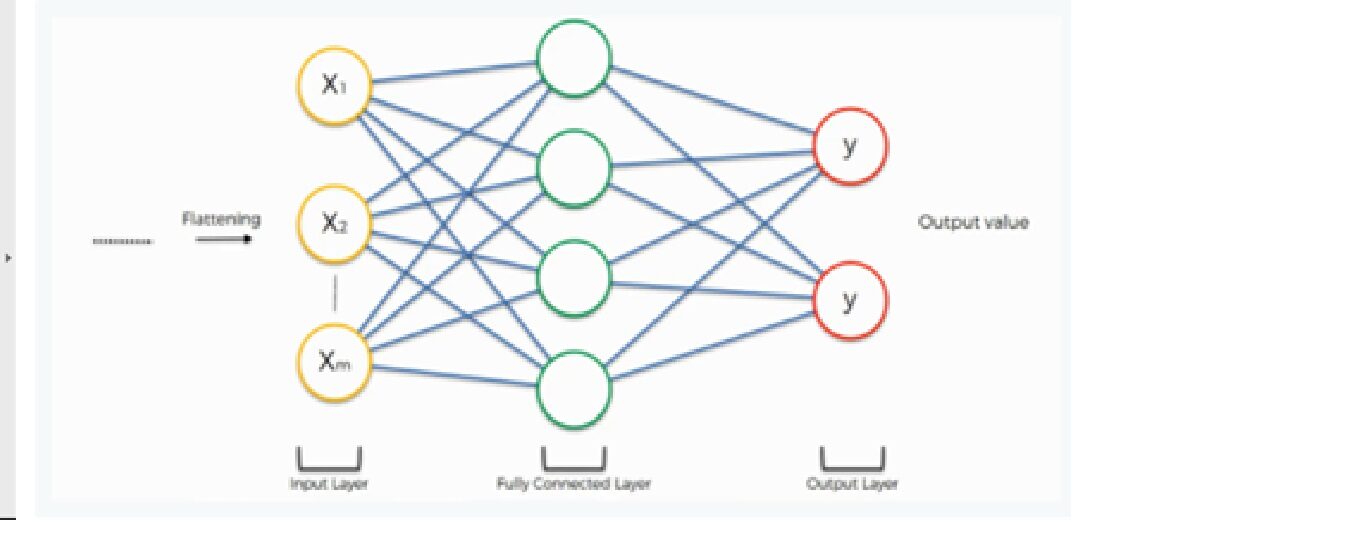
Ici, nous utilisons une classe dense de la bibliothèque Keras pour créer une couche entièrement connectée et une couche de sortie.
Code Python:
model.ajouter(Dense(500,activation="reprendre"))

model.ajouter(Dense(2,activation="softmax"))
La fonction softMax enable est utilisée pour construire la couche de sortie. Analysons la fonction d'activation de softmax.
Fonction d'activation Softmax
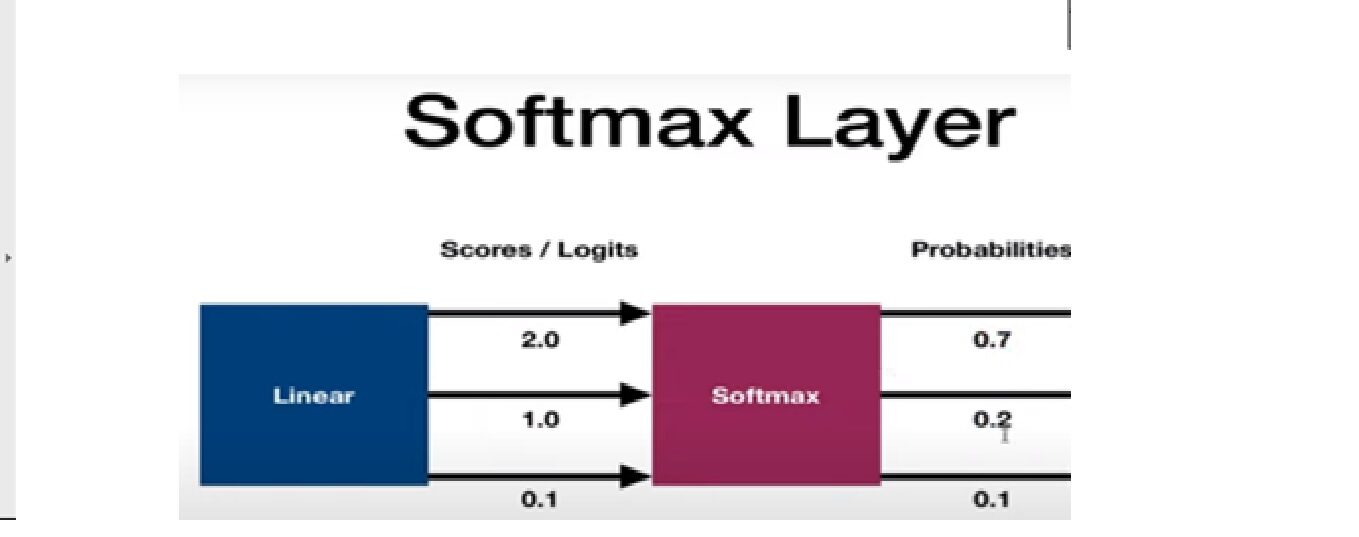
Il est utilisé comme dernière fonction d'activation d'un réseau de neurones pour amener la sortie du réseau de neurones à une distribution de probabilité sur les classes de prédiction. La sortie de Softmax est en probabilités de chaque résultat possible pour prédire la classe. La somme des probabilités doit être une pour toutes les classes de prédiction possibles.
À présent, Analysons le entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... et l’évaluation du réseau de neurones convolutif. Nous discuterons de cette section dans 3 Pas; –
Paso 1: compiler le modèle CNN
Paso 2: adapter le modèle à l'ensemble d'entraînement
Paso 3: évaluer le résultat
Paso 1: compiler le modèle CNN
Ligne de code
modèle.compile (loss = ‘catégorique_crossentropie’, optimizer = ‘Adam’, métriques =['précision'])
Ici, nous utilisons 3 arguments: –
· Fonction de perteLa fonction de perte est un outil fondamental de l’apprentissage automatique qui quantifie l’écart entre les prédictions du modèle et les valeurs réelles. Son but est de guider le processus de formation en minimisant cette différence, permettant ainsi au modèle d’apprendre plus efficacement. Il existe différents types de fonctions de perte, tels que l’erreur quadratique moyenne et l’entropie croisée, chacun adapté à différentes tâches et...
Nous utilisons le catégorique_crossentropie fonction de perte utilisée dans la tâche de classification. Cette perte est une très bonne mesure de la distinction entre deux distributions de probabilité discrètes..
S'il vous plait, Veuillez vous référer au lien ci-dessous pour une description détaillée des différents types de fonction de perte:
· Optimiseur
Nous utilisons Adam Optimiserr utilisé pour mettre à jour les poids du réseau de neurones et le taux d'apprentissage. Les optimiseurs sont utilisés pour résoudre les problèmes d'optimisation en minimisant la fonction.
S'il vous plait, voir le lien ci-dessous pour une explication détaillée des différents types d'optimiseur:
· Arguments de métrique
Ici, nous utilisons la précision comme métrique pour évaluer les performances de l'algorithme de réseau neuronal convolutif.
Paso 2: adapter le modèle à l'ensemble d'entraînement
Ligne de code:
model.fit_generator(ensemble d'entraînement,validation_data=test_set,époques=50, step_per_epoch = seulement(ensemble d'entraînement), validation_steps=len(ensemble d'essai) )
Nous ajustons le modèle CNN sur l'ensemble de données d'entraînement avec 50 itérations et chaque itération a différentes étapes pour entraîner et évaluer les étapes en fonction de la durée du test et de l'ensemble d'entraînement.
Paso 3: – Évaluer le résultat
Nous comparons la fonction de précision et de perte pour l'ensemble de données d'entraînement et de test.
Code: Graphique des pertes
plt.plot(r.histoire['perte'], étiquette="perte de train")
plt.plot(r.histoire['val_loss'], étiquette="perte de valeur")
plt.légende()
plt.show()
plt.savefig('LossVal_loss')
Production
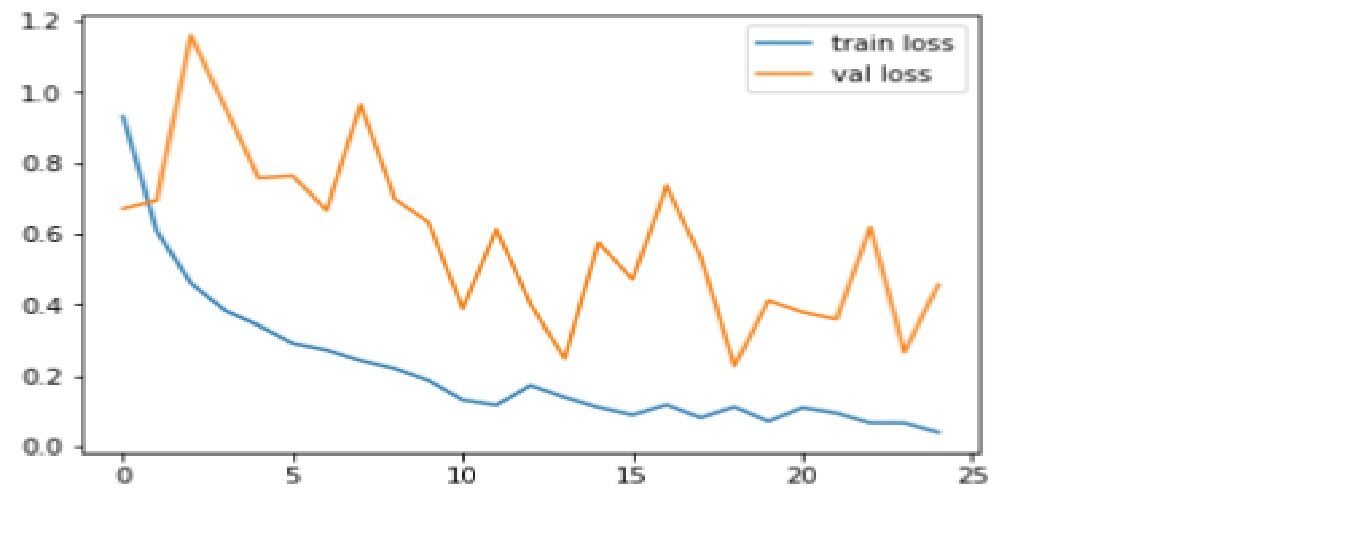
La perte est la punition pour une mauvaise prédiction. L'objectif est de réduire au maximum la perte de validation. Un peu de surapprentissage est presque toujours une bonne chose. Tout ce qui compte, à la fin, il est: est la perte de validation la plus faible possible.
Code: Tracer un graphique de précision
plt.plot(r.histoire['précision'], étiquette="train acc")
plt.plot(r.histoire['val_accuracy'], étiquette="val acc")
plt.légende()
plt.show()
plt.savefig('AccVal_acc')
Production
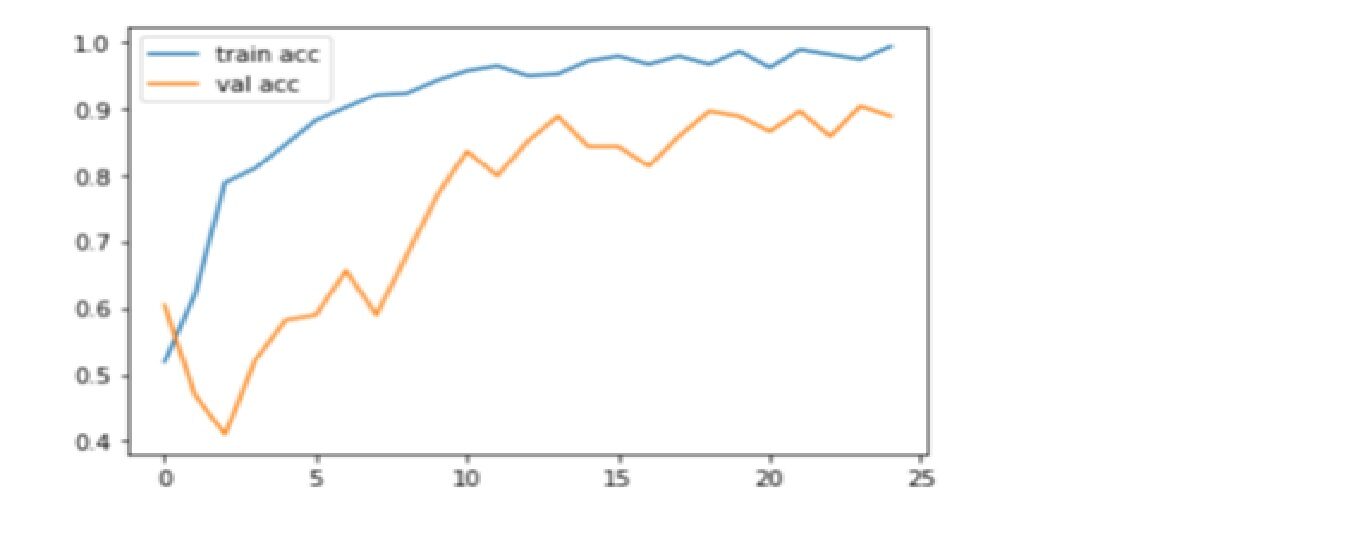
La précision est une métrique pour évaluer les modèles de classification. Informellement, la précision est la fraction des prédictions que notre modèle a obtenues. Ici, on voit que la précision est proche de 90% dans le test de validation montrant qu'un modèle CNN fonctionne bien sur les métriques de précision.
Merci pour la lecture! Bon apprentissage en profondeur!
Les références:
1. https://www.superdatascience.com/
2. https://www.youtube.com/watch?v=H-bcnHE6Mes
Sur moi :
Soja Jitendra Sharma, Stagiaire data science chez Nabler, y me dedico a PGDM-Big Data Analytics del Goa Institute of Management. Vous pouvez me contacter via LinkedIn Oui Github.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





