
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction:
L'extraction de données est le processus d'extraction de données à partir de diverses sources telles que des fichiers CSV, la toile, PDF, etc. Bien que dans certains fichiers, les données peuvent être facilement extraites comme dans CSV, tandis que dans des fichiers comme les PDF non structurés, nous devons effectuer des tâches supplémentaires pour extraire des données.
Il existe quelques bibliothèques Python avec lesquelles vous pouvez extraire des données de fichiers PDF. Par exemple, vous pouvez utiliser le PyPDF2 bibliothèque pour extraire du texte à partir de fichiers PDF où le texte est séquentiel ou formaté, c'est-à-dire, en lignes ou en formes. Vous pouvez également extraire des tableaux au format PDF via le Camelot Une bibliothèque. Dans tous ces cas, les données sont sous forme structurée, c'est-à-dire, séquentiel, formulaires ou tableaux.
Cependant, Dans le monde réel, la plupart des données ne sont présentes dans aucun des formulaires et il n'y a pas d'ordre de données. Il est présent sous une forme non structurée. Dans ce cas, il n'est pas possible d'utiliser les bibliothèques python ci-dessus, car ils donneront des résultats ambigus. Pour analyser des données non structurées, nous devons les convertir en une forme structurée.
En tant que tel, il n'y a pas de technique ou de procédure spécifique pour extraire des données de fichiers PDF non structurés, car les données sont stockées de manière aléatoire et cela dépend du type de données que vous souhaitez extraire du PDF.
Ici, Je vais vous montrer une technique plus efficace et une bibliothèque Python à travers laquelle vous pouvez extraire des données de cadres de délimitation dans des fichiers PDF non structurés, puis effectuez l'opération de nettoyage des données sur les données extraites et convertissez-les en un format structuré.
PyMuPDF:
j'ai utilisé le PyMuPDF bibliothèque à cet effet. Cette bibliothèque a fourni de nombreuses applications, comment extraire des images d'un PDF, extraire des textes de différentes manières, faire des annotations, dessinez un cadre de délimitation autour des textes ainsi que des fonctionnalités de la bibliothèque telles que PyPDF2.
À présent, Je vais vous montrer comment j'ai extrait des données de cadres de délimitation dans un PDF avec plusieurs pages.
Voici le PDF et les cadres de délimitation rouges dont nous avons besoin pour extraire les données.
J'ai essayé de nombreuses bibliothèques python comme PyPDF2, Mineur de PDF, luciopdf, Camelot y tabulé. Cependant, aucun d'eux n'a fonctionné sauf PyMuPDF.
Avant de saisir le code, il est important de comprendre le sens de 2 termes importants qui vous aideraient à comprendre le code.
Mot: Séquence de caractères sans espaces. Ex – cendre, 23, 2, 3.
Annotations: une annotation associe un objet en tant que note, une image ou un cadre de sélection avec un emplacement sur une page d'un document PDF, ou fournit un moyen d'interagir avec l'utilisateur à l'aide de la souris et du clavier. Les objets sont appelés annotations.
Notez que, dans notre cas, cadre de délimitation, les annotations et les rectangles sont les mêmes. Pourtant, ces termes seraient utilisés indifféremment.
Premier, nous allons extraire le texte de l'un des cadres de délimitation. Ensuite, nous utiliserons la même procédure pour extraire les données de toutes les boîtes englobantes du pdf.
Code:
importer fitz
importer des pandas au format pd
doc = fitz.open('Mansfield--70-21009048 - ConvertToExcel.pdf')
page1 = doc[0]
mots = page1.get_text("mots")
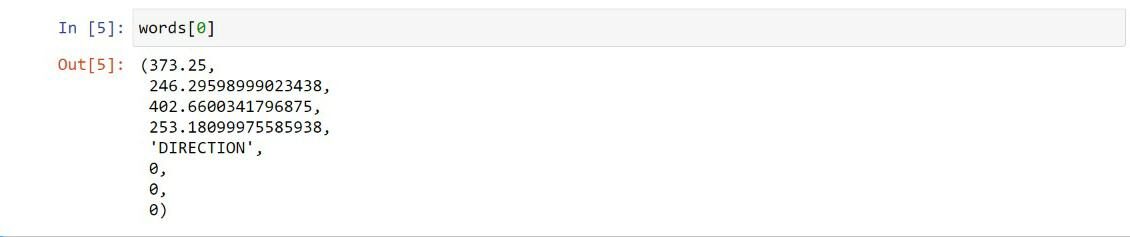
En premier lieu, nous importons le Fitz module de la PyMuPDF bibliothèque et bibliothèque des pandas. Alors, l'objet fichier PDF est créé et stocké dans le document et la première page du pdf est stockée dans la page 1. page.get_text () extraire tous les mots de la page 1. Chaque mot est constitué d'un tuple avec 8 éléments.
En mots variables, les premiers 4 les éléments représentent les coordonnées du mot, le cinquième élément est le mot lui-même, sixième, septième, les huitièmes éléments sont des numéros de bloc, ligne et mot, respectivement.
PRODUCTION
Extraire les coordonnées du premier objet:
first_annots=[]

rec=page1.first_annot.rect

rec

#Les informations des mots du premier objet sont stockées dans mywords

mes mots = [w pour w dans les mots si fitz.Rect(w[:4]) en rec]

ann= faire_texte(mes mots)

first_annots.append(Anne)
Cette fonction sélectionne les mots contenus dans la case, trier les mots et renvoyer sous forme de chaîne:
def make_text(mots):

    line_dict = {}

    mots.trier(clé=lambda w: w[0])

    pour w en mots:

        y1 = rond(w[3], 1)

        mot = w[4]

        ligne = ligne_dict.get(y1, [])

        ligne.append(mot)

        line_dict[y1] = ligne

    lignes = liste(line_dict.items())

    lignes.tri()

    revenir "m".rejoindre([" ".rejoindre(ligne[1]) pour ligne en lignes])
PRODUCTION
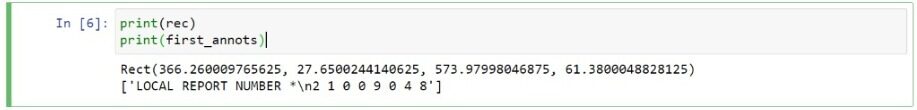
page.first_annot () donne la première annotation, c'est-à-dire, le cadre de délimitation de la page.
.droit donne les coordonnées d'un rectangle.
À présent, on a les coordonnées du rectangle et tous les mots de la page. Ensuite, nous filtrons les mots présents dans notre cadre de délimitation et les stockons dans mes mots variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.....
Nous avons tous les mots dans le rectangle avec leurs coordonnées. Cependant, ces mots sont dans un ordre aléatoire. Comme nous avons besoin du texte séquentiellement et que cela n'a de sens que, nous utilisons une fonction make_text () qui ordonne d'abord les mots de gauche à droite puis de haut en bas. Renvoie le texte au format chaîne.
Hourra! Nous avons extrait des données d'un commentaire. Notre prochaine tâche consiste à extraire les données de toutes les annotations du PDF, ce qui serait fait avec la même approche.
Extraire chaque page du document et toutes les annotations / redresser:
pour pageno dans la plage(0,longueur(doc)-1):

    page = doc[pageno]

    mots = page.get_text("mots")

    pour annot dans page.annots():

        sinon!=Aucun:

            rec=annot.rect

            mes mots = [w pour w dans les mots si fitz.Rect(w[:4]) en rec]

            ann= faire_texte(mes mots)

            all_annots.append(Anne)
all_annots, une liste est initialisée pour stocker le texte de toutes les annotations dans le pdf.
La fonction de la boucle externe dans le code ci-dessus est de parcourir chaque page du PDF, tandis que celui de la boucle interne consiste à examiner toutes les annotations sur la page et à effectuer la tâche d'ajouter des textes à la liste all_annots comme indiqué ci-dessus.
L'impression all_annots nous donne le texte de toutes les annotations du pdf que vous pouvez voir ci-dessous.
PRODUCTION
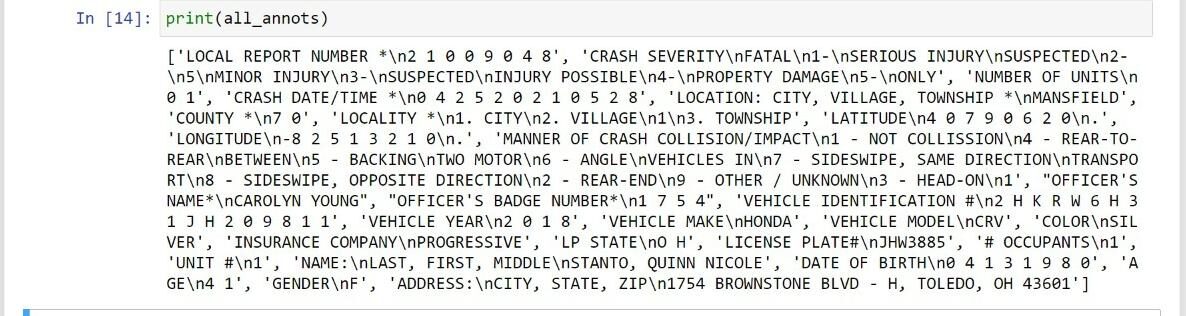
Finalement, nous avons extrait les textes de toutes les annotations / cadres de délimitation.
Il est temps de nettoyer les données et de les apporter de manière compréhensible.
Nettoyage et traitement des données
Division pour former le nom de la colonne et ses valeurs:
suite =[]

pour moi à portée(0,longueur(all_annots)):

    suite.append(all_annots[je].diviser('n',1))
Supprimer les symboles inutiles *, # ,:
liss=[]

pour moi à portée(0,longueur(Compte)):

    lis=[]

    pour j en cont[je]:

        j=j.remplacer('*','')

        j=j.remplacer('#','')

        j=j.remplacer(':','')

        j=j.bande()

        #imprimer(j)

        lis.append(j)

    liss.append(lis)
Diviser en clés et valeurs et supprimer les espaces dans les valeurs qui ne contiennent que des chiffres:
clés=[]

valeurs=[]

pour moi dans liss:

    keys.append(je[0])

    valeurs.append(je[1])

pour moi à portée(0, longueur(valeurs)):

    pour j dans la plage(0,longueur(valeurs[je])):

        si valeurs[je][j]>='A' and values[je][j]<='Z':

            Pause

    si j==len(valeurs[je])-1:
       valeurs[je]=valeurs[je].remplacer(' ','')
Nous divisons chaque chaîne en fonction d'un nouveau caractère de ligne (m) séparer le nom de la colonne de ses valeurs. En nettoyant plus, symboles inutiles tels que (*, #, 🙂. Les espaces entre les chiffres sont supprimés.
Avec des paires clé-valeur, nous créons un dictionnaire montré ci-dessous:
Conversion en dictionnaire:
rapport=dict(Zip *: français(clés,valeurs))
rapport[« IDENTIFICATION DU VÉHICULE »]= rapport[« IDENTIFICATION DU VÉHICULE »].remplacer(‘ ‘, »)
déc =[rapport['LOCALITY'],rapport['MANNER OF CRASH COLLISION/IMPACT'],rapport['CRASH SEVERITY']]

l=0

val_after=[]

pour local en dic:

    li =[]

    lii =[]

    k=''

    extract=""

    l=0

    pour moi à portée(0,longueur(local)-1):

        si local[i+1]>='0' and local[i+1]<='9':

            li.append(local[je:i+1])

            l = je + 1

    li.append(local[je:])

    imprimer(au)

    pour moi en li:

        si je[0] dans lii:

            k=je[0]

            Pause

        lii.append(je[0])

    pour moi en li:

        si je[0]==k:
extrait = je
            val_after.append(extrait)
Pause
rapport['LOCALITY']=val_après[0]
rapport['MANNER OF CRASH COLLISION/IMPACT']=val_après[1]
rapport['CRASH SEVERITY']=val_après[2]
PRODUCTION
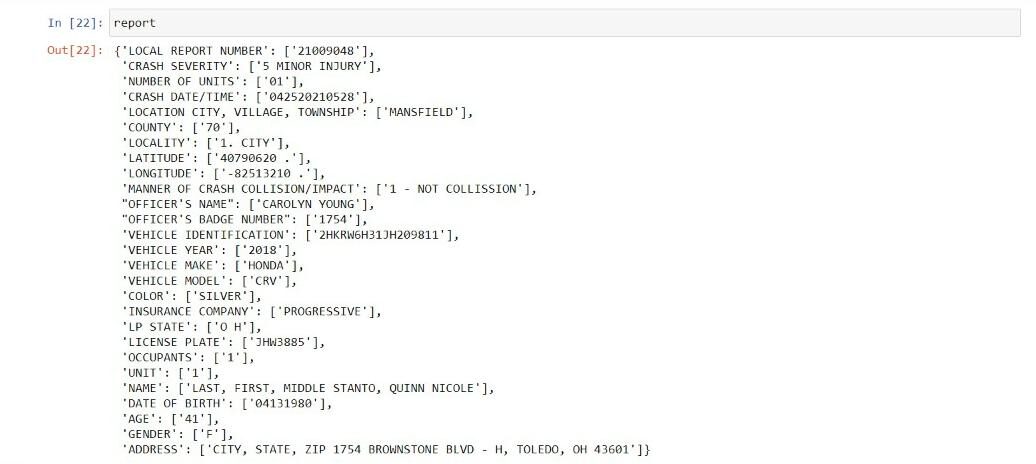
Finalement, le dictionnaire est converti en bloc de données à l'aide de pandas.
Convertir en DataFrame et exporter au format CSV:
data=pd.DataFrame.from_dict(rapport)
data.to_csv('final.csv',index=Faux)
PRODUCTION
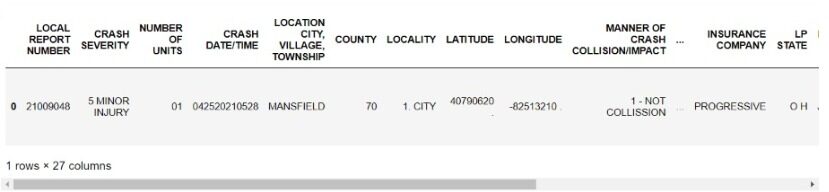
À présent, nous pouvons effectuer une analyse de nos données structurées ou les exporter vers Excel.
J'espère que vous avez apprécié la lecture de ce blog et qu'il vous a donné un aperçu de la façon de traiter les données non structurées..
Les références:
Source de l'image en vedette: Python réel https://realpython.com/python-data-engineer/
Documentation PyMuPDF: https://pymupdf.readthedocs.io/en/latest/
A propos de l'auteur:
Salut! Soja Ashish Choudhary. J'étudie le B.Tech de l'Université des sciences et technologies JC Bose. La science des données est ma passion et je suis fier d'écrire des blogs intéressants à ce sujet. N'hésitez pas à me contacter sur Linkedin linkedin.com/in/ashish-choudhary-7b6029166.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





