
introduction
« Les données sont le carburant des algorithmes d'apprentissage automatique ».
Avant de rechercher des informations à partir des données, nous devons d'abord effectuer des tâches de prétraitement qui nous permettent ensuite uniquement d'utiliser ces données pour une observation plus approfondie et d'entraîner notre modèle d'apprentissage automatique.
Une correction des valeurs manquantes est nécessaire pour réduire le biais et produire des modèles adaptés puissants. La plupart des algorithmes ne peuvent pas gérer les données manquantes, vous devez donc agir d'une manière ou d'une autre pour ne pas laisser votre code planter. Ensuite, commençons par les méthodes pour résoudre le problème.
Méthodes de traitement des valeurs manquantes
Exemple 1, Nous allons avoir un jeu de données factice dans lequel il y a trois caractéristiques indépendantes (prédicteurs) et une caractéristique dépendante (réponse).
| Caractéristique-1 | Caractéristique-2 | Caractéristique-3 | Production |
| Masculin | 23 | 24 | Oui |
| – – – – | 24 | 25 | Non |
| Femme | 25 | 26 | Oui |
| Masculin | 26 | 27 | Oui |
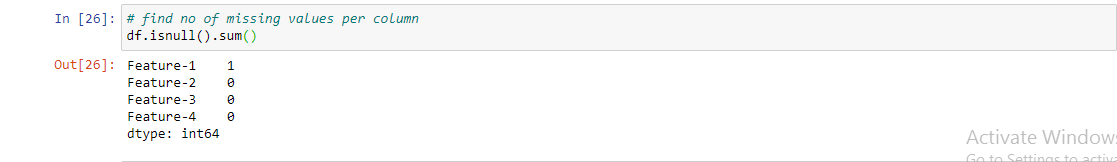
Ici, nous avons une valeur manquante dans la ligne 2 pour Feature-1.
Les méthodes populaires utilisées par la communauté de l'apprentissage automatique pour gérer la valeur manquante des variables catégorielles dans l'ensemble de données sont les suivantes:
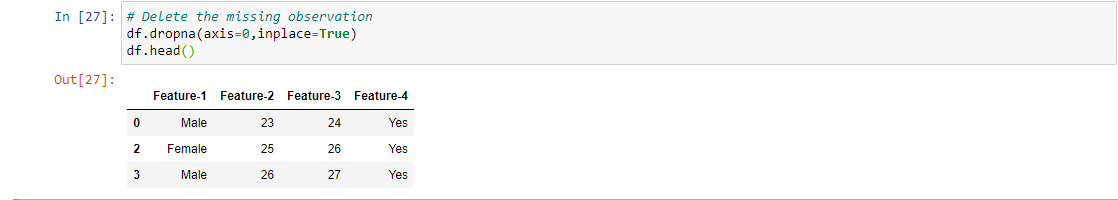
1. Supprimer les observations: S'il y a un grand nombre d'observations dans l'ensemble de données, où toutes les classes à prédire sont suffisamment représentées dans les données d'apprentissage, essayer de supprimer les observations de valeur manquantes, qui ne générerait pas de modifications significatives de votre flux à partir de votre modèle.
Par exemple, 1, Implémenter cette méthode sur un jeu de données donné, nous pouvons supprimer toute la ligne contenant les valeurs manquantes (supprimer la ligne 2).
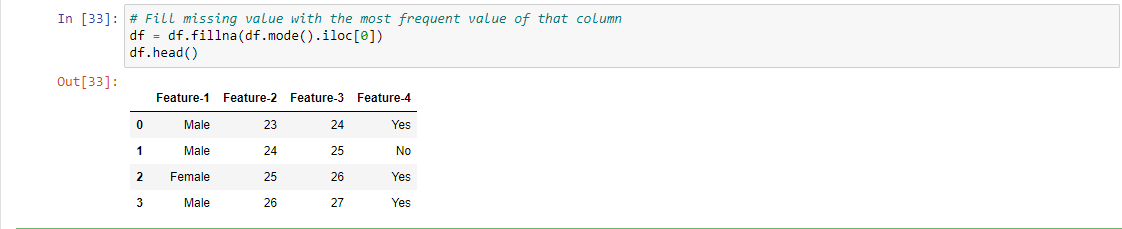
2. Remplacer les valeurs manquantes par la valeur la plus fréquente: Vous pouvez toujours les facturer en fonction de Façon dans le cas des variables catégorielles, assurez-vous que vous n'avez pas de distributions de classes très asymétriques.
REMARQUE: Mais dans certains cas, cette stratégie peut rendre les données déséquilibrées dans les classes wrt s'il y a beaucoup de valeurs manquantes présentes dans notre ensemble de données.
– Généralement, remplacer les valeurs manquantes par la moyenne / médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes.... / la mode est une façon grossière de gérer les valeurs perdues. Selon le contexte, comme si la variation est faible ou si elle variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... a un effet de levier faible sur la réponse, une telle approximation est acceptable et pourrait donner des résultats satisfaisants. Dans ce cas, puisque vous dites que c'est une variable catégorielle, cette étape peut ne pas être applicable.
Par exemple, 1, Pour mettre en œuvre cette méthode, nous remplaçons la valeur manquante par la valeur la plus fréquente pour cette colonne particulière, ici nous remplaçons la valeur manquante par Male puisque le nombre de Male est supérieur à Female (mâle = 2 et Féminin = 1).
3. Développer un modèle pour prédire les valeurs manquantes: Un moyen astucieux de le faire pourrait être de former un classificateur sur vos colonnes avec des valeurs manquantes en tant que variable dépendante par rapport à d'autres caractéristiques de votre ensemble de données et d'essayer d'imputer en fonction du classificateur nouvellement formé..
Voici l'algorithme que vous pouvez suivre:
– Divisez les données en deux parties. Une partie aura les valeurs actuelles de la colonne, y compris la colonne de sortie d'origine, l'autre partie aura les lignes avec les valeurs manquantes.
– Diviser la 1ère partie (valeurs actuelles) dans un ensemble de validation croisée pour la sélection de modèle.
– Entraînez vos modèles et testez vos métriques avec des données à validation croisée. Vous pouvez également effectuer une recherche par grille ou une recherche aléatoire pour obtenir les meilleurs résultats.
– Finalement, avec le modèle, prédit les valeurs inconnues manquantes de notre problème.
REMARQUE: Puisque vous essayez d'imputer les valeurs manquantes, les choses seront plus agréables ainsi, car ils ne sont pas biaisés et vous obtenez les meilleures prédictions du meilleur modèle.
Par exemple, 1, Pour mettre en œuvre la stratégie donnée, nous allons d'abord considérer la colonne Caractéristique-2, Feature-3 et sortie pour notre nouveau classificateur, qu'est-ce que ça veut dire que tu es 3 Les colonnes sont utilisées comme caractéristiques indépendantes pour notre nouveau classificateur et Caractéristique-1 est considérée comme un résultat et une note objective qu'ici nous ne considérons que les lignes qui ne manquent pas, puisque nos données de train et observations qui ont une valeur manquante deviendront nos données de test. Nous devons faire la prédiction en utilisant notre modèle sur les données de test et, après les pronostics, nous avons l'ensemble de données sans valeur manquante.
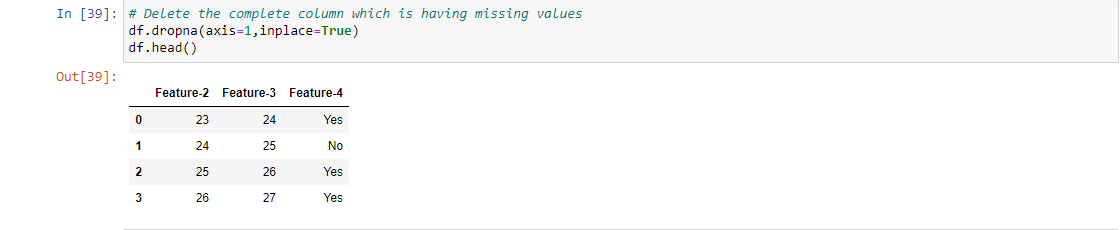
4. Éliminer la variable: S'il y a un ensemble exceptionnellement plus grand de valeurs manquantes, essayez d'exclure la variable elle-même pour un modèle supplémentaire, mais il faut s'assurer qu'elle n'est pas très significative pour prédire la variable cible, c'est-à-dire, la corrélation entre la variable rejetée et la variable cible est très faible ou redondante.
Par exemple, 1, Pour mettre en œuvre cette stratégie pour gérer les valeurs manquantes, nous devons supprimer toute la colonne qui contient les valeurs manquantes, ainsi, pour un ensemble de données donné, nous supprimons complètement la caractéristique-1 et utilisons uniquement les caractéristiques de gauche pour prédire notre variable cible.
5. Appliquer des techniques d'apprentissage automatique non supervisées: Dans cette approche, nous utilisons des techniques non supervisées telles que K-moyens, Regroupement hiérarchique, etc. L'idée est que vous pouvez ignorer les colonnes qui ont des valeurs manquantes et considérer toutes les autres colonnes à l'exception de la colonne cible et essayer de créer autant qu'aucun cluster de caractéristiques indépendantes (après avoir supprimé les colonnes de valeurs manquantes), enfin trouver la catégorie dans laquelle se trouve la ligne manquante.
Par exemple, 1, Pour mettre en œuvre cette stratégie, nous supprimons la colonne Caractéristique-1, puis nous utilisons Caractéristique-2 et Caractéristique-3 comme caractéristiques pour le nouveau classificateur, puis, finalement, après la formation de grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois...., nous essayons de voir dans quel cluster se trouve l'enregistrement manquant et nous sommes prêts avec notre ensemble de données final pour une analyse plus approfondie.
Implémentation Python
Importer les dépendances requises.

Charger et lire l'ensemble de données.

Trouver le nombre de valeurs manquantes par colonne.
Appliquer la stratégie-1 (supprimer les observations manquantes).
Appliquer la stratégie-2 (Remplacer les valeurs manquantes par la valeur la plus fréquente).
Appliquer la stratégie-3 (Supprimer la variable qui a des valeurs manquantes).
Appliquer la stratégie 4 (Développer un modèle pour prédire les valeurs manquantes).
Pour cette stratégie, nous encodons d'abord nos colonnes catégorielles indépendantes à l'aide de « One Hot Encoder » et les colonnes catégorielles dépendantes à l'aide de « Label Encoder ».
– Lire et charger l'ensemble de données encodées.
– Faire des enregistrements manquants comme nos données de test.
– Faites des enregistrements complets comme nos données de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.....
– Séparer les variables indépendantes et dépendantes.

– Ajuster notre modèle de régression logistique.
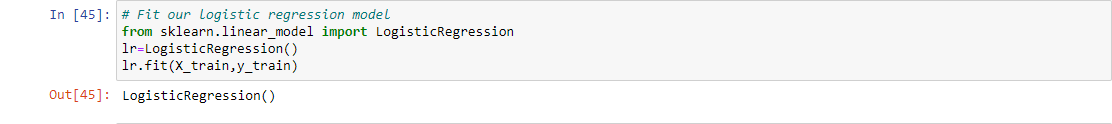
– Prédire la classe des enregistrements manquants.

Ceci termine notre partie de mise en œuvre!!
Remarques finales
Merci pour la lecture!
Cet article vous présente différentes manières d'aborder le problème des valeurs manquantes pour les variables catégorielles..
Si vous avez aimé cela et que vous voulez en savoir plus, visitez mes autres articles sur la science des données et l'apprentissage automatique en cliquant sur le lien
N'hésitez pas à me contacter au Linkedin, Courrier électronique.
Tout ce qui n'est pas mentionné ou voulez-vous partager vos pensées? N'hésitez pas à commenter ci-dessous et je vous répondrai.
Jusque là, rester à la maison, rester en sécurité pour éviter la propagation de COVID-19 [feminine, Et continue d'apprendre!
A propos de l'auteur
Chirag Goyal
Actuellement, Je poursuis mon Bachelor of Technology (B.Tech) en informatique et ingénierie de l'Institut indien de technologie, Jodhpur (IITJ). Je suis très enthousiasmé par l'apprentissage automatique, les l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... et l’intelligence artificielle.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





