
introduction
Dans cet article, nous passerons en revue l'ensemble de données populaire du Titanic et essaierons de prédire si une personne a survécu à l'épave. Vous pouvez obtenir cet ensemble de données à partir de Kaggle, lié ici. Cet article se concentrera sur la façon de penser à ces projets, plus que dans la mise en œuvre. Beaucoup de débutants ne savent pas comment commencer, quand finir et tout le reste, J'espère que cet article vous servira de manuel pour débutant.. Je vous propose de pratiquer le projet à Kaggle.
L'objectif: prédire si un passager a survécu ou non. 0 pour ne pas avoir survécu, 1 Pour survivre.
Description des données
Dans cet article, nous allons faire une analyse de données de base, puis un peu d'ingénierie des fonctionnalités et, à la fin, nous utiliserons certains des modèles populaires pour la prédiction. Commençons.
L'analyse des données
Paso 1: Importation de bibliothèques de base
importer numpy en tant que np
importer des pandas au format pd
importer seaborn comme sns
importer matplotlib.pyplot en tant que plt
%matplotlib en ligne
Paso 2: lire les données
formation = pd.read_csv('/kaggle/input/titanic/train.csv')
test = pd.read_csv('/kaggle/input/titanic/test.csv')
entraînement['train_test'] = 1
test['train_test'] = 0
test['Survécu'] = np.NaN
all_data = pd.concat([entraînement,test])
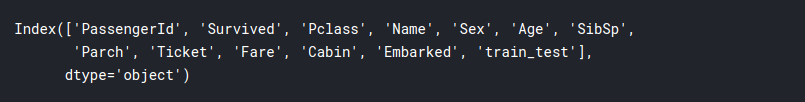
all_data.columns
Paso 3: exploration des données
Dans cette section, nous essaierons d'extraire des connaissances des données et de nous familiariser avec celles-ci afin de créer des modèles plus efficaces.
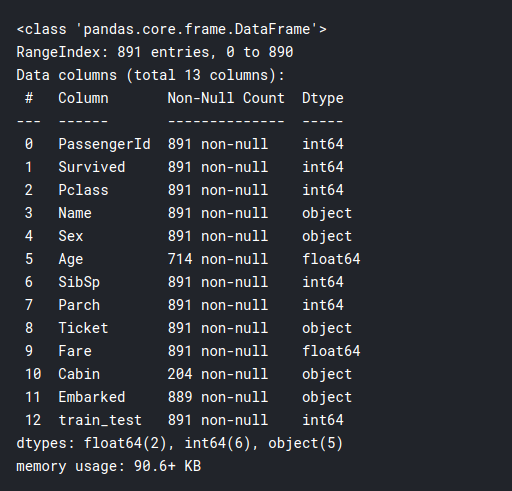
formation.info()
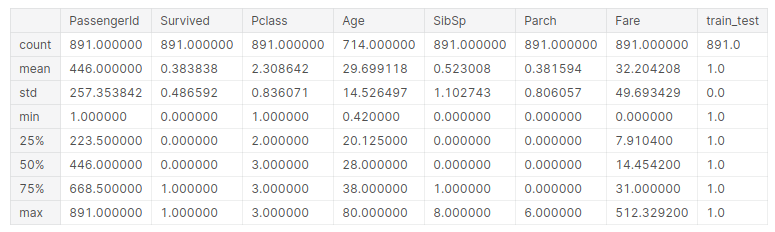
formation.décrire()
# séparer les données en numérique et catégoriel
df_num = entraînement[['Âge','SibSp','Parch',Tarif]]
df_cat = formation[['Survécu','Pclass','Sexe','Ticket','Cabin','Embarquement']]
Maintenant, traçons les données numériques:
pour i dans df_num.columns:
    plt.hist(df_num[je])
    plt.titre(je)
    plt.show()
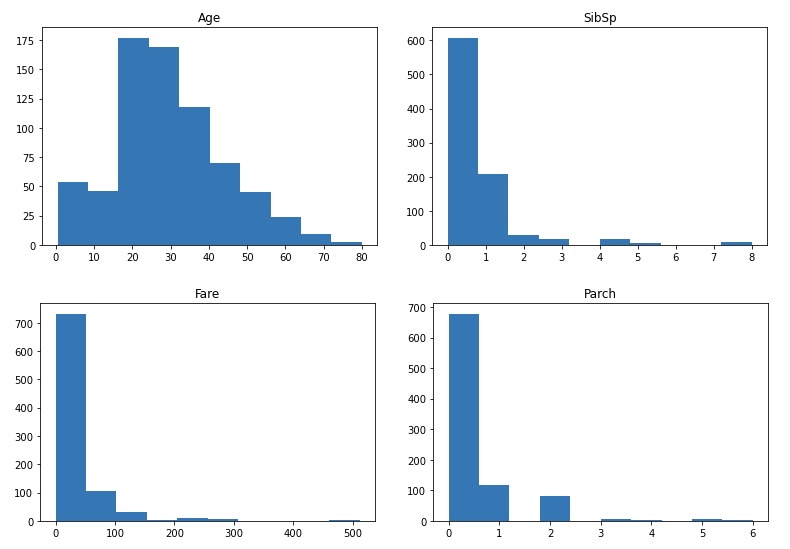
Ensuite, Comme vous pouvez le voir, la plupart des distributions sont dispersées, sauf Âge, est assez normalisé. Nous pourrions envisager de les normaliser plus tard. Ensuite, trazamos un carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées.... de correlación entre las columnas numéricas:
sns.heatmap(df_num.corr())
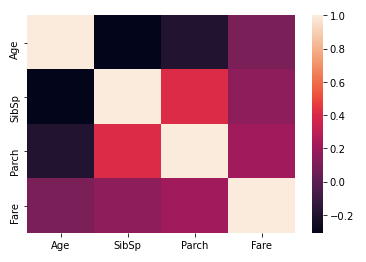
Ici, nous pouvons voir que Parch et SibSp ont une corrélation plus élevée, ce qui est généralement logique car les parents sont plus susceptibles de voyager avec plusieurs enfants et les conjoints ont tendance à voyager ensemble. Ensuite, comparons les taux de survie entre les variables numériques. Cela pourrait révéler des idées intéressantes:
pd.table_pivot(entraînement, index = 'Survived', valeurs = ['Âge','SibSp','Parch',Tarif])
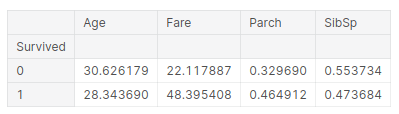
L'inférence que nous pouvons tirer de ce tableau est:
- L'âge moyen des survivants est 28 ans, donc les jeunes ont tendance à survivre plus longtemps.
- Les personnes qui payaient des taux plus élevés avaient plus de chances de survivre, plus du double. Cela pourrait être les personnes qui voyagent en première classe. C'est ainsi que les riches ont survécu, qui est une triste histoire sur cette scène.
- Dans la troisième colonne, si tu as des parents, a plus de chances de survivre. Ensuite, les parents auraient pu sauver les enfants avant eux, expliquant ainsi les taux
- Et si vous êtes un enfant et que vous avez des frères et sœurs, tu as moins de chance de survivre.
Maintenant, nous faisons quelque chose de similaire avec nos variables catégorielles:
pour moi dans df_cat.columns:
    sns.barplot(df_cat[je].value_counts().indice,df_cat[je].value_counts()).set_title(je)
    plt.show()
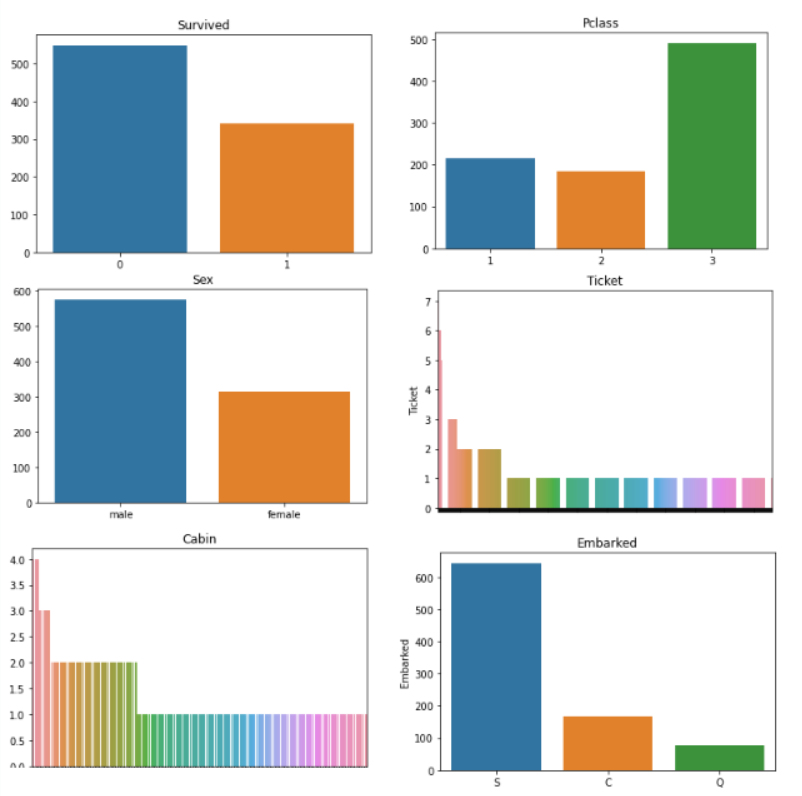
Les graphismes des billets et des cabines ont l'air très désordonnés, Nous devrons peut-être les concevoir! À part ça, le reste des graphiques nous dit:
- Survécu: la plupart des gens sont morts dans le naufrage, juste un peu 300 les gens ont survécu.
- Classe P: La plupart des personnes qui voyageaient avaient des billets pour la 3e classe.
- Sexe: il y avait plus d'hommes que de femmes à bord du navire, environ le double du montant.
- Embarqué: La plupart des passagers sont montés à bord du navire depuis Southampton.
Ahora haremos algo similar a la table dynamiqueLe tableau croisé dynamique est un outil puissant dans les tableurs, tels que Microsoft Excel et Google Sheets. Vous permet de résumer, Analysez et visualisez efficacement de grands volumes de données. Grâce à son interface intuitive, Les utilisateurs peuvent réorganiser les informations, Appliquez des filtres et créez des rapports personnalisés, faciliter la prise de décisions éclairées dans divers contextes, Du domaine de l’entreprise à la recherche académique.... antérieur, mais avec nos variables catégorielles, y las compararemos con nuestra variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dépendant, et si les gens survivaient:
imprimer(pd.table_pivot(entraînement, index = 'Survived', colonnes="Classe P",
                     valeurs="Billet" ,aggfunc="compter"))
imprimer()
imprimer(pd.table_pivot(entraînement, index = 'Survived', colonnes="Sexe",
                     valeurs="Billet" ,aggfunc="compter"))
imprimer()
imprimer(pd.table_pivot(entraînement, index = 'Survived', colonnes="Embarqué",
                     valeurs="Billet" ,aggfunc="compter"))
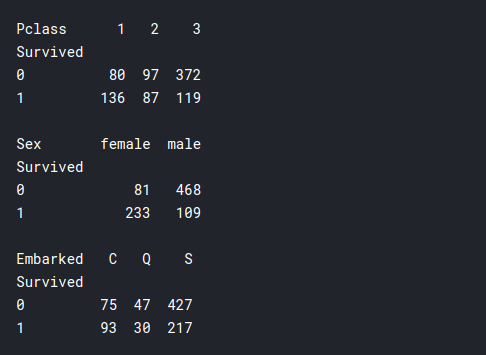
- Classe P: Ici, nous pouvons voir que beaucoup plus de personnes ont survécu de la première classe que de la deuxième ou de la troisième classe., même si le nombre total de passagers en Première classe était beaucoup plus faible qu'en Troisième classe. Donc, ici, notre hypothèse antérieure selon laquelle les riches ont survécu est confirmée, ce qui pourrait être pertinent pour la construction de modèles.
- Sexe: la plupart des femmes ont survécu et la plupart des hommes sont morts dans le naufrage. Donc, il semble que le dicton « La femme et les enfants d'abord » s'applique réellement dans ce scénario.
- Embarqué: Cela ne semble pas très pertinent., peut-être que si quelqu'un venait de « Cherbourg"J'avais plus de chance de survivre.
Paso 4: Ingénierie fonctionnelle
Nous avons vu que notre billet Oui cabine les données n'ont pas vraiment de sens pour nous, et cela pourrait nuire aux performances de notre modèle, nous devons donc simplifier certaines de ces données avec l'ingénierie des fonctions.
Si nous regardons les données réelles de la cabine, on voit qu'en gros il y a une lettre puis un chiffre. Les lettres peuvent signifier de quel type de cabine il s'agit, où vous êtes sur le navire, à quel étage, c'est pour quelle classe, etc. Et les chiffres peuvent signifier le numéro de la cabine. Divisons-les d'abord en cabines individuelles et voyons si quelqu'un avait plus d'une cabine.
df_cat.Cabine
entraînement['cabin_multiple'] = formation.cabine.appliquer(lambda x: 0 si pd.isna(X)
                                                    d'autre len(x.split(' ')))
entraînement['cabin_multiple'].value_counts()
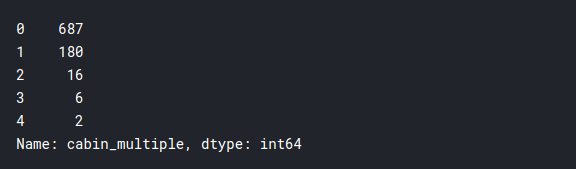
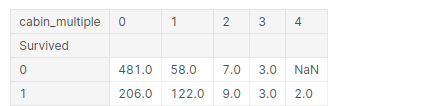
Il semble que la grande majorité ne disposait pas de cabines individuelles, et seules quelques personnes avaient plus d'une cabine. Voyons maintenant si les taux de survie en dépendent:
pd.table_pivot(entraînement, index = 'Survived', colonnes="cabine_multiple",
               valeurs="Billet" ,aggfunc="compter")
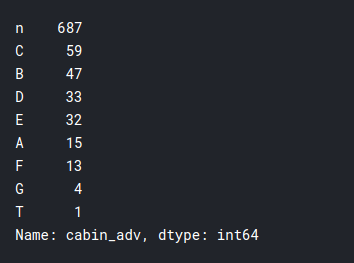
Ensuite, Voyons la lettre réelle de la cabine dans laquelle ils se trouvaient. Donc, vous pouvez vous attendre à ce que les cabines avec la même lettre soient à peu près aux mêmes endroits ou aux mêmes étages et, logiquement, si une cabine était près des canots de sauvetage, ils avaient plus de chance de survivre. Jetons un coup d'oeil à ça:
# n signifie nul
# in this case we will treat null values like it's own category
training['cabin_adv'] = formation.cabine.appliquer(lambda x: str(X)[0])
#comparer les taux de survie par cabine
imprimer(training.cabin_adv.value_counts())
pd.table_pivot(entraînement,index='Survived',colonnes="cabine_adv",
                        valeurs="Nom", aggfunc="compter")
J'ai fait de l'ingénierie future dans le billet colonne et n'a pas donné beaucoup d'informations importantes, qu'on ne sait toujours pas, donc je vais sauter cette partie pour garder l'article concis. Nous diviserons simplement les tickets en numérique et non numérique pour une utilisation efficace:
entraînement['numeric_ticket'] = training.Ticket.apply(lambda x: 1 si x.isnumeric() autre 0)
entraînement['ticket_letters'] = training.Ticket.apply(lambda x: ''.join(x.split(' ')[:-1])
                                            .remplacer('.','').remplacer('/','')
                                            .inférieur() si len(x.split(' ')[:-1]) >0 autre 0)
Une autre chose intéressante que nous pouvons observer est le titre des passagers individuels. Et s'il a joué un rôle pour leur obtenir une place dans les canots de sauvetage.
formation.Nom.head(50)
entraînement['name_title'] = formation.Nom.appliquer(lambda x: x.split(',')[1]
                                                        .diviser('.')[0].déshabiller())
entraînement['name_title'].value_counts()
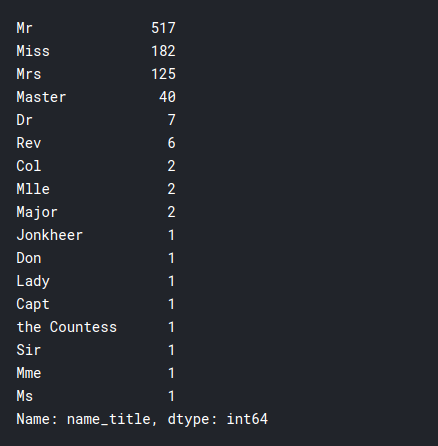
Comme tu peux le voir, le navire a été embarqué par des personnes de différentes classes, cela pourrait être utile dans notre modèle.
Paso 5: prétraitement des données pour le modèle
Dans ce segment, nous préparons nos données pour les modèles. Les objectifs que nous devons atteindre sont énumérés ci-dessous:
- Supprimer les valeurs nulles de la colonne Expédié
- Inclure uniquement les données pertinentes
- Transformez catégoriquement toutes les données, en utilisant quelque chose appelé un transformateur.
- Imputation des données avec tendances centrales par âge et taux.
- Normaliser le taux colonne pour avoir une distribution plus normale.
- en utilisant des données d'échelle d'échelle standard 0-1
Paso 6: Implémentation du modèle
Aquí simplemente implementaremos los diversos modelos con paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... predeterminados y veremos cuál produce el mejor resultado. Les modèles peuvent être ajustés davantage pour de meilleures performances, mais ils ne sont pas dans le cadre de cet article. Les modèles que nous allons exécuter sont:
- Régression logistique
- K Voisin le plus proche
- Classificateur de vecteur de support
Premier, nous importons les modèles nécessaires
à partir de sklearn.model_selection importer cross_val_score
de sklearn.linear_model import LogisticRegression
de sklearn.neighbors importer KNeighborsClassifier
de sklearn.svm importer SVC
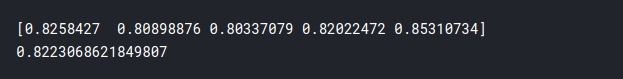
1) Régression logistique
lr = Régression Logistique(max_iter = 2000)
cv = cross_val_score(g / D,X_train_scaled,y_train,cv=5)
imprimer(CV)
imprimer(cv.moyen())
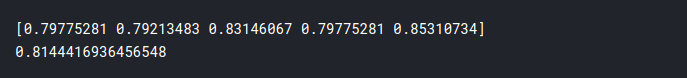
2) K Voisin le plus proche
knn = KNeighborsClassifier()
cv = cross_val_score(knn,X_train_scaled,y_train,cv=5)
imprimer(CV)
imprimer(cv.moyen())
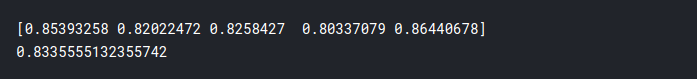
3) Classificateur de vecteur de support
svc = SVC(probabilité = vrai)
cv = cross_val_score(svc,X_train_scaled,y_train,cv=5)
imprimer(CV)
imprimer(cv.moyen())
Pourtant, la précision des modèles est:
- Régression logistique: 82,2%
- K Voisin le plus proche: 81,4%
- SVC: 83,3%
Comme tu peux le voir, nous obtenons une précision décente avec tous nos modèles, mais le meilleur c'est SVC. Et prêt, voici comment vous avez terminé votre premier projet de science des données! Bien que beaucoup plus puisse être fait pour obtenir de meilleurs résultats, c'est plus que suffisant pour vous aider à démarrer et voir comment vous pensez comme un data scientist. j'espère que ce tuto t'aura aidé, J'ai passé un bon moment à faire le projet moi-même et j'espère que vous l'apprécierez aussi. Santé!!





