
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
est utilisé pour prédire les valeurs futures sur la base des valeurs précédemment observées et l'un des meilleurs outils pour l'analyse des tendances et la prévision future.
Qu'est-ce que les données de séries chronologiques?
Il est enregistré à intervalles de temps réguliers et l'ordre de ces points de données est important. Pourtant, tout modèle prédictif basé sur des données de séries temporelles aura le temps comme variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... Indépendant. La sortie d'un modèle serait la valeur ou le rang prédit à un moment donné.
Analyse de séries chronologiques vs prévisions de séries chronologiques
Parlons d'une confusion possible sur l'analyse et la prévision des séries chronologiques. La prévision de séries chronologiques est un exemple de modélisation prédictive, tandis que l'analyse des séries chronologiques est une forme de modélisation descriptive.
Pour un nouvel investisseur, la recherche générale associée à la bourse ou à la bourse ne suffit pas pour prendre la décision. La tendance commune vers le marché boursier au sein de la société est très risquée pour l'investissement, donc la plupart des gens ne peuvent pas prendre de décisions basées sur des tendances communes. La variation saisonnière et le flux constant de tout indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... aideront les investisseurs nouveaux et existants à comprendre et à prendre la décision d'investir sur le marché boursier.
Pour résoudre ce genre de problèmes, la prévision de séries temporelles est la meilleure technique.
Bourse
Les marchés boursiers sont les lieux où les investisseurs individuels et institutionnels se réunissent pour acheter et vendre des actions dans un lieu public.. Aujourd'hui, ces bourses existent en tant que places de marché électroniques.
Cette offre et cette demande aident à déterminer le prix de chaque titre ou les niveaux auxquels les participants au marché boursier (investisseurs et commerçants) sont prêts à acheter ou à vendre.
Le concept derrière le fonctionnement de la bourse est assez simple.. Fonctionnant un peu comme une maison de vente aux enchères, la bourse permet aux acheteurs et aux vendeurs de négocier les prix et d'effectuer des transactions.
Définition de ‘action’
Une action ou une action (aussi connu sous le nom « Capitale » d'une entreprise) est un instrument financier qui représente la propriété d'une entreprise
Apprentissage automatique en bourse
La bourse est très imprévisible, tout changement géopolitique peut affecter la tendance des actions en bourse, nous avons récemment vu comment le covid-19 a eu un impact sur les cours des actions, donc dans les données financières, il est très difficile de faire une analyse de tendance fiable. . La façon la plus efficace de résoudre ce type de problèmes est avec l'aide de l'apprentissage automatique et le l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé....
Dans ce tutoriel, nous allons résoudre ce problème avec le modèle ARIMA.
Pour connaître la saisonnalité, regarde mon blog précédent. Et pour avoir une compréhension de base d'ARIMA, je te conseille de lire ce blog, cela vous aidera à mieux comprendre comment fonctionne l'analyse des séries chronologiques.
Mettre en œuvre la prévision du cours de l'action
j'utiliserai nsepy bibliothèque pour extraire les données historiques du SBIN.
Importations
importer le système d'exploitation
avertissements d'importation
warnings.filterwarnings('ignore')
à partir de pylab importer rcParams
rcParams['figure.figsize'] = 10, 6
de statsmodels.tsa.stattools import adfuller
de statsmodels.tsa.seasonal import season_decompose
de statsmodels.tsa.arima_model importer ARIMA
depuis pmdarima.arima importer auto_arima
à partir de sklearn.metrics importer Mean_squared_error, moyenne_erreur_absolue
importer des mathématiques
importer numpy en tant que np
depuis nsepy importer get_history
à partir de datetime date d'importation
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
importer des pandas au format pd
Exécutez le code ci-dessous pour extraire les données historiques:
sbin = get_history(symbole ="SBIN",
                   début=date(2000,1,1),
                   fin=date(2020,11,1))
sbin.head()
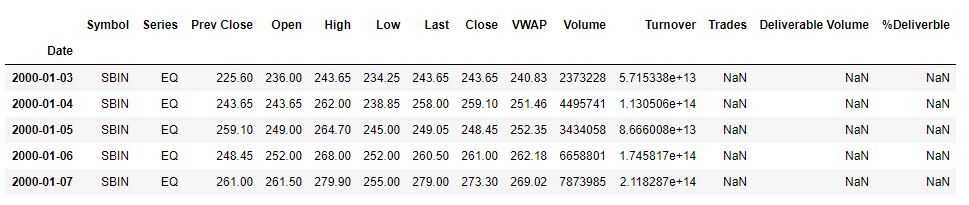
Les données montrent le cours de l'action SBIN de 2020-1-1 à 2020-11-1. L'objectif est de créer un modèle qui prévoira
le cours de clôture de l'action.
Créons une visualisation qui montrera le cours de clôture quotidien de l'action.
plt.figure(taille de la figue=(10,6))
plt.grid(Vrai)
plt.xlabel('Dates')
plt.ylabel('Prix de clôture')
plt.plot(sbin['Clôture'])
plt.titre('Prix de clôture de SBIN')
plt.show()
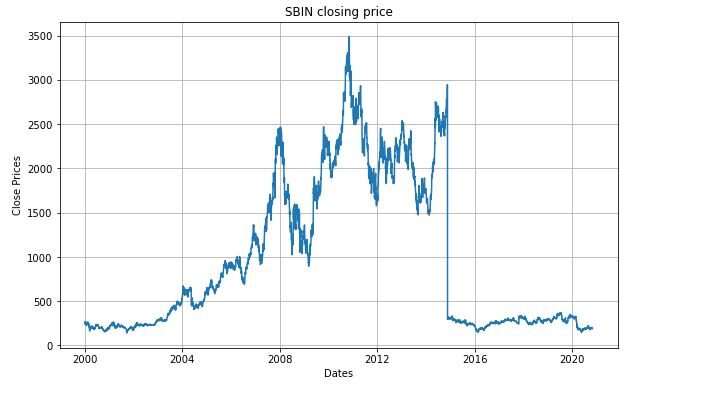
plt.figure(taille de la figue=(10,6))
df_close = sbin['Clôture']
df_close.plot(style="k.")
plt.titre('Nuage de pointsUn diagramme de dispersion est une représentation graphique qui montre la relation entre deux variables. Chaque point sur le graphique correspond à une paire de valeurs, ce qui permet d'identifier des modèles, tendances ou corrélations. Cet outil est utile dans diverses disciplines, comme la statistique et la recherche scientifique, puisqu'il facilite l'analyse visuelle des données et la compréhension de la relation entre les éléments étudiés.... du prix de clôture)
plt.show()
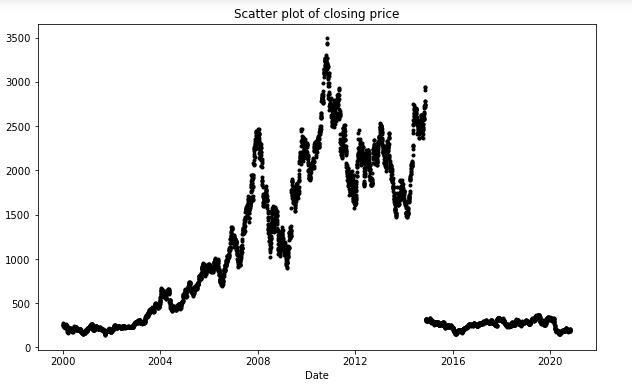
plt.figure(taille de la figue=(10,6))
df_close = sbin['Clôture']
df_close.plot(style="k.",kind='hist')
plt.titre('Histogramme du prix de clôture')
plt.show()
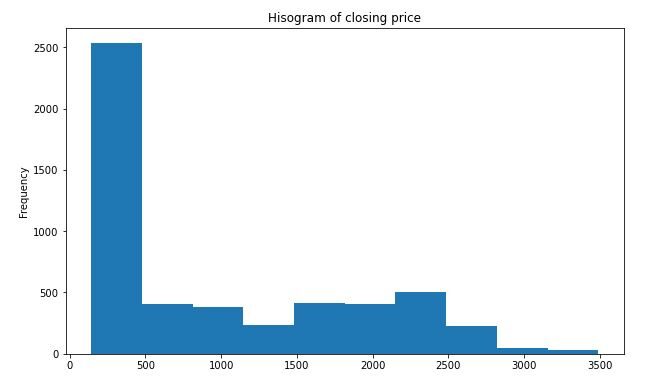
Premier, nous devons vérifier si une série est stationnaire ou non car l'analyse des séries chronologiques ne fonctionne qu'avec des données stationnaires.
Test de stationnarité:
Pour identifier la nature des données, nous utiliserons le hypothèse nulleL’hypothèse nulle est un concept fondamental en statistique qui établit une déclaration initiale sur un paramètre de population. Son but est d’être testé et, s’il est réfuté, nous permet d’accepter l’hypothèse alternative. Cette approche est essentielle dans la recherche scientifique, car il fournit un cadre pour évaluer les preuves empiriques et prendre des décisions fondées sur des données. Sa formulation et son analyse sont cruciales dans les études statistiques.....
H0: L'hypothèse nulle: Il s'agit d'une déclaration sur la population qui est considérée comme vraie ou utilisée pour argumenter, à moins qu'il ne puisse être démontré qu'elle est incorrecte au-delà de tout doute raisonnable..
H1: L'hypothèse alternative: C'est une déclaration sur la population qui contredit H0 et ce que nous concluons lorsque nous rejetons H0.
#Ho: il n'est pas immobile
# H1: est arrêté
Si on ne rejette pas l'hypothèse nulle, on peut dire que la série est non stationnaire. Cela signifie que la série peut être linéaire.
Si l'écart type et la moyenne sont tous deux des lignes plates (moyenne constante et variance constante), la série devient stationnaire.
de statsmodels.tsa.stattools import adfuller
def test_stationnarité(des séries chronologiques):
    #Détermination des statistiques glissantes
    rolmean = timeseries.rolling(12).moyenne()
    rolstd = timeseries.rolling(12).std()
    #Tracer des statistiques glissantes:
    plt.plot(des séries chronologiques, couleur="jaune",étiquette="Original")
    plt.plot(rolmoyen, couleur="rouge", étiquette="Moyenne glissante")
    plt.plot(rolstd, couleur="le noir", étiquette="Roulement standard")
    plt.légende(loc ="meilleur")
    plt.titre('Moyenne mobile et écart-type')
    plt.show(bloc=Faux)
    imprimer("Résultats du test de Dickey Fuller")
    adft = adfuller(des séries chronologiques,autolag='AIC')
    # la sortie pour dft nous donnera sans définir quelles sont les valeurs.
    #par conséquent, nous écrivons manuellement quelles valeurs cela explique-t-il en utilisant une boucle for
    sortie = pd.Série(adft[0:4],indice=['Statistiques du test','p-value','Non. des retards utilisés','Nombre d'observations utilisées'])
    pour clé,valeurs dans adft[4].éléments():
        sortir['valeur critique (%s)'%key] = valeurs
    imprimer(sortir)

test_stationnarité(sbin['Clôture'])
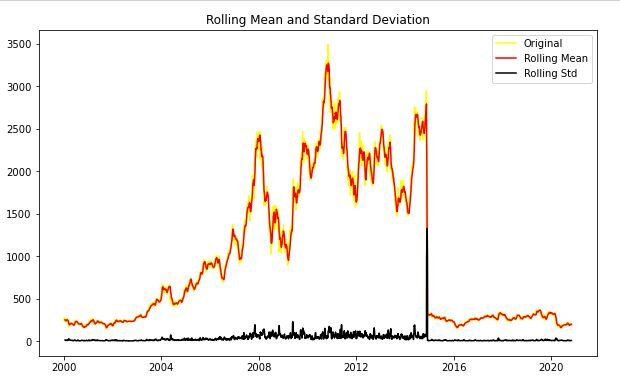
Après avoir analysé le graphique ci-dessus, nous pouvons voir la moyenne et l'écart type croissants et donc notre série n'est pas stationnaire.
Résultats du test de Dickey Fuller
Statistiques de test                  -1.914523
valeur p                           0.325260
Non. des décalages utilisés                  3.000000
Nombre d'observations utilisées    5183.000000
valeur critique (1%)              -3.431612
valeur critique (5%)              -2.862098
valeur critique (10%)             -2.567067
dtype: float64
On voit que la p-value est supérieure à 0.05 nous ne pouvons donc pas rejeter le Hypothèse nulle. En outre, les statistiques de test sont supérieures aux valeurs critiques. donc les données ne sont pas stationnaires.
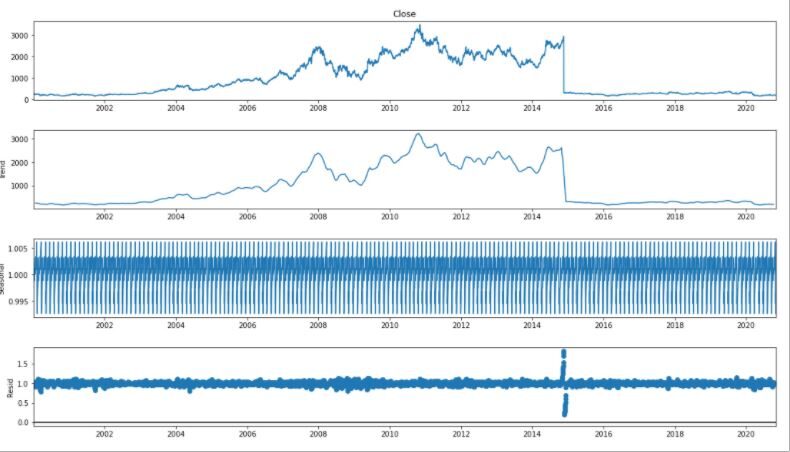
Pour l'analyse des séries chronologiques, Nous séparons la tendance et la saisonnalité des séries chronologiques.
result = saisonnier_decompose(df_close, modèle="multiplicatif", fréq = 30)
fig = plt.figure()
fig = result.plot()
fig.set_size_inches(16, 9)
à partir de pylab importer rcParams
rcParams['figure.figsize'] = 10, 6
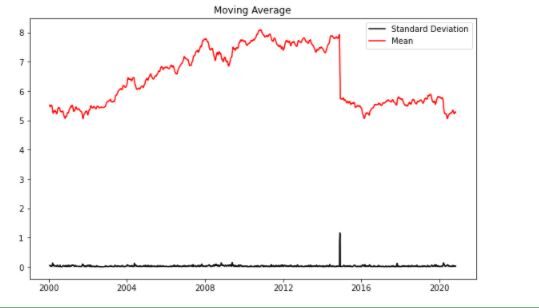
df_log = np.log(sbin['Clôture'])
Moving_avg = df_log.rolling(12).moyenne()
std_dev = df_log.rolling(12).std()
plt.légende(loc ="meilleur")
plt.titre('Moyenne mobile')
plt.plot(std_dev, couleur ="le noir", étiquette = "Écart-type")
plt.plot(move_avg, couleur="rouge", étiquette = "Moyenne")
plt.légende()
plt.show()
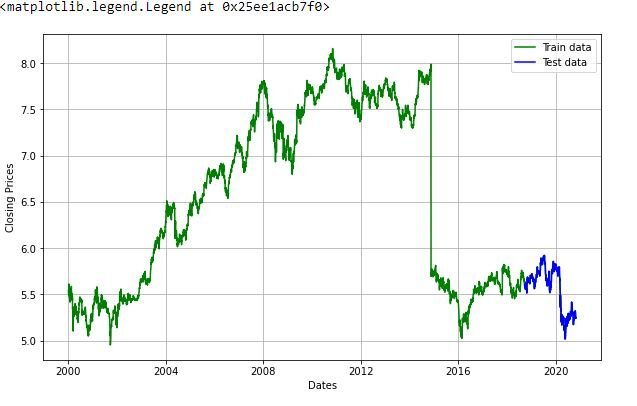
Nous allons maintenant créer un modèle ARIMA et l'entraîner avec le cours de clôture de l'action dans les données du train. Alors divisons les données en entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... et jeu de test et visualisons-les.
train_données, test_data = df_log[3:entier(longueur(df_log)*0.9)], df_log[entier(longueur(df_log)*0.9):]
plt.figure(taille de la figue=(10,6))
plt.grid(Vrai)
plt.xlabel('Dates')
plt.ylabel('Prix de clôture')
plt.plot(df_log, 'vert', étiquette="Données de train")
plt.plot(données de test, 'bleu', étiquette="Données de test")
plt.légende()
model_autoARIMA = auto_arima(train_données, start_p=0, start_q=0,
essai ="adf",       # utiliser adftest pour trouver 'd' optimal
max_p=3, max_q=3, # maximum p et q
m=1,              # fréquence des séries
d=Aucun,           # let model determine 'd'
saisonnier=Faux,   # Pas de saisonnalité
start_P=0,
D=0,
trace=Vrai,
error_action='ignore',
suppress_warnings=Vrai,
pas à pas=Vrai)
imprimer(model_autoARIMA.summary())
Effectuer une recherche pas à pas pour minimiser l'aic
 ARIMA(0,1,0)(0,0,0)[0] intercepter   : AIC=-16607.561, Temps = 2,19 s
 ARIMA(1,1,0)(0,0,0)[0] intercepter   : AIC=-16607.961, Temps = 0,95 s
 ARIMA(0,1,1)(0,0,0)[0] intercepter   : AIC=-16608.035, Temps = 2,27 s
 ARIMA(0,1,0)(0,0,0)[0]             : AIC=-16609.560, Temps=0.39 s
 ARIMA(1,1,1)(0,0,0)[0] intercepter   : AIC=-16606.477, Temps = 2,77 s

Meilleur modèle:  ARIMA(0,1,0)(0,0,0)[0]
Temps d'ajustement total: 9.079 secondes
                               Résultats SARIMAX
================================================== ============================
Dép. Variable:                      et non. Observations:                 4665
Modèle:               SARIMAX(0, 1, 0)   Log probabilité                8305.780
Date:                Mar, 24 nov 2020   AIC                         -16609.560
Temps:                        20:08:50   BIC                         -16603.113
Échantillon:                             0   HQIC                        -16607.293
                               - 4665
Type de covariance:                  opg
================================================== ============================
                 coef std err z P>|Avec|      [0.025      0.975]
------------------------------------------------------------------------------
sigma2         0.0017   1.06e-06   1566.660      0.000       0.002       0.002
=================================================== ==============================
Ljung-Box (Q):                       24.41   Jarque-Béra (JB):         859838819.58
Problème(Q):                              0.98   Problème(JB):                         0.00
Hétéroscédasticité (H):               7.16   Fausser:                           -37.54
Problème(H) (recto-verso):                  0.00   Aplatissement:                      2105.12
================================================== ==================================
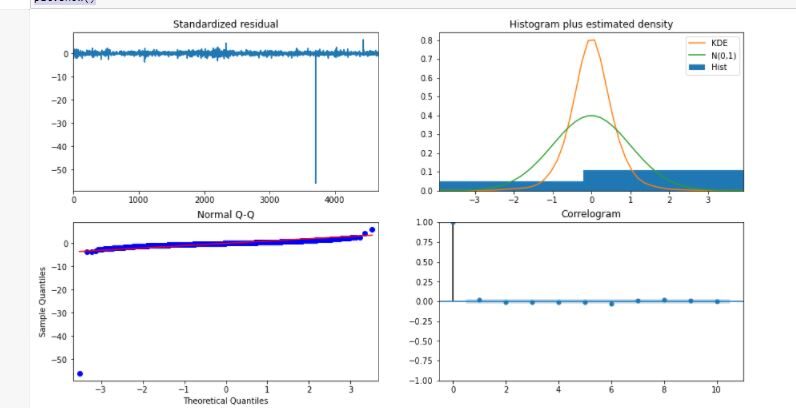
model_autoARIMA.plot_diagnostics(taille de la figue=(15,8))
plt.show()
modèle = ARIMA(train_données, commande=(3, 1, 2))
ajusté = model.fit(affichage = -1)
imprimer(équipé.résumé())
                             Résultats du modèle ARIMA
================================================== ============================
Dép. Variable:                D.Fermer Non. Observations:                 4664
Modèle:                 ARIMA(3, 1, 2)   Log probabilité                8309.178
Méthode:                       css-ml S.D.. des nouveautés              0.041
Date:                Mar, 24 nov 2020   AIC                         -16604.355
Temps:                        20:09:37   BIC                         -16559.222
Échantillon:                             1   HQIC                        -16588.481

================================================== ===============================
                    coef std err z P>|Avec|      [0.025      0.975]
---------------------------------------------------------------------------------
const 8.761e-06      0.001      0.015      0.988      -0.001       0.001
ar.L1.D.Fermer     1.3689      0.251      5.460      0.000       0.877       1.860
ar.L2.D.Fermer    -0.7118      0.277     -2.567      0.010      -1.255      -0.168
ar.L3.D.Fermer     0.0094      0.021      0.445      0.657      -0.032       0.051
ma.L1.D.Fermer    -1.3468      0.250     -5.382      0.000      -1.837      -0.856
ma.L2.D.Fermer     0.6738      0.282      2.391      0.017       0.122       1.226
                                    Racines
================================================== ===========================
                  Fréquence du module imaginaire réel
-----------------------------------------------------------------------------
AR.1            0.9772           -0.6979j            1.2008           -0.0987
AR.2            0.9772           +0.6979j            1.2008            0.0987
AR.3           74.0622           -0.0000j           74.0622           -0.0000
MA.1            0.9994           -0.6966j            1.2183           -0.0969
MA.2            0.9994           +0.6966j            1.2183            0.0969
-----------------------------------------------------------------------------
# Prévision

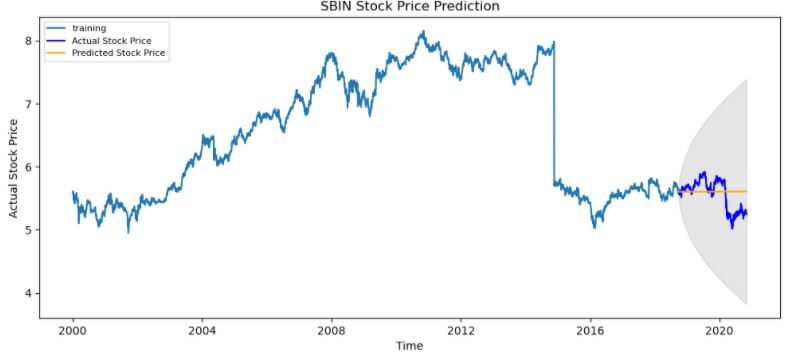
fc, je connais, conf = fit.forecast(519, alpha=0,05)  # 95% confiance
fc_series = pd.Series(fc, index=test_data.index)
série_inférieure = pd.Série(conf[:, 0], index=test_data.index)
upper_series = pd.Series(conf[:, 1], index=test_data.index)
plt.figure(taille de la figue=(12,5), ppp=100)
plt.plot(train_données, étiquette="entraînement")
plt.plot(données de test, couleur="bleu", étiquette="Cours réel de l'action")
plt.plot(fc_series, couleur="Orange",étiquette="Cours de l'action prévu")
plt.fill_entre(série_inférieure.index, série_inférieure, série_supérieure,
                 couleur="k", alpha=.10)
plt.titre('SBIN Stock Price Prediction')
plt.xlabel('Time')
plt.ylabel('Actual Stock Price')
plt.légende(loc ="en haut à gauche", taille de police=8)
plt.show()
conclusion
La prévision des séries chronologiques est vraiment utile lorsque nous devons prendre des décisions futures ou que nous devons faire des analyses, nous pouvons le faire rapidement en utilisant ARIMA, il existe de nombreux autres modèles à partir desquels nous pouvons faire des prévisions de séries chronologiques, mais ARIMA est vraiment facile à comprendre.
J'espère que cet article vous aidera et vous fera gagner du temps. Laissez-moi savoir si vous avez des suggestions..
CODAGE HEUREUX.
Prabhat Pathak (Profil LinkedIn) est un analyste senior et un passionné d'innovation.





