
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction:
La technologie. Cet ensemble de données se compose de chiffres manuscrits du 0 Al 9 et fournit une chaussée pour tester les systèmes de traitement d'images. Ceci est considéré comme le ‘programme bonjour le monde en apprentissage automatique’ que involucra Deep Learning.
Les étapes impliquées sont:
- Importer un jeu de données
- Diviser l'ensemble de données en test et entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines....
- Construction du modèle
- Former le modèle
- Prédire la précision
1) Importation d'ensemble de données:
Pour continuer avec le code, nous avons besoin de l'ensemble de données. Ensuite, nous considérons diverses sources comme des ensembles de données, FIA, kaggler, etc. Mais puisque nous utilisons Python avec ses vastes modules intégrés, a les données MNIST dans le module keras.datasets. Donc, nous n'avons pas besoin de télécharger et de stocker les données en externe.
de keras.datsets importer mnist
données = mnist.load_data()
Donc, du module keras.datasets nous importons la fonction mnist qui contient l'ensemble de données.
Alors, l'ensemble de données est stocké dans les données variables à l'aide de la fonction mnist.load_data () qui charge l'ensemble de données dans des données variables.
Ensuite, voyons le type de données que nous trouvons quelque chose d'inhabituel car il est du type tuple. Nous savons que l'ensemble de données mnist contient des images de chiffres manuscrits, stocké sous forme de tuples.
Les données
taper(Les données)
2) Divisez l'ensemble de données en train et test:
Nous divisons directement l'ensemble de données en train et test. Ensuite, pour ça, on initialise quatre variables X_train, y_train, X_test, y_test pour endommager le train et tester les données pour les valeurs dépendantes et indépendantes respectivement.
(X_train, y_train), (X_test, y_test) = données
X_train[0].forme
X_train.shape
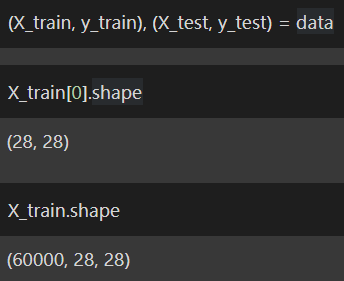
En imprimant la forme de chaque image, nous pouvons constater qu'elle a une taille de 28 × 28. Ce qui signifie que l'image a 28 pixels x 28 pixels.
À présent, nous devons remodeler de telle manière que nous puissions accéder à chaque pixel de l'image. La raison pour accéder à chaque pixel est que c'est seulement ainsi que nous pouvons appliquer des idées de l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... et nous pouvons attribuer un code couleur à chaque pixel. Ensuite, nous stockons le tableau remodelé dans X_train, X_test respectivement.
X_train = X_train.remodeler((X_train.shape[0], 28*28)).astype('float32')
X_test = X_test.reshape((X_test.shape[0], 28*28)).astype('float32')
Nous connaissons le code couleur RVB où différentes valeurs produisent différentes couleurs. Il est également difficile de se souvenir de toutes les combinaisons de couleurs. Ensuite, se référer à cela Relier pour avoir une brève idée des codes couleurs RVB.
Nous savons déjà que chaque pixel a son code couleur unique et nous savons aussi qu'il a une valeur maximale de 255. Pour réaliser l'apprentissage automatique, il est important de convertir toutes les valeurs de 0 une 255 pour chaque pixel à une plage de valeurs de 0 une 1. Le moyen le plus simple est de diviser la valeur de chaque pixel par 255 pour obtenir les valeurs dans la plage de 0 une 1.
X_train = X_train / 255
X_test = X_test / 255
Nous avons maintenant fini de diviser les données en test et en entraînement, ainsi que la préparation des données pour une utilisation ultérieure. Donc, maintenant nous pouvons passer au col 3: Construction de maquettes.
3) Former le modèle:
Pour effectuer la construction de modèles, nous devons importer les fonctions requises, c'est-à-dire, séquentiel et dense pour exécuter un apprentissage en profondeur, qui est disponible dans la bibliothèque Keras.
Mais ce n'est pas directement disponible, par conséquent, nous devons comprendre ce simple graphique linéaireLe graphique linéaire est un outil visuel utilisé pour représenter les données au fil du temps. Il se compose d’une série de points reliés par des droites, qui vous permet d’observer les tendances, Fluctuations et modèles dans les données. Ce type de graphique est particulièrement utile dans des domaines tels que l’économie, Météorologie et recherche scientifique, ce qui facilite la comparaison de différents ensembles de données et l’identification des comportements à tous les niveaux..:
1) Dur -> Des modèles -> Séquentiel
2) Dur -> Couvertures -> Denso
Voyons comment nous pouvons importer les fonctions avec la même logique qu'un code Python.
à partir de keras.models Importation séquentielle
de keras.layers importer Dense
modèle = Séquentiel()
model.ajouter(Dense(32, input_dim = 28 * 28, activation= 'relu'))
model.ajouter(Dense(64, activation = 'relu'))
model.ajouter(Dense(10, activation = 'softmax'))
Ensuite, nous stockons la fonction dans le modèle de variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes...., car cela facilite l'accès à la fonction à chaque fois au lieu de taper la fonction à chaque fois, nous pouvons utiliser la variable et appeler la fonction.
Alors, convertir l'image en un groupe dense de couches et empiler chaque couche l'une sur l'autre et nous utilisons ‘reprendre’ comme notre fonction de réveilLa fonction d’activation est un composant clé des réseaux de neurones, puisqu’il détermine la sortie d’un neurone en fonction de son entrée. Son objectif principal est d’introduire des non-linéarités dans le modèle, vous permettant d’apprendre des modèles complexes dans les données. Il existe différentes fonctions d’activation, comme le sigmoïde, ReLU et tanh, chacun avec des caractéristiques particulières qui affectent les performances du modèle dans différentes applications..... L'explication de ‘reprendre’ dépasse le cadre de ce blog. Pour obtenir plus d'informations à ce sujet, vous pouvez consulter ce.
D'autre part, nous empilons quelques couches supplémentaires avec ‘softmax’ comme fonction d'activation. Pour en savoir plus sur la fonction ‘softmax’, vous pouvez vous référer à cet article, car cela dépasse à nouveau le cadre de ce blog, puisque mon objectif principal est d'être aussi précis que possible avec l'ensemble de données MNIST.
Alors, enfin, nous compilons le modèle complet et utilisons entropie croisée comme notre Fonction de perteLa fonction de perte est un outil fondamental de l’apprentissage automatique qui quantifie l’écart entre les prédictions du modèle et les valeurs réelles. Son but est de guider le processus de formation en minimisant cette différence, permettant ainsi au modèle d’apprendre plus efficacement. Il existe différents types de fonctions de perte, tels que l’erreur quadratique moyenne et l’entropie croisée, chacun adapté à différentes tâches et..., pour optimiser l'utilisation de notre modèle Adam comme optimiseur et nous utilisons la précision comme métrique pour évaluer notre modèle.
Pour un aperçu de notre modèle, nous utilisons ‘modèle.résumé ()’, qui fournit de brefs détails sur notre modèle.
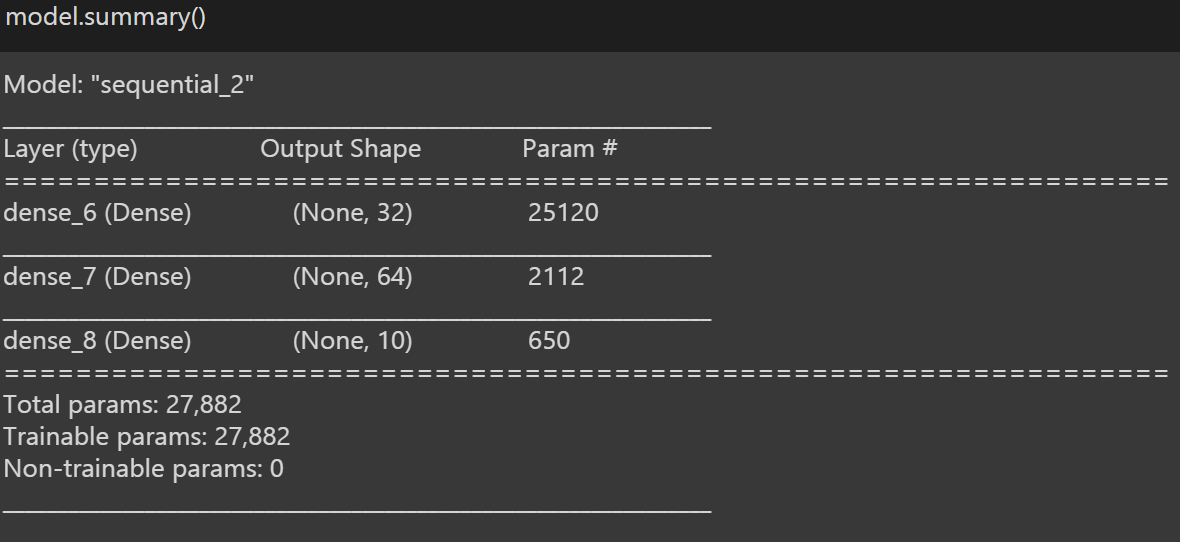
Maintenant nous pouvons passer au Pass 4: Former le modèle.
4) Former le modèle:
C'est l'avant-dernière étape dans laquelle nous allons entraîner le modèle avec une seule ligne de code. Ensuite, pour ça, nous utilisons la fonction .fit () qui prend en entrée l'ensemble des trains de la variable dépendante et de la variable indépendante et dépendante, et définir les époques = 10, et définissez batch_size comme 100.
Coffret => X_train; y_train
Époques => Une époque signifie entraîner le neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. avec toutes les données d'entraînement pour un cycle. Une époque est composée d'un ou plusieurs lots, où nous utilisons une partie de l'ensemble de données pour entraîner le réseau de neurones. Ce qui signifie que nous envoyons le modèle pour former 10 fois pour obtenir une haute précision. Vous pouvez également modifier le nombre d'époques en fonction des performances du modèle.
La taille du lot => La taille du lot est un terme utilisé dans l'apprentissage automatique et fait référence au nombre d'exemples de formation utilisés dans une itération. Ensuite, essentiellement, nous envoyons 100 images à former en tant que lot par itération.
Voyons la partie codage.
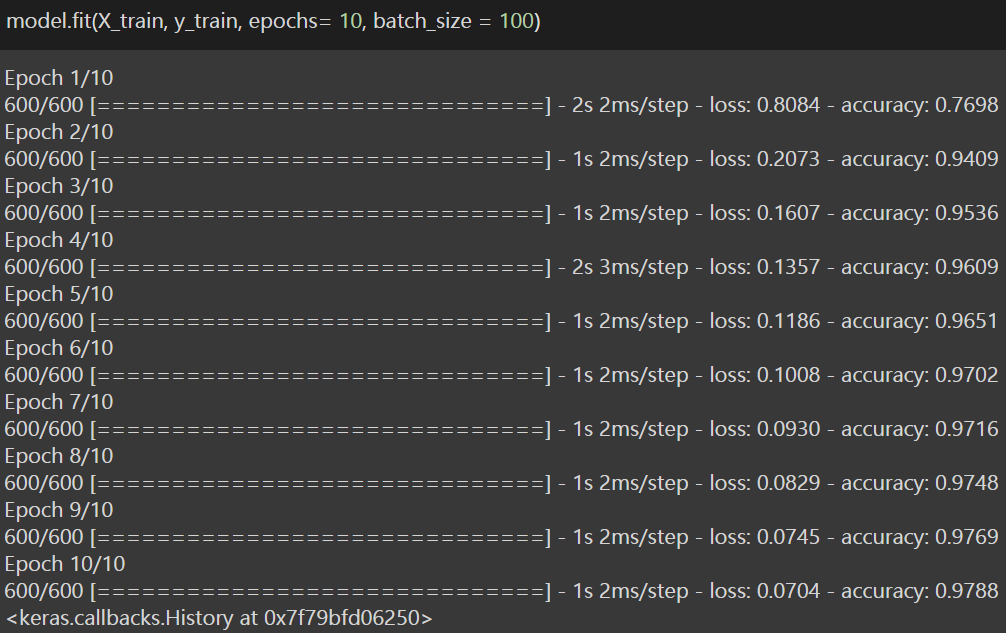
Donc, après avoir formé le modèle, nous avons atteint une précision de 97,88% pour l'ensemble de données d'entraînement. Il est maintenant temps de voir comment le modèle fonctionne dans l'ensemble de test et de voir si nous avons atteint la précision requise. Donc, maintenant nous allons à la dernière étape ou étape 5: Prédire la précision.
5) Précision des prédictions:
Ensuite, pour savoir dans quelle mesure le modèle fonctionne sur l'ensemble de données de test, J'utilise la variable scores pour stocker la valeur et utiliser la fonction .evaluate () qui prend l'ensemble de test des variables dépendantes et indépendantes en entrée. Ceci calcule la perte et la précision du modèle dans l'ensemble de test. Comment nous nous concentrons sur la précision, nous n'imprimons que la précision.
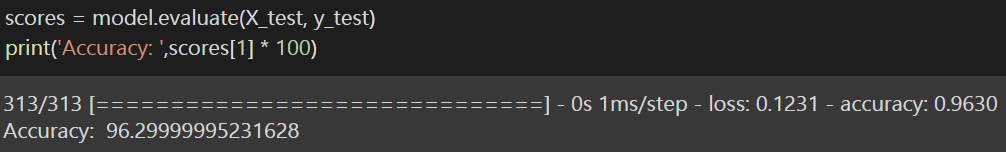
Finalement, nous avons atteint le résultat et garantissons une précision de plus de 96% dans l'ensemble de test ce qui est très appréciable, et le motif du blog est atteint. j'ai écrit le lien vers ordinateur portable pour votre référence (lecteurs).
S'il vous plait, n'hésitez pas à me contacter via Linkedin aussi bien que. Et merci d'avoir lu le blog.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





