
Cet article a été publié dans le cadre de la Blogathon sur la science des données
introduction
En statistiques appliquées et en apprentissage automatique, Visualisation de données est l'une des compétences les plus importantes.
La visualisation des données fournit un ensemble important d'outils pour identifier une compréhension qualitative. Cela peut être utile lorsque nous essayons d'explorer l'ensemble de données et d'extraire des informations pour connaître un ensemble de données et peut aider avec identification de modèle, données corrompues, Valeurs atypiques, beaucoup plus.
Si nous avons une petite connaissance du domaine, les visualisations de données peuvent être utilisées pour exprimer et identifier des relations clés dans des tableaux et des graphiques qui sont plus utiles pour vous et vos parties prenantes que les mesures d'association ou de pertinence.
Dans ce billet, nous discuterons de certains des graphiques de base O versements que vous pouvez utiliser pour mieux comprendre et visualiser vos données.
Table des matières
1. Qu'est-ce que la visualisation des données?
2. Avantages d'une bonne visualisation des données
3. Différents types d'analyse pour la visualisation des données
4. Techniques d'analyse univariée pour la visualisation des données
- Diagramme de distribution
- Parcelle à moustaches
- Cadre de violon
5. Techniques d'analyse bivariée pour la visualisation des données
- Graphique linéaire
- Graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité....
- Nuage de pointsUn nuage de points est une représentation visuelle qui montre la relation entre deux variables numériques à l’aide de points sur un plan cartésien. Chaque axe représente une variable, et l’emplacement de chaque point indique sa valeur par rapport aux deux. Ce type de graphique est utile pour identifier des modèles, Corrélations et tendances dans les données, faciliter l’analyse et l’interprétation des relations quantitatives....
Qu'est-ce que la visualisation des données?
L'affichage des données est défini comme représentation graphique contenant le information et le Les données.
Utiliser des éléments visuels comme graphique, graphique, Oui Plans, les techniques de visualisation des données offrent un moyen réalisable de visualiser et comprendre les tendances, valeurs aberrantes et modèles dans les données.
Actuellement, nous avons beaucoup de données entre nos mains, En d'autres termes, dans le monde de Big Data, les outils et technologies de visualisation des données sont essentiels pour analyser des quantités massives d'informations et prendre des décisions éclairées par les données.
Il est utilisé dans de nombreux domaines tels que:
- Modeler événements complexes.
- Visualiser des phénomènes qui ne peuvent pas être observés directement, Quoi conditions météorologiques, les conditions médicales, O relations mathématiques.
Avantages d'une bonne visualisation des données
Puisque nos yeux peuvent capturer les couleurs et les motifs, pour cela, on peut rapidement identifier la partie rouge du bleu, le carré du cercle, notre culture est visuelle, qui comprend tout, de l'art et des publicités à la télévision et aux films.
Ensuite, La visualisation des données est une autre technique d'art visuel qui capte notre intérêt et maintient notre concentration sur le message capturé à l'aide des yeux..
Chaque fois que nous visualisons un graphique, nous identifions rapidement les tendances et les valeurs aberrantes présentes dans l'ensemble de données.
Les utilisations de base de la technique de visualisation des données sont les suivantes:
- C'est une technique puissante pour explorer les données avec présentable Oui interprétable résultats.
- Dans le procédure d'exploration de données, agit comme une étape principale dans la partie de prétraitement.
- C'est compatible avec procédure de nettoyage des données trouver des données incorrectes et des valeurs manquantes ou corrompues.
- Cela aide aussi construire et choisir des variables, ce qui signifie que nous devons déterminer quoi variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... inclure et exclure dans l'analyse.
- Dans la procédure de Baisse des données, il joue également un rôle crucial dans la combinaison des catégories.
Source de l'image: Google images
Différents types d'analyse pour la visualisation des données
Principalement, il existe trois types d'analyse différents pour la visualisation des données:
Analyse univariée: En analyse univariée, nous utiliserons une seule fonctionnalité pour analyser presque toutes ses propriétés.
Analyse bivariée: Lorsque nous comparons les données entre exactement 2 fonctionnalités, connue sous le nom d'analyse bivariée.
Analyse multivariable: En analyse multivariée, Volonté comparer plus que 2 variables.
REMARQUE:
Dans ce billet, notre objectif principal est de comprendre les concepts suivants:
- Comment trouver des inférences à partir des techniques de visualisation de données?
- Dans quel état, quelle technique est plus utile que d'autres?
Nous n'allons pas approfondir la partie codage / mise en œuvre de différentes techniques dans un ensemble de données particulier, mais nous essayons de trouver la solution aux questions précédentes et de comprendre uniquement le code de l'extrait à l'aide d'exemples de diagrammes pour chacune des techniques de visualisation de données. .
À présent, commençons par les différentes techniques de visualisation de données:
Techniques d'analyse univariée pour la visualisation des données
1. Diagramme de distribution
- C'est l'un des meilleurs graphiques univariés pour connaître la distribution des données.
- Quand on veut analyser l'impact sur la variable cible (Sortir) par rapport à une variable indépendante (entrée), nous utilisons beaucoup les graphiques de distribution.
- Ce graphique nous donne une combinaison de fonctions de densité de probabilité (pdf) et histogramme sur un seul graphique.
Mise en œuvre:
- Le graphe de répartition est présent dans le Seaborn emballer.
L'extrait de code est le suivant:
sns.FacetGrid(hb,teinte ="SurvStat",taille=5).carte(sns.distplot,'age').ajouter_légende()
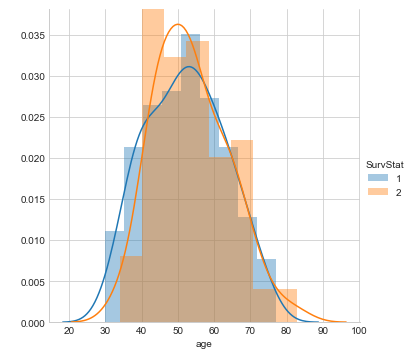
Quelques conclusions déduites du schéma de répartition ci-dessus:
À partir du graphique de distribution précédent, nous pouvons conclure les observations suivantes:
- Nous avons observé que nous créons un diagramme de distribution sur la caractéristique ‘L'âge’(variable d'entrée) et nous utilisons différentes couleurs pour le État de survie(variable de sortie) puisque c'est la classe de prédire.
- Il y a une grande zone de chevauchement entre les PDF pour différentes combinaisons.
- Dans ce graphique, les structures pointues en forme de bloc sont appelées histogrammesLes histogrammes sont des représentations graphiques qui montrent la distribution d’un ensemble de données. Ils sont construits en divisant la plage de valeurs en intervalles, O "Bacs", et compter la quantité de données tombées dans chaque intervalle. Cette visualisation vous permet d’identifier des modèles, Tendances et variabilité des données, faciliter l’analyse statistique et la prise de décision éclairée dans diverses disciplines.... et la courbe lissée est connue sous le nom de fonction de densité de probabilité (PDF).
REMARQUE:
La fonction de densité de probabilité (PDF) d'une courbe peut nous aider à saisir la distribution sous-jacente de cette caractéristique, qui est l'un des principaux points à retenir de la visualisation des données ou de l'analyse exploratoire des données (AED).
2. Parcelle à moustaches
- Ce tableau peut être utilisé pour obtenir plus détails statistiques sur les données.
- Les lignes au maximum et au minimum sont aussi appelées moustaches.
- Les points en dehors des moustaches seront considérés comme une valeur aberrante.
- La boîte à moustaches nous donne également une description de la quartile 25, 50, 75.
- A l'aide d'un box plot, on peut aussi déterminer la Gamme interquartile (IQR) où le maximum de détails des données seront présents. Pour cela, en outre, cela peut nous donner une idée claire des valeurs aberrantes dans l'ensemble de données.
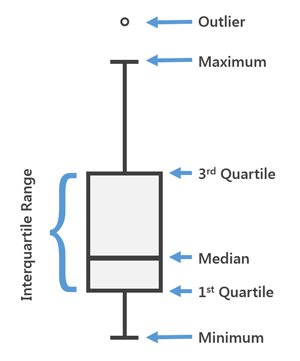
Figure. Diagramme général pour une boîte à moustaches
Mise en œuvre:
- Boxplot est activé sur Seaborn Une bibliothèque.
- Ici x est considéré comme la variable dépendante et y est considéré comme la variable indépendante. Ces boîtes à moustachesDiagrammes encadrés, Aussi connu sous le nom de diagrammes en boîte et à moustaches, sont des outils statistiques qui représentent la distribution d’un ensemble de données. Ces diagrammes montrent la médiane, quartiles et valeurs aberrantes, Permettre de visualiser la variabilité et la symétrie des données. Ils sont utiles pour la comparaison entre différents groupes et pour l’analyse exploratoire, faciliter l’identification des tendances et des modèles dans les données.... viennent en dessous analyse univariée, ce qui signifie que nous explorons des données avec une seule variable.
- Ici, nous essayons de vérifier l'impact d'une fonctionnalité appelée « Axil_nodes » dans la classe nommée « État de survie » et non entre deux caractéristiques indépendantes.
L'extrait de code est le suivant:
sns.boxplot(x='SurvStat',y='axil_nodes',données=hb)
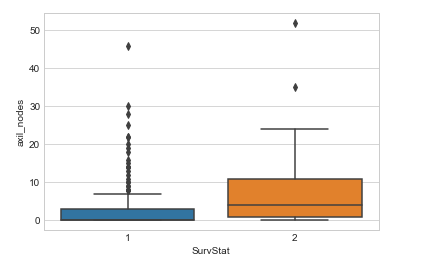
Quelques conclusions déduites de la boîte à moustaches ci-dessus:
À partir du diagramme en boîte et en moustache ci-dessus, nous pouvons conclure les observations suivantes:
- Combien de données sont présentes dans le premier quartile et combien de points sont des valeurs aberrantes, etc.
- Pour la classe 1, nous pouvons voir qu'il y a très peu ou pas de données présentes entre le médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes.... et le premier quartile.
- Il y a plus de valeurs aberrantes pour la classe 1 dans la fonction nommée axil_nodes.
REMARQUE:
Nous pouvons obtenir des détails sur les valeurs aberrantes pour nous aider à bien préparer les données avant de les envoyer à un modèle, puisque les valeurs aberrantes influencent de nombreux modèles d'apprentissage automatique.
3. Cadre de violon
- Les parcelles de violon peuvent être considérées comme une combinaison de boîtes à moustaches au milieu et de parcelles de distribution(Estimation de la densité des grains) des deux côtés des données.
- Cela peut nous donner la description de la distribution de l'ensemble de données comme si la distribution était multimodal, Obliquitéetc.
- Il nous fournit également des informations utiles telles que Intervalle de confiance de 95%.
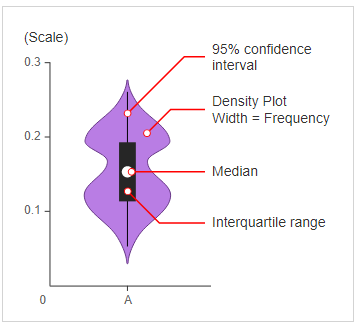
Figure. Schéma général pour un cadre de violon
Mise en œuvre:
- L'intrigue du violon est présente dans le Seaborn emballer.
L'extrait de code est le suivant:
sns.violinplot(x='SurvStat',y='op_yr',données=hb,taille=6)
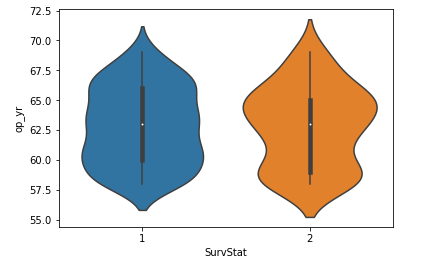
Quelques conclusions déduites de l'intrigue du violon ci-dessus:
De l'intrigue de violon précédente, nous pouvons conclure les observations suivantes:
- La médiane des deux classes est proche de 63.
- Le nombre maximum de personnes avec classe 2 il a un op_yr valeur de 65 tandis que, pour les gens de la classe 1, la valeur maximale est d'environ 60.
- En même temps, le troisième quartile de la médiane a moins de points de données que la médiane du premier quartile.
Techniques d'analyse bivariée pour la visualisation des données
1. Graphique linéaire
- C'est le graphique que l'on peut voir dans les coins de tout type d'analyse entre 2 variables.
- Les graphiques en courbes ne sont rien de plus que les valeurs d'une série de points de données à connecter avec des lignes droites.
- L'intrigue peut sembler très simple mais elle a plus d'applications non seulement dans l'apprentissage automatique mais dans de nombreux autres domaines.
Mise en œuvre:
- Le graphique linéaire est présent dans le Matplotlib emballer.
L'extrait de code est le suivant:
plt.plot(X,Oui)
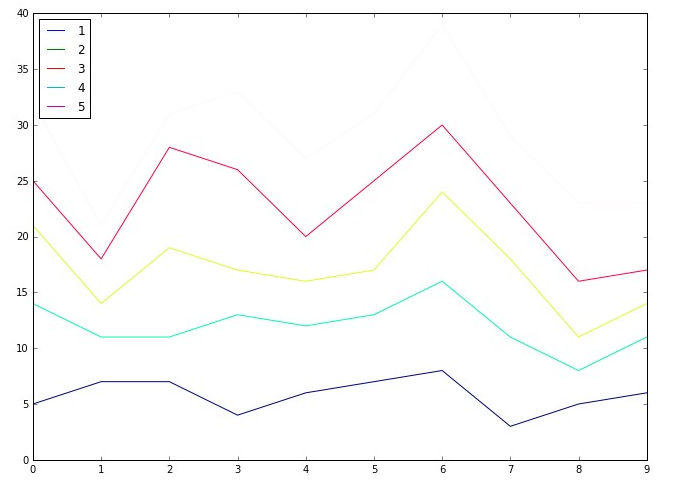
Quelques conclusions déduites du schéma de ligne précédent:
Du graphique linéaireLe graphique linéaire est un outil visuel utilisé pour représenter les données au fil du temps. Il se compose d’une série de points reliés par des droites, qui vous permet d’observer les tendances, Fluctuations et modèles dans les données. Ce type de graphique est particulièrement utile dans des domaines tels que l’économie, Météorologie et recherche scientifique, ce qui facilite la comparaison de différents ensembles de données et l’identification des comportements à tous les niveaux.. précédent nous pouvons tirer les observations suivantes:
- Ceux-ci sont utilisés directement à partir de l'exécution de la comparaison de distribution à l'aide de versements QQ pour régler le CV en utilisant le méthode du coude.
- Il est utilisé pour analyser les performances d'un modèle à l'aide de la courbe ROC- ASC.
2. Graphique à barres
- C'est l'un des graphiques les plus utilisés, que nous aurions vu plusieurs fois non seulement dans l'analyse des données, mais nous utilisons également ce graphique chaque fois qu'il y a une analyse de tendance dans de nombreux domaines.
- Même si cela semble simple, il est puissant pour analyser des données comme chiffres de ventes chaque semaine, revenu d'un produit, Nombre de visiteurs d'un site chaque jour de la semaineetc.
Mise en œuvre:
- Le graphique à barres est présent dans le Matplotlib emballer.
L'extrait de code est le suivant:
plt.bar(X,Oui)
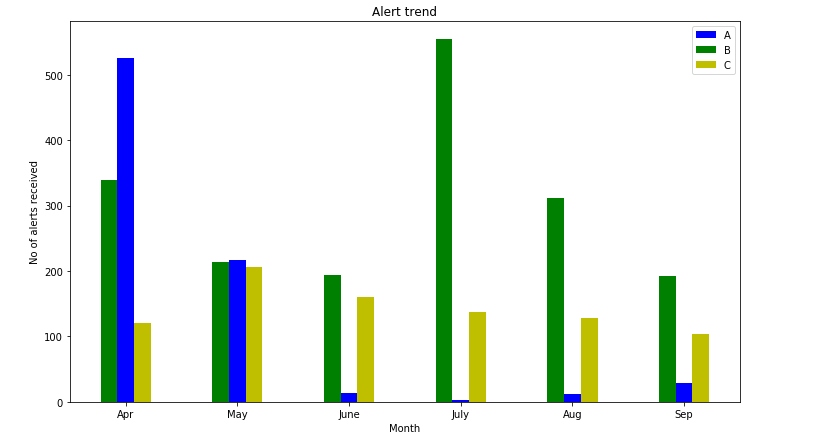
Quelques conclusions inférées du graphique à barres précédent:
À partir du graphique à barres précédent, nous pouvons conclure les observations suivantes:
- Nous pouvons visualiser les données dans un graphique sympa et nous pouvons transmettre les détails directement aux autres.
- Ce graphique peut être simple et clair, mais pas très souvent utilisé dans les applications de science des données.
3. Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées....
- C'est l'un des graphiques les plus utilisés pour visualiser des données simples en apprentissage automatique et en science des données..
- Ce graphique nous décrit comme une représentation, où chaque point de l'ensemble de données complet est présent par rapport à 2 O 3 fonctionnalités (Colonnes).
- Les diagrammes de dispersion sont disponibles en 2D et en 3D. Le nuage de points 2D est le plus courant, où nous essaierons principalement de trouver les motifs, groupes et séparabilité des données.
Mise en œuvre:
- Le diagramme de dispersion est présent dans le Matplotlib emballer.
L'extrait de code est le suivant:
plt.scatter(X,Oui)
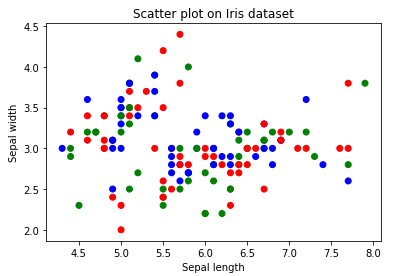
Quelques conclusions déduites du nuage de points ci-dessus:
Du diagramme de dispersion précédent, nous pouvons conclure les observations suivantes:
- Les couleurs sont attribuées à différents points de données en fonction de leur présence dans l'ensemble de données. En d'autres termes, représentation de la colonne cible.
- Nous pouvons colorer les points de données en fonction de leur étiquette de classe donnée dans l'ensemble de données.
Ceci termine la discussion d'aujourd'hui!!
Remarques finales
Merci pour la lecture!
J'espère que vous avez apprécié le post et augmenté vos connaissances des techniques de visualisation de données.
N'hésitez pas à me contacter sur Courrier électronique
Tout ce qui n'est pas mentionné ou voulez-vous partager vos pensées? N'hésitez pas à commenter ci-dessous et je vous répondrai.
Pour les postes restants, Demande à Relier.
A propos de l'auteur
Aashi Goyal
En ce moment, Je poursuis mon Bachelor of Technology (B.Tech) en génie électronique et des communications de Universidad Guru Jambheshwar (GJU), Hisar. Je suis très excité par les statistiques, l’apprentissage automatique et l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé....
Vos suggestions et doutes sont les bienvenus ici dans la section commentaires. Merci d'avoir lu mon post !!





