
Cet article a été publié dans le cadre du Blogathon sur la science des données
Visualisation de données
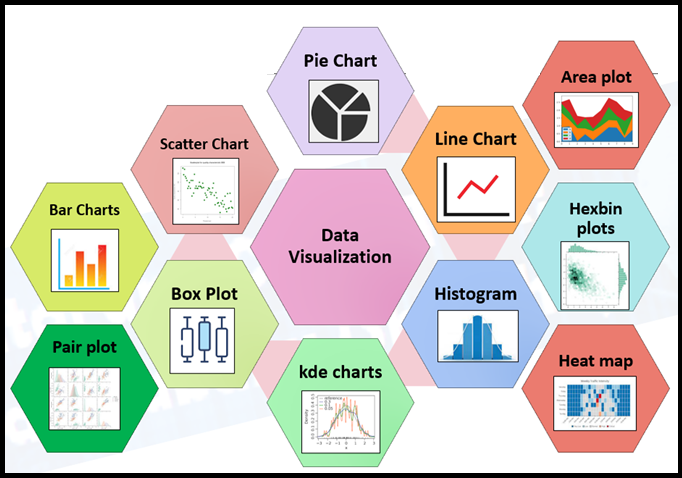
Les techniques de visualisation de données impliquent la génération de représentations graphiques ou picturales. de données, formulaire qui vous amène à comprendre les informations dans un ensemble de données donné. Cette technique de visualisation vise à identifier les modèles, les tendances, corrélations et valeurs aberrantes des ensembles de données.
Avantages de la visualisation des données
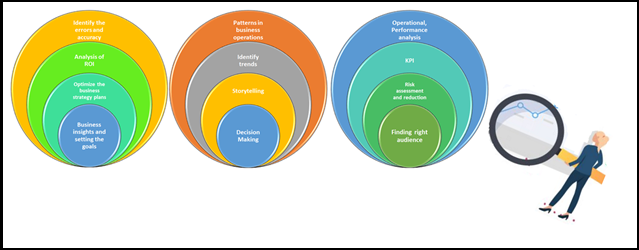
- Modèles dans les opérations commerciales: Les techniques de visualisation des données nous aident à déterminer les modèles d'opérations commerciales. Comprendre l'énoncé du problème et identifier les solutions en termes de modèles et appliqués pour éliminer un ou plusieurs des problèmes inhérents.
- Identifier les tendances commerciales et interagir avec les données: Sommes Les techniques nous aident à identifier les tendances du marché en collectant des données sur les activités commerciales quotidiennes et en préparant des rapports sur les tendances., qui permet de suivre l'influence de l'entreprise sur le marché. Pour que nous puissions comprendre la concurrence et les clients. Certainement, cela aide à avoir une perspective à long terme.
- Narration et prise de décision: La connaissance de la narration à partir des données disponibles est l'une des compétences de niche pour la communication d'entreprise, spécifiquement pour le domaine de la science des données, qui joue un rôle essentiel. En utilisant la meilleure visualisation, ce rôle peut être beaucoup mieux amélioré et atteindre les objectifs des problèmes commerciaux.
- Comprendre les informations commerciales actuelles et fixer des objectifs: Las empresas pueden comprender la información de los KPIKPI, o Indicateurs clés de performance, Il s’agit de mesures utilisées par les organisations pour évaluer leur succès dans l’atteinte d’objectifs spécifiques. Ces indicateurs vous permettent de suivre les progrès et de prendre des décisions éclairées. Il existe différents types de KPI, qui peuvent varier en fonction du secteur et des objectifs stratégiques de l’entreprise. Sa bonne mise en œuvre est essentielle pour améliorer l’efficience et l’efficacité des opérations.... commercial, trouver des objectifs tangibles et des plans de stratégie commerciale, afin qu'ils puissent optimiser les données pour les plans de stratégie commerciale pour les activités en cours.
- Analyse opérationnelle et de performance:
- Augmenter la productivité de l'unité de fabrication: A l'aide de techniques de visualisation, la clarté des KPI représentant les tendances de la productivité des unités de fabrication et les orientations devaient améliorer la productivité de l'usine.
Visualisation des données en science des données
Les techniques de visualisation des données sont la partie la plus importante de la science des données, il n'y aura aucun doute là-dessus. Et même dans l'espace d'analyse de données, la visualisation des données joue un rôle important. Nous discuterons de cela en détail à l'aide de packages Python et de la manière dont cela aide pendant le déroulement du processus Data Science.. C'est un sujet très intéressant pour tous les scientifiques et analystes de données..
je. Graphique linéaireLe graphique linéaire est un outil visuel utilisé pour représenter les données au fil du temps. Il se compose d’une série de points reliés par des droites, qui vous permet d’observer les tendances, Fluctuations et modèles dans les données. Ce type de graphique est particulièrement utile dans des domaines tels que l’économie, Météorologie et recherche scientifique, ce qui facilite la comparaison de différents ensembles de données et l’identification des comportements à tous les niveaux..
Graphique linéaire est une simple visualisation de données en python, qui est disponible en Matplotlib.
Graphiques linéaires sont utilisés pour représenter la relation entre deux données X et Y sur l'axe respectif. Voyons quelques exemples
Échantillon #1
# importer les bibliothèques requises
importer matplotlib.pyplot en tant que plt
importer numpy en tant que np
#tableau simple
x = np.tableau([1, 2, 3, 4])
#générer des valeurs y
y = x*2
plt.plot(X, Oui)
plt.show()
Échantillon #2
x = np.tableau([1, 2, 3, 4])
y = np.tableau([2, 4, 6, 8])
plt.plot(X, Oui)
plt.xlabel("Temps en heures")
plt.ylabel("Distance en Km")
plt.titre("Temps Vs Distance")
plt.show()
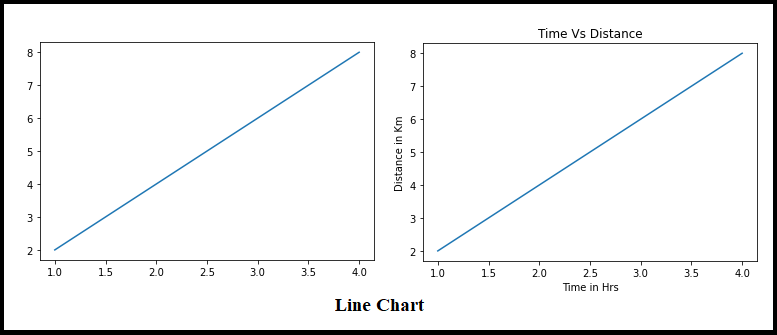
Graphique en courbes toujours une relation linéaire entre les axes X et Y, on peut le voir sur l'image ci-dessus.
II.Histogramme
L'histogramme est la représentation graphique d'un ensemble de distribution de données numériques. Il est une sorte de graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité.... con el eje X y el eje Y representa los rangos y la frecuencia de los intervalos, respectivement. Comment lire ou représenter ce tableau.
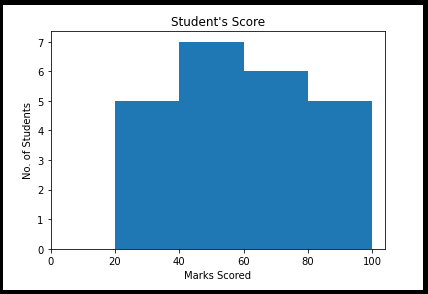
Disons l'exemple, ensemble de notes des élèves dans les plages et fréquences indiquées ci-dessous. Ici, nous pourrions comprendre exactement la plage et la fréquence de coupure.
de matplotlib importer pyplot en tant que plt

importer numpy en tant que np

figure,ax = plt.subplots(1,1)

a = np.tableau([25,42,48,55,60,62,67,70,30,38,44,50,54,58,75,78,85,88,89,28,35,90,95])

hache.hist(une, bacs = [20,40,60,80,100])

ax.set_title("Student's Score")

ax.set_xticks([0,20,40,60,80,100])

ax.set_xlabel('Marks Scored')

ax.set_ylabel('Non. of Students')

plt.show()
Caractéristiques de l'histogramme
- Les Histogramme est utilisé pour obtenir des observations inhabituelles dans l'ensemble de données à partir de.
- Mesuré sur une échelle de valeurs numériques donnée avec plusieurs conteneurs de données.
- L'axe Y représente le nombre de % d'occurrences dans les données
- L'axe X représente les distributions de données.
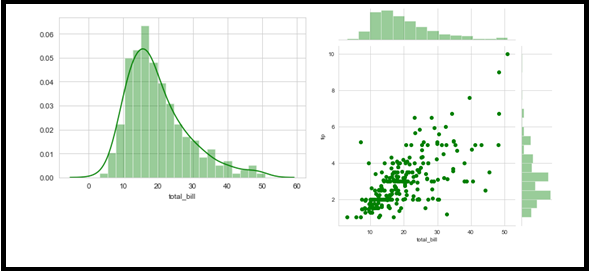
Spectacle – Ceci est similaire à l'histogramme sur le graphique, mais avec des fonctionnalités supplémentaires. Et apporter Estimation de la densité des grains (OÙ).
Terrain commun – Une combinaison de dispersion et d'histogramme.
importer seaborn comme sns
importer matplotlib.pyplot en tant que plt
à partir des avertissements importer des avertissements de filtre
df = sns.load_dataset('tips')
sns.distplot(df[total_bill'], où = Vrai, couleur="vert", bacs = 20)
sns.jointplot(x ='total_bill',couleur="vert", y ='tip', données = df)
III Diagramme à secteurs
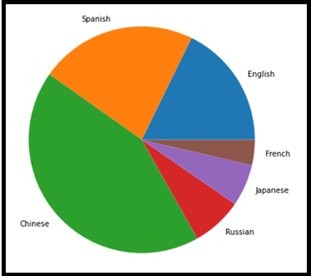
Il s'agit d'un graphique et d'un camembert très familiers représentant un graphique statistique à partir d'une série de données. Ceci est couramment utilisé dans les présentations commerciales pour représenter les commandes, Ventes, Bénéfices, pertes, etc. Il se compose de portions de données qui font partie de la collecte d'un même ensemble et d'une différenciation par caractères. Chacune des tranches de gâteau s'appelle un coin avec des valeurs de différentes tailles.
Ce tableau est largement utilisé pour représenter la collection de composition.. Parfait pour le type de données catégoriel.
de matplotlib importer pyplot en tant que plt
importer numpy en tant que np
Langue = ['English', 'Spanish', 'Chinese',
        'Russian', 'Japanese', 'French']
données = [379, 480, 918, 154, 128, 77.2]
# Création d'un tracé
fig = plt.figure(taille de la figue =(10, 7))
plt.pie(Les données, étiquettes = langue)
# montrer l'intrigue
plt.show()
importer matplotlib.pyplot en tant que plt
importer numpy en tant que np
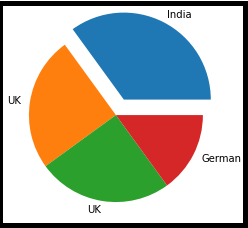
y = np.tableau([35, 25, 25, 15])
mesétiquettes = ["Inde", "Royaume-Uni", "Royaume-Uni", "Allemand"]
monexplosion = [0.2, 0, 0, 0]
plt.pie(Oui, étiquettes = mes étiquettes, exploser = myexploser)
plt.show()
IV. parcelle de terrain
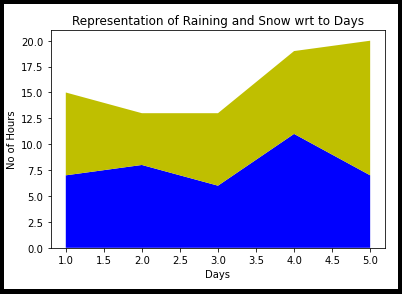
Ceci est très similaire à un graphique en courbes avec des clôtures entourées d'une ligne de démarcation de différentes couleurs.. Representación simple de la evolución de una variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... numérique.
importer matplotlib.pyplot en tant que plt

jours = [1, 2, 3, 4, 5]

il pleut = [7, 8, 6, 11, 7]

neige =  [8, 5, 7, 8, 13]

plt.stackplot(jours, il pleut, neiger,couleurs =['b', 'y'])

plt.xlabel('Days')

plt.ylabel('No of Hours')

plt.titre('Representation of Raining and Snow wrt to Days')

plt.show()
V. Nuages de points
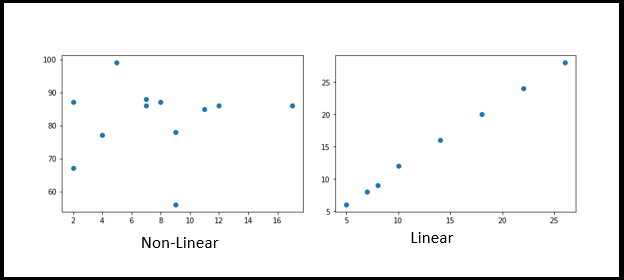
Les nuages de points sont utilisés pour tracer des points de données sur les deux axes (horizontal et vertical) y représente la corrélation entre chaque axe. Principalement dans la mise en œuvre de la Data Science / Machine Learning et avant le processus EDA, nous devons généralement analyser à quel point ils sont dépendants et indépendants. Il peut être positif ou négatif ou, parfois, être dispersé sur le graphique.
importer matplotlib.pyplot en tant que plt
x = [5,7,8,7,2,17,2,9,4,11,12,9]
y = [99,86,87,88,67,86,87,78,77,85,86,56]
plt.scatter(X, Oui)
plt.show()
importer matplotlib.pyplot en tant que plt

x = [5,7,8,10,14,18,22,26]

y = [6,8,9,12,16,20,24,28]

plt.scatter(X, Oui)

plt.show()
NOUS. portions Hexbin
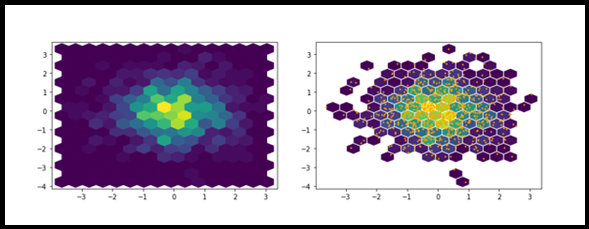
La cible Hexbins est utilisée pour regrouper les deux ensembles de valeurs numériques. Hexbins permet d'améliorer la visualisation des nuages de points. Parce que pour un plus grand ensemble de données, un Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées.... crea un puñado de puntos confusos. Nous pouvons améliorer cela avec Hexbins. Fournit deux modes de rendu: 1. Liste de coordonnées 2. Objet géospatial.
importer numpy en tant que np
importer matplotlib.pyplot en tant que plt
x = np.aléatoire.normal(taille =(1, 1000))
y = par exemple aléatoire.normal(taille =(1, 1000))
plt.hexbin(X, Oui, taille de la grille=15)
plt.hexbin(X,Oui,taille de la grille=15, Hacher 1 =, edgecolors="blanche")

plt.scatter(X,Oui, s=2, c="Orange")

plt.show()
VII. Carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées....
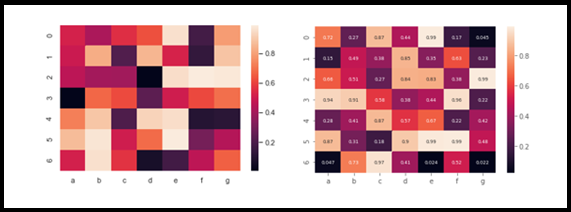
UNE carte de chaleur est l'une de mes techniques de visualisation préférées parmi les autres graphiques. essentiellement, un ensemble de corrélations variables est représenté par plusieurs nuances de la même couleur. Comme d'habitude, les tons plus sombres du graphique représentent les valeurs de corrélation plus élevées que le ton plus clair. cette carte aiderait les scientifiques des données à découvrir comment la variable cible est en corrélation avec d'autres variables dépendantes dans l'ensemble de données donné. Les variables moins corrélées peuvent être supprimées pour une analyse plus détaillée, On pourrait dire que cela nous aide pendant le processus de sélection des fonctionnalités. Puis les regrouper en X, Et comme notre objectif et suivi d'un test et d'une division du train.
importer seaborn comme sn
importer numpy en tant que np
importer des pandas au format pd
df=pd.DataFrame(np.aléatoire.aléatoire((7,7)),colonnes=['une','b','c','d','e','f','g'])
sn.heatmap(df)
sn.heatmap(df,annot=Vrai,annot_kws ={'size':7})
VIII. Box plot
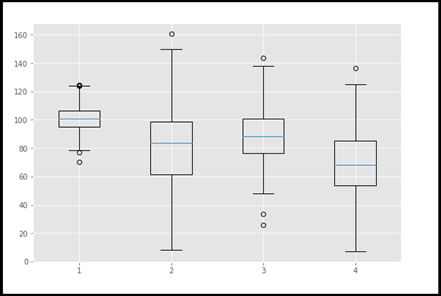
Une boîte à moustaches est un type de graphique souvent utilisé dans le cycle de vie de la science des données., en particulier lors de l'analyse des données explicatives (AED). Représenter la distribution des données sous forme de quartiles ou de centiles. Q1 représente le premier quartile (centile 25), Q2 est le deuxième quartile (centile 50 / médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes....), Q3 représente le troisième quartile (T3) et Q4 représente le quatrième quartile ou la plus grande valeur.
En utilisant ce graphique, nous avons pu identifier les valeurs aberrantes très rapidement et facilement. C'est une intrigue très efficace parmi toutes les intrigues. Donc, après avoir supprimé les valeurs aberrantes, l'ensemble de données doit subir une sorte de test statistique et être ajusté pour une analyse plus détaillée.
#importer matplotlib.pyplot en tant que plt
np.random.seed(10)
un=np.aléatoire.normal(100,10,200)
deux=np.random.normal(80, 30, 200)
trois=np.random.normal(90, 20, 200)
quatre=np.random.normal(70, 25, 200)
to_plot=[une,deux,Trois,quatre]
fig=plt.figure(1,taille de la figue=(9,6))
ax=fig.add_subplot()
bp=ax.boxplot(comploter)
fig.sauvefig('boxplot.png',bbox_pouces="serré")
IX. Portion
Un graphique est un autre graphique important dans le cycle de vie de la science des données pendant le processus EDA., analyser comment les caractéristiques sont liées les unes aux autres, sous forme de représentation graphique miniature basée sur une grille le long des axes X et Y, corrélée positivement ou corrélée négativement. . Ensuite, évidemment, nous pourrions éliminer ceux corrélés négativement, considérer les paires positivement corrigées et passer à une analyse plus détaillée. Ceci est très similaire à la carte thermique, mais ici on pouvait voir la relation à l'oeil nu. C'est spécial ici. J'espère que tu peux te permettre ça. Encore, c'est la meilleure façon de passer par le processus de sélection des rôles.
importer des pandas au format pd
importer seaborn en tant que qn
de matplotlib importer pyplot en tant que plt
df = sb.load_dataset('iris')
sb.set_style("tiques")
sb.pairplot(df,teinte ="espèce",diag_kind = "où",genre = "dispersion",palette = "bousculer")
plt.show()
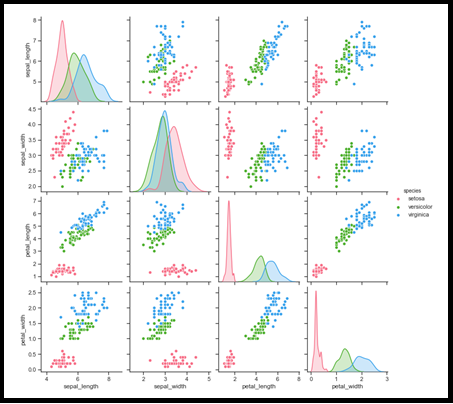
Le graphique linéaire est toujours une relation linéaire entre les axes X et Y, nous observons que l'image ci-dessus
X. Graphique à barres
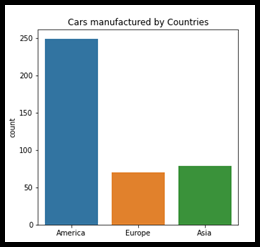
Un graphique à barres ou un graphique à barres est généralement un graphique très familier pour présenter des données catégorielles avec des barres rectangulaires. Peut être dessiné horizontalement ou verticalement. ce graphique représenterait l'impact de la catégorie de l'individu sur l'ensemble de données donné. Regardez d'abord d'abord. Dans le graphique ci-dessous, « Amérique » a beaucoup plus d'impact que « Europe » et « Asie ». Cela conduirait à une certaine observation sur l'ensemble de données et se concentrerait sur l'énoncé du problème.
figure, ax = plt.subplots(taille de la figue = (5, 5))


sns.countplot(x = df_cars.origin.values, data=df_cars)

étiquettes = [item.get_text() pour l'élément dans ax.get_xticklabels()]

Étiquettes[0] = 'America'

labels[1] = 'Europe'

labels[2] = 'Asia'

ax.set_xticklabels(Étiquettes)

ax.set_title("Voitures fabriquées par pays")

plt.show()
Univariante – Analyse bivariée et multivariée
Analyse des variantes dans le processus Data Science, pourrait être univarié (O) Bi-variable (O) Multivarié.
- Univariante: une seule variable à la fois.
- Bi-variable: comparer deux variables.
- Multivarié: comparer plus de deux variables
Vous pouvez très bien référencer les anciens modèles avec le Graphics / Visualisation dont nous avons parlé depuis le début de l'article. Vérifiez-le à nouveau. Certainement, vous pouvez comprendre l'importance de ces techniques de visualisation de données.
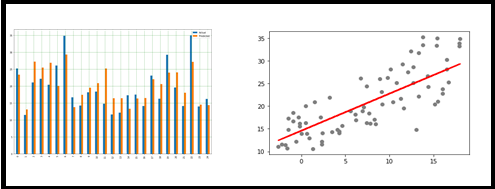
Merci d'avoir lu cet article et je pense qu'il est utile pour vous.. et vous pouvez vous en rendre compte lorsque vous optez pour la mise en œuvre de la solution Data Science avant la sélection du modèle. Même après tout, l'évaluation et les prédictions du modèle sont le résultat de comparaisons. Comme indiqué ci-dessous dans les images de référence.
Merci! Une fois de plus. Nous vous contacterons avec un autre sujet intéressant. D'ici là au revoir! Wow! – Shanthababu
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





