
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
Un guide étape par étape pour démarrer avec Seaborn !!
Si matplotlib « essayer de rendre les choses faciles faciles et les choses difficiles possibles », Seaborn essaie également de faciliter un ensemble bien défini de choses difficiles.
Fraîcheur marine:
Les plus grandes forces de Seaborn sont sa diversité de capacités de traçage. Il nous permet de faire des graphiques compliqués même en une seule ligne de code !!
Dans ce tutoriel, nous utiliserons trois bibliothèques pour faire le travail: Matplotlib, Seaborn, Pandas. Si vous êtes un débutant complet en Python, Je vous suggère de commencer et de vous familiariser un peu avec Matplotlib et Pandas.
Si vous suivez exactement ce tutoriel, vous pourrez créer de beaux graphismes avec ces trois bibliothèques. Ensuite, vous pouvez utiliser mon code comme modèle pour les futures tâches de visualisation à l'avenir.
Commençons notre voyage en mer avec le célèbre jeu de données Pokémon. Avant de commencer, Je vous recommande fortement d'écrire vos propres codes de base pour chaque graphique et d'essayer d'expérimenter avec les graphiques.
Vous pouvez trouver l'ensemble de données Pokémon sur Kaggle. Cependant, pour faciliter votre voyage, J'ai raccourci et nettoyé cette version de l'ensemble de données.
Vous pouvez télécharger l'ensemble de données ici: https://github.com/shelvi31/Seaborn-Experiments
Mon super économiseur: Je voudrais mentionner une ressource qui est toujours mes super économies quand je suis coincé. https://python-graph-gallery.com/ .
Commençons maintenant:
Nous allons commencer par importer les bibliothèques nécessaires:
#importation de bibliothèques
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
Lire le fichier CSV
données = pd.read_csv("Pokemon.csv",encoding='unicode_escape')
J'ai modifié l'erreur de codec utf8 en définissant un pack de codecs différent dans la commande read_csv ().
Nos données ressemblent à ceci....
data.head()
Production:
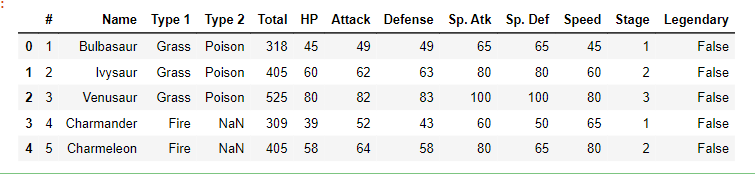 Production
Le nom des colonnes ne simplifie pas clairement leur objectif. Il est important de connaître le jeu de données avant de travailler dessus.
Voici la description simplifiée du jeu de données pour vous.
Cet ensemble de données comprend 150 Pokémon, il s'agit de jeux pokémon (PAS de cartes Pokémon ou Pokémon Go).
Dans cet ensemble de données, avoir 150 rangées et 13 Colonnes.
Description des colonnes:
# ID pour chaque pokémon
# nom: Nom de chaque pokémon
# Type 1: chaque pokémon a un type, cela détermine la faiblesse / résistance aux attaques
# Type 2: Certains Pokémon sont de type double et ont 2
# Total: somme de toutes les statistiques qui suivent, un guide général sur la force d'un Pokémon
# HP: points de dommage, ou la santé, définit combien de dégâts un pokémon peut subir avant de s'évanouir
# Attaque: le mod de base pour les attaques normales (par exemple, Rayure, Coup de poing)
# Défendre: résistance aux dégâts de base contre les attaques normales.
# Attaque SP: attaque spéciale, le modificateur de base pour les attaques spéciales (par exemple, Incendie / Explosion, faisceau de bulle)
# Déf SP: résistance aux dégâts de base contre les attaques spéciales
# La vitesse: détermine quel Pokémon attaque en premier à chaque tour.
# Étape: Numéro de génération
#Légendaire: vrai si c'est un pokémon légendaire, faux oui non
J'ai renommé les noms des colonnes pour donner plus de sens à notre intrigue et pour plus de clarté d'esprit. Bien qu'il soit facultatif, Je vous recommande fortement de le faire pour éliminer tout risque de confusion.
données.renommer(colonnes = {"#":"Non.","Taper 1":"Pokemon_Type","Taper 2":"PokemonType2",'Le total':« Somme de l'attaque »,« HP »:"Points de dommage","Attaque" : "Force d'attaque", "La défense":« Force défensive »,”Esp. Atk":"Stenth d'attaque spéciale",”Esp. Déf":« Force de défense spéciale »,"Organiser":"Génération"}, en place = vrai)data.head()
Ma sortie ressemble maintenant:
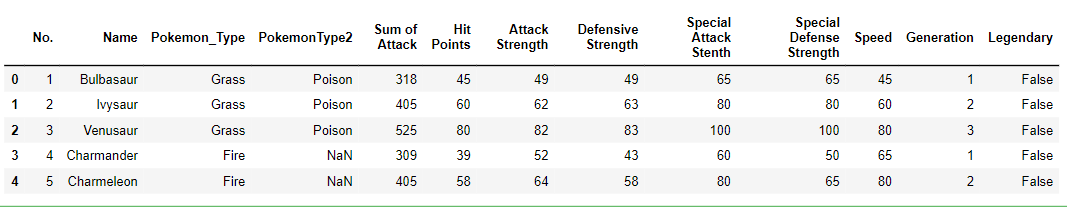 Beaucoup mieux!
Commençons la visualisation par les plus simples, le graphique de répartition.
Parcelles de distribution:
UNE parcelle de distribution montrer un Distribution et plage d’un ensemble de valeurs numériques tracées en fonction d’un dimension"Dimension" C’est un terme qui est utilisé dans diverses disciplines, comme la physique, Mathématiques et philosophie. Il s’agit de la mesure dans laquelle un objet ou un phénomène peut être analysé ou décrit. En physique, par exemple, On parle de dimensions spatiales et temporelles, alors qu’en mathématiques, il peut faire référence au nombre de coordonnées nécessaires pour représenter un espace. Sa compréhension est fondamentale pour l’étude et.... Les histogrammesLes histogrammes sont des représentations graphiques qui montrent la distribution d’un ensemble de données. Ils sont construits en divisant la plage de valeurs en intervalles, O "Bacs", et compter la quantité de données tombées dans chaque intervalle. Cette visualisation vous permet d’identifier des modèles, Tendances et variabilité des données, faciliter l’analyse statistique et la prise de décision éclairée dans diverses disciplines.... vous permettent de tracer les distributions de variables numériques.
Aurait pu utiliser « Data.hist (taille de la figue = (12,10), bacs = 20) » , mais comme toutes les colonnes de ce base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.... ont des valeurs numériques. Donc, Je dois tracer des parcelles de distribution individuelles.
plt.figure(taille de la figue=(4,3))
sns.distplot(x=données["Somme d'attaque"],couleur = "Orange",où = vrai,tapis = vrai);
plt.show()
Sortie du tracé de distribution: Somme d'attaque Pokémon
La fonction Seaborn plot trace un histogramme avec une courbe de densité. Nous pouvons éliminer la densité en utilisant l'option kde = ”False”. Vérifiez la présence de tapis à l'aide de rug = « True ».
Il existe de nombreuses façons alternatives de tracer un histogramme en Python:
plt.figure(taille de la figue=(3,3))
sns.histplot(x=données["Somme d'attaque"],couleur = "Vert");
plt.show()
Une autre façon est: en utilisant plt.hist ()
plt.figure(taille de la figue=(3,3))
plt.hist(x=données["Somme d'attaque"],couleur="rouge",bacs=20);
plt.show()
Donc, il existe de nombreuses façons de représenter graphiquement les distributions. Toutes les fonctions pyplot.hist, seaborn.coOutuntplot Oui seaborn.displot ils agissent comme des enveloppes pour un graphique à barres matplotlib et peuvent être utilisés si le traçage manuel d'un tel graphique à barres est considéré comme trop lourd.
- Pour les variables discrètes, un
seaborn.countplotil est plus commode. - Pour les variables continues:
pyplot.histOseaborn.distplotIls sont utilisés.
Parcelles de distribution commune:
Les diagrammes de distribution conjoints combinent les informations des nuages de points et des histogrammes pour nous fournir des informations détaillées sur les distributions bivariées..
sns.jointplot(x=données["Somme d'attaque"],y = données[« Force défensive »],couleur = "Rouge");
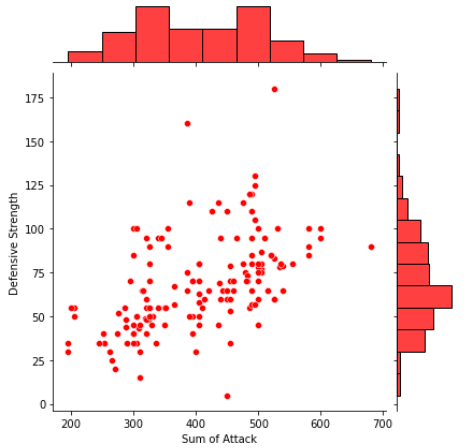
Départ: Terrain commun
Tableaux de densité:
Les graphiques de densité montrent la distribution entre deux variables.
sns.kdeplot(x=données["Somme d'attaque"],y = données[« Force défensive »])
plt.show()
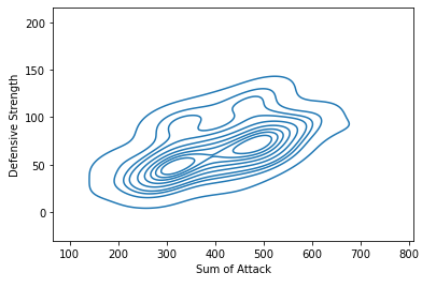 Départ: Graphique de densité
Graphique à barres
Les graphiques à barres nous aident à visualiser les distributions des variables catégorielles: Countplot est un type de graphique à barres.
plt.figure(taille de la figue=(10,6));
sns.countplot(x=données.Pokemon_Type,palette=pkmn_type_colors);
plt.show()
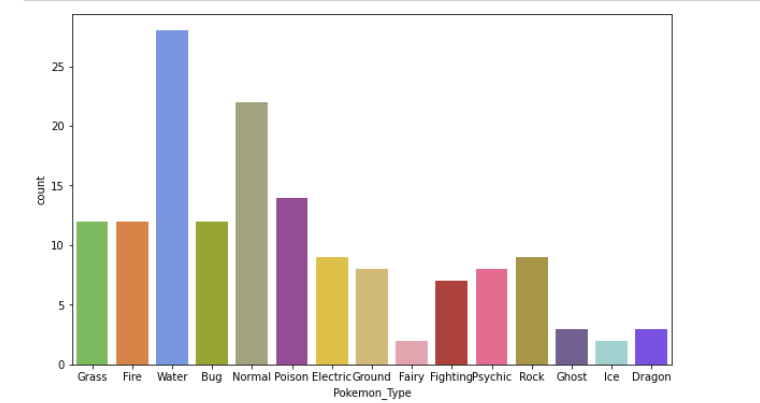 Départ: Graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité....
Carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées....
Carte de chaleur nous aide à visualiser les données matricielles sous forme de points chauds et froids. Les couleurs chaudes ont indiqué les sections avec le plus d'interaction avec les visiteurs.
plt.figure(taille de la figue=(8,6));
sns.heatmap(data.corr());# Faire pivoter les étiquettes x à l'aide de matplotlib
plt.xticks(rotation=-45);
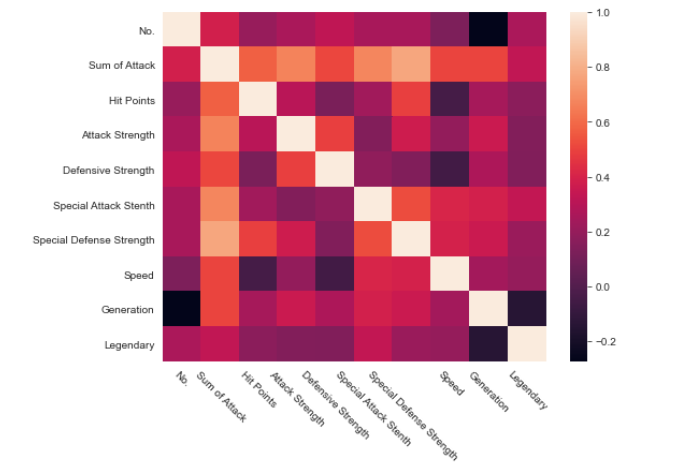 Départ: carte de chaleur
Nuage de pointsUn nuage de points est une représentation visuelle qui montre la relation entre deux variables numériques à l’aide de points sur un plan cartésien. Chaque axe représente une variable, et l’emplacement de chaque point indique sa valeur par rapport aux deux. Ce type de graphique est utile pour identifier des modèles, Corrélations et tendances dans les données, faciliter l’analyse et l’interprétation des relations quantitatives....:
UNE nuage de points (Aussi connu comme dispersion graphique, Nuage de points) utilise des points pour représenter les valeurs de deux variables numériques différentes. La position de chaque point sur l'axe horizontal et vertical indique les valeurs pour un point de données individuel.
Nuage de points sont utilisés pour observer les relations entre les variables.
J'ai comparé les statistiques d'attaque et de défense de nos Pokémon à l'aide de diagrammes de dispersion.
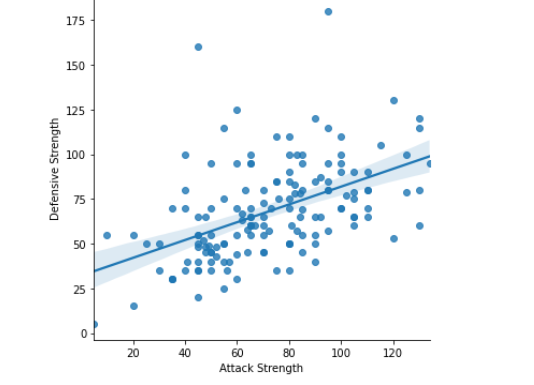 Départ: nuage de points
Seaborn n’a pas de Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées.... dédié, donc on voit une ligne diagonale (ligne de régression) ici par défaut.
Heureusement, Seaborn nous aide à modifier l'intrigue:
- fit_reg = False est utilisé pour supprimer la ligne de régression
- teinte = ‘Étape’ Il est utilisé pour colorer les points pour une troisième valeur variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes..... De cette façon, nous permet d'exprimer la troisième dimension de l'information en utilisant la couleur.
Ici, j'ai le stade d'évolution Pokémon comme troisième variable !!
#Ajustement avec les nuages de points ns.lmplot(x='Force d'attaque', y='Force défensive', données = données, fit_reg = Faux, #Supprimer la ligne de régression teinte = "Génération"); #Se séparer selon la génération de pokémon
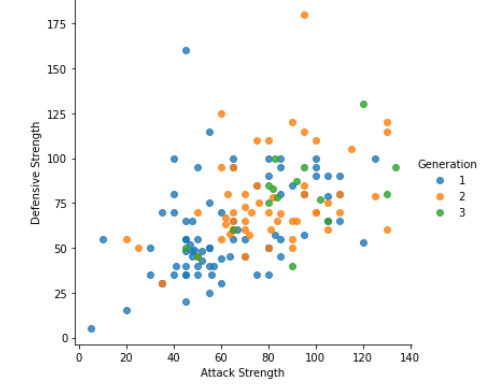 Résultat: nuage de points ajusté
Plus de la densité tombe sur la marque 40-120, Je vais modifier les limites de l'axe à l'aide de matplotlib:
sns.lmplot(x='Force d'attaque', y='Force défensive', données = données,
fit_reg = Faux, #Supprimer la ligne de régression
teinte = "Génération"); #Séparation selon pokemon generationplt.ylim(20,130);
plt.xlim(25,125);
Maintenant, nous pouvons voir un graphique meilleur et plus ciblé !!
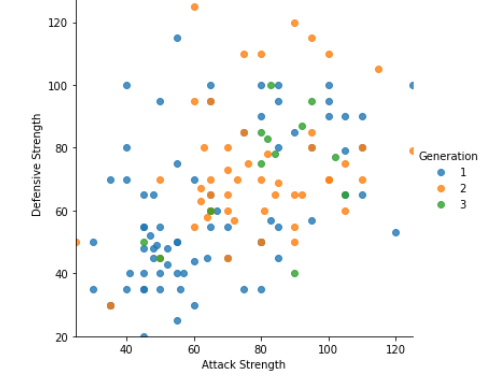 Résultat: meilleur nuage de points
Box plot
Une boîte à moustaches est utilisée pour représenter des groupes de données numériques à travers leur quartiles.
Les boîtes à moustachesDiagrammes encadrés, Aussi connu sous le nom de diagrammes en boîte et à moustaches, sont des outils statistiques qui représentent la distribution d’un ensemble de données. Ces diagrammes montrent la médiane, quartiles et valeurs aberrantes, Permettre de visualiser la variabilité et la symétrie des données. Ils sont utiles pour la comparaison entre différents groupes et pour l’analyse exploratoire, faciliter l’identification des tendances et des modèles dans les données.... Ils peuvent également avoir des lignes s’étendant à partir des boîtes, indiquant une variabilité à l’extérieur de la quartiles supérieur et inférieur, d'où les termes diagramme en boîtes et moustaches et diagramme en boîtes et moustaches
On peut supprimer la colonne « Somme d'attaque » puisque nous avons des statistiques individuelles. On peut aussi supprimer les colonnes « Génération » Oui « Légendaire » parce qu'ils ne combattent pas les statistiques.
plt.figure(taille de la figue=(15,7));# DataFrame préformaté
stats_data = data.drop([« Somme de l'attaque », 'Génération', 'Légendaire'], axe=1);

# Nouveau boxplot utilisant stats_df
sns.boxplot(data=stats_data,
 showfliers=Faux); #Suppression des valeurs aberrantessns.set_style(« grille blanche »)
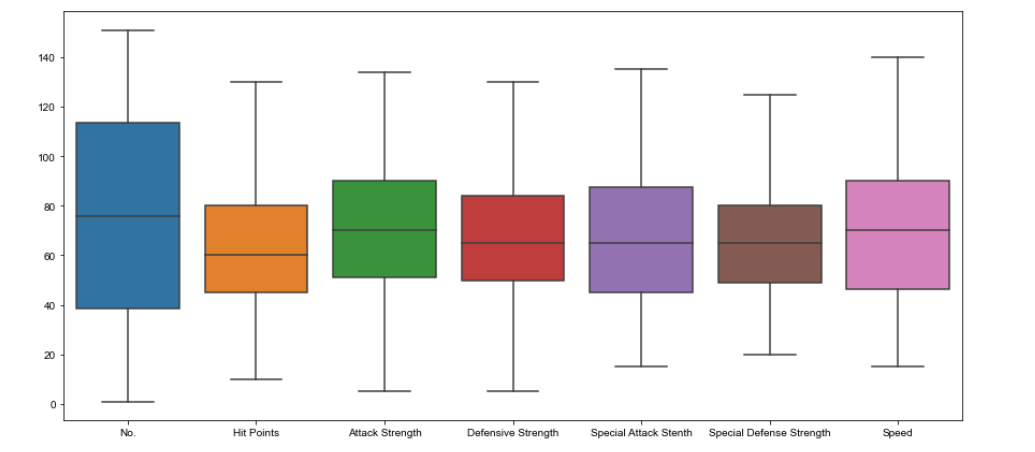 Départ: Box plot
N’oubliez pas de conserver le Taille de la figurineLe "Taille de la figurine" désigne les dimensions et les proportions d’un objet ou d’une représentation dans le domaine de l’art, Design et anatomie. Ce concept est fondamental pour la composition visuelle, puisqu’il influence la perception et l’impact de l’œuvre. Comprendre la bonne taille vous permet de créer un équilibre esthétique et une hiérarchie visuelle, facilitant ainsi la communication efficace du message souhaité.... Avant de tracer le graphique.
Cadres de violon
Maintenant je vais retracer l'intrigue du violon.
Les Fiddle plots sont des alternatives aux box plots. Afficher la répartition (à travers l'épaisseur du violon) au lieu de simples statistiques récapitulatives.
Ici, j'ai montré la répartition de l'attaque par type principal de Pokémon
plt.figure(taille de la figue=(15,7));
sns.violinplot(x=données.Pokemon_Type, y = données["Force d'attaque"]);
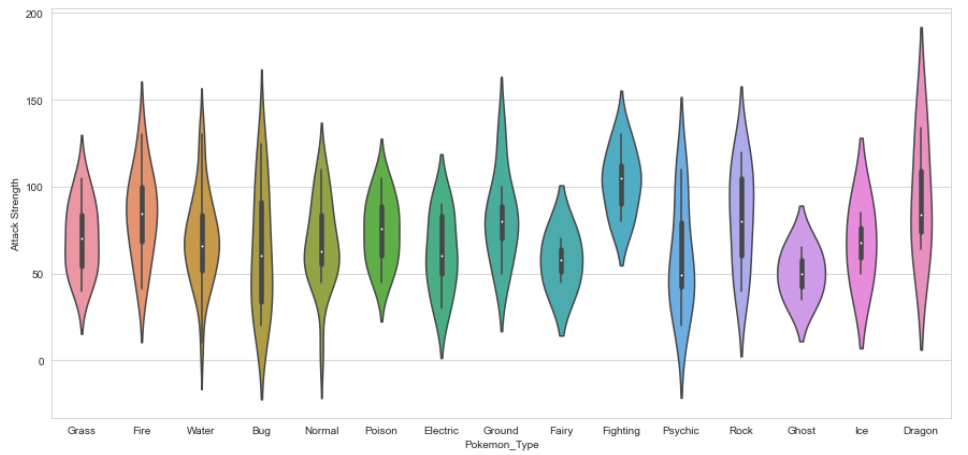 Départ: Complot de violon
Comme tu peux le voir, Les types de dragon ont tendance à avoir des statistiques d'attaque plus élevées que les types de fantôme, mais ils ont aussi une plus grande variation.
À présent, Les fans de Pokémon peuvent trouver quelque chose d'assez choquant dans cette intrigue: Les couleurs sont absurdes. Pourquoi le type Herbe est-il rose ou le type Eau orange ?? Nous devons résoudre ce problème immédiatement !!
Heureusement, Seaborn nous permet de configurer des palettes de couleurs personnalisées. Nous pouvons simplement créer une commande liste Python valeurs de couleur hexadécimales.
J’ai utilisé Bulbapedia pour en créer un nouveau Palette de couleursLa palette de couleurs est un outil fondamental dans le graphisme et la décoration. Il se compose d’une sélection de couleurs qui sont utilisées harmonieusement pour créer une atmosphère spécifique ou transmettre des émotions. Il existe plusieurs théories de la couleur qui aident à choisir des combinaisons efficaces, tels que la roue chromatique et le contraste. Une palette bien définie peut améliorer l’esthétique et la communication visuelle d’un projet.....
# utiliser Bulbapedia pour créer une nouvelle palette de couleurs:#Bulbapédie : https://bulbapedia.bulbagarden.net/wiki/Category:Type_color_templatespkmn_type_colors = ['#78C850', # Herbe
 '#F08030', # Feu
 '#6890F0', # L'eau
 « #A8B820 », # Bogue
 '#A8A878', # Normal
 ‘#A040A0’, # Poison
 '#F8D030', # Électrique
 ‘#E0C068’, # Sol
 « #EE99AC », # Fée
 ‘#C03028’, # Combat
 '#F85888', # Psychique
 '#B8A038', # Roche
 '#705898', # Fantôme
 '#98D8D8', # La glace
 '#7038F8', # Dragon
 ]
Apporter des modifications à l'intrigue du violon en fonction de la couleur du type de Pokémon:
plt.figure(taille de la figue=(15,7));
sns.violinplot(x=données.Pokemon_Type,
 y = données["Force d'attaque"],
 palette = pkmn_type_colors);
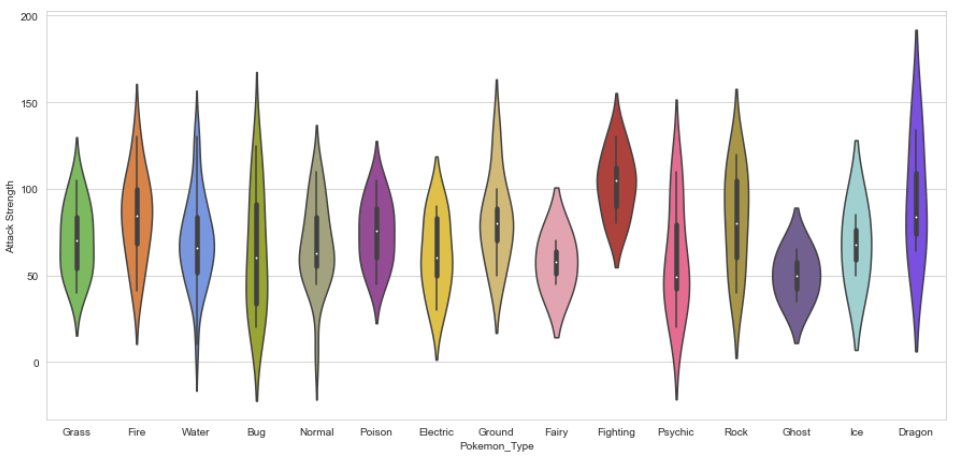 Résultat: Meilleure intrigue pour violon 🙂
Nuées d'essaims
Comme vous l'avez vu, les tableaux de violon sont parfaits pour visualiser les distributions.
Cependant, puisque nous n'avons que 150 Pokémon dans notre ensemble de données, nous pouvons vouloir juste montrer chaque point. C'est là que le parcelle d'essaim Entrez. Cette visualisation montrera chaque point, alors que « faire appel » ceux avec des valeurs similaires.
plt.figure(taille de la figue=(12,5));
sns.swarmplot(x=données.Pokemon_Type,y = données["Force d'attaque"],palette=pkmn_type_colors);
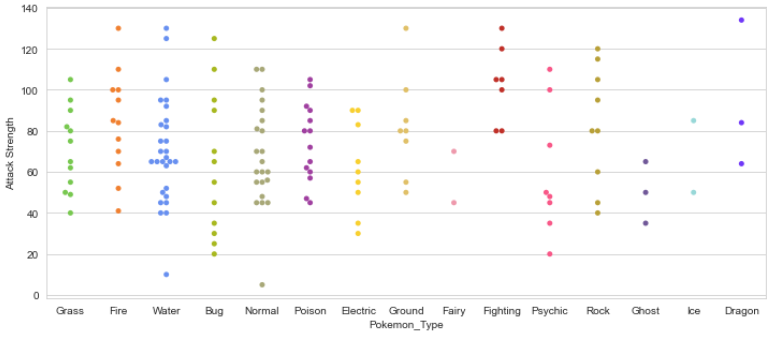 Swarmplot: Force d'attaque Pokémon Type Vs
Cela semble bon, mais pour de meilleures images, On peut combiner ces deux! Après tout, afficher les mêmes informations.
Graphismes superposés
plt.figure(taille de la figue=(10,10))sns.violinplot(x=données.Pokemon_Type, y = données["Force d'attaque"],
 intérieur=Aucun,
 palette = pkmn_type_colors);sns.swarmplot(x = "Pokemon_Type",
y = "Force d'attaque",
données = données,
couleur='noir', #rendre les points noirs
alpha=0,5);plt.titre("Force d'attaque selon le type de Pokémon");
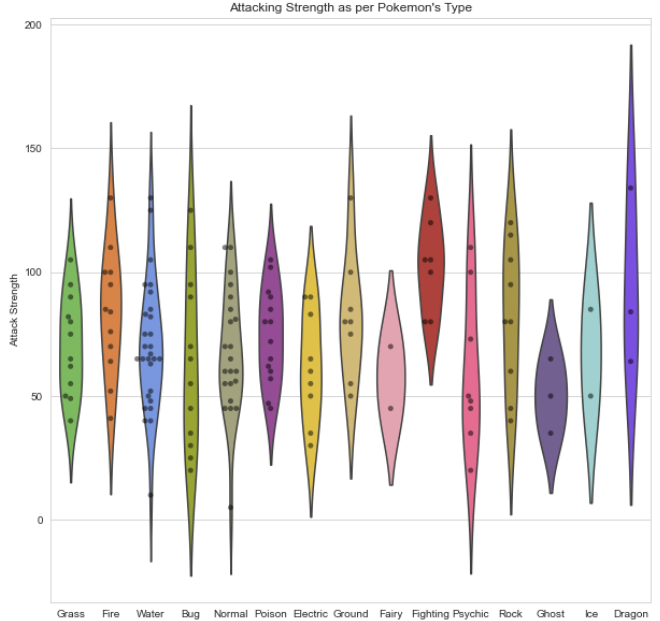 Graphismes superposés
Points à considérer:
intérieur = aucun: enlever les barres à l'intérieur des violons
alpha = 0.5: rend les points légèrement transparents: rappelez-vous que la valeur alpha doit être flottante, ne le garde pas « »
Vous pouvez trouver les références pour la couleur marine ici: https://python-graph-gallery.com/100-calling-a-color-with-seaborn/
Graphiques factoriels
Les graphiques factoriels permettent de séparer facilement les graphiques par classes catégorielles.
plt.figure(taille de la figue=(5,15))
factplot= sns.factorplot(x="Pokemon_Type",y ="Force d'attaque",données = données,teinte ="Génération",col="Génération",genre ="essaim");factplot.set_xticklabels(rotation=-45)
plt.show()
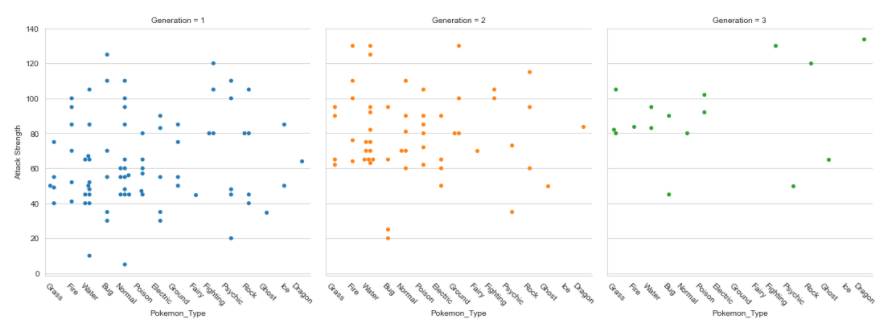 Diagramme factoriel: pour des classes catégorielles séparées
Notes rapides:
- plt.xticks (rotation = -45): cela ne fonctionne pas car il ne fait que tourner le dernier graphique
- Besoin d'utiliser: set_xticklabels





