
Con l'aumento della potenza di calcolo, ora possiamo selezionare algoritmi che eseguono calcoli molto intensivi. Uno di questi algoritmi è “foresta casuale”, di cui parleremo in questo post. Sebbene l'algoritmo sia molto popolare in diverse competizioni (come esempio, quelle che si svolgono su Kaggle), il risultato finale del modello è come una scatola nera e, perché, deve essere usato con prudenza.
prima di continuare, Ecco un esempio sull'importanza di selezionare il miglior algoritmo.
Importanza di selezionare l'algoritmo corretto
Ieri ho visto un film chiamato ” L'Era del Domani“. Ho adorato il concetto e il processo di pensiero che era alla base della trama di questo film. Permettetemi di riassumere la trama (senza commentare il climax, certo). A differenza di altri film di fantascienza, esta película gira en torno a un solo poder que se otorga a ambos lados (héroe y villano). El poder es la capacidad de reiniciar el día.
La raza humana está en guerra con una especie exótica llamada “Mimics”. Mimic se describe como una civilización mucho más evolucionada de una especie exótica. Toda la civilización Mimic es como un solo organismo completo. Tiene un cerebro central llamado “Omega” que controla a todos los demás organismos de la civilización. Permanece en contacto con todas las demás especies de la civilización cada segundo. “Alpha” es la principal especie guerrera (como el sistema nervioso) de esta civilización y toma el mando de “Omega”. “Omega” tiene el poder de reiniciar el día en cualquier momento.
Ora, Usiamo il cappello di un analista predittivo per analizzare questa trama. Se un sistema ha la capacità di riavviare il giorno in qualsiasi momento, userà questo potere ogni volta che muore una delle sue specie guerriere. E, perché, non ci sarà una guerra unica, quando una qualsiasi delle specie guerriere (alfa) morirà davvero, e il cervello “Omega” proverà ripetutamente lo scenario migliore per massimizzare la morte della razza umana e limitare il numero di morti di alfa (specie guerriere) a zero ogni giorno. Si può immaginare questo come “IL MIGLIORE” algoritmo predittivo mai creato. È letteralmente impossibile sconfiggere un tale algoritmo.
Torniamo ora a “Foreste casuali” usando un caso di studio.
Argomento di studio
Di seguito viene mostrata una distribuzione dei redditi annuali Gini Coefficiente in diversi paesi:
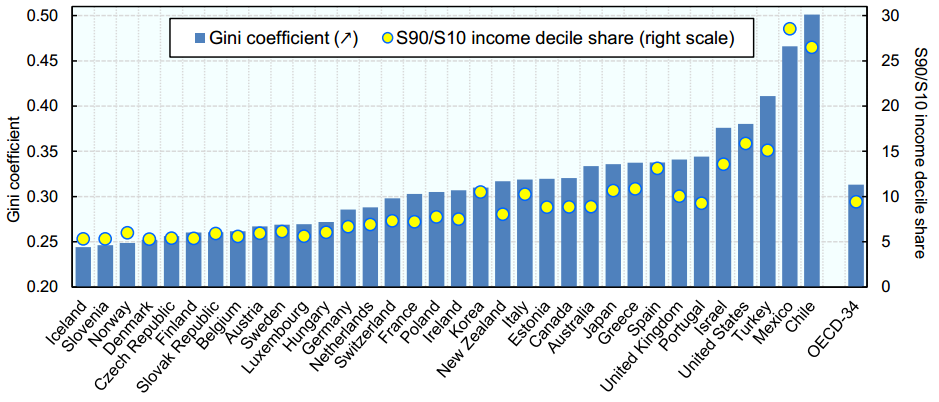
Il Messico ha il secondo coefficiente di Gini più alto e, perché, presenta una segregazione molto elevata nei redditi annuali tra ricchi e poveri. Il nostro compito è creare un algoritmo predittivo preciso per stimare il livello di reddito annuale di ogni individuo in Messico. Le fasce di reddito sono le seguenti:
1. Meno di $ 40,000
2. $ 40 000 – 150 000
3. Più di $ 150 000
Di seguito sono riportate le informazioni disponibili per ogni individuo:
1. Età, 2. Genere, 3. Massimo titolo di studio ottenuto, 4. Lavorare nel settore, 5. Residenza in Metropolitana / Non Metropolitana
Dobbiamo ideare un algoritmo per fornire una previsione precisa per un individuo che ha le seguenti caratteristiche:
1. Età: 35 anni, 2, Genere: Maschile, 3. Massimo titolo di studio ottenuto: Diploma, 4. Industria: Manifattura, 5. Residenza: Metropolitana
In questo post parleremo solo di foresta casuale per fare questa previsione.
L'algoritmo Random Forest
La foresta casuale è come un algoritmo di bootstrap con il modello ad albero decisionale (CARRELLO). Diciamo che abbiamo 1000 osservazioni nell'intera popolazione con 10 variabili. La foresta casuale tenta di costruire più modelli CART con campioni diversi e variabili iniziali diverse. Come esempio, sarà necessario un campione casuale di 100 osservazioni e 5 variabili iniziali scelte a caso per costruire un modello CART. Ripeterà la procedura (Diciamo) 10 volte e successivamente farà una previsione finale su ciascuna osservazione. La previsione finale è una funzione di ciascuna previsione. Questa previsione finale può essere semplicemente la media di ciascuna previsione.
Tornare al caso di studio
Disclaimer: i numeri di questo post sono illustrativi
Il Messico dispone di una popolazione di 118 MILLIMETRO. Digamos que el algoritmo Random Forest recoge 10k de observaciones con solo una variabileIn statistica e matematica, un "variabile" è un simbolo che rappresenta un valore che può cambiare o variare. Esistono diversi tipi di variabili, e qualitativo, che descrivono caratteristiche non numeriche, e quantitativo, che rappresentano quantità numeriche. Le variabili sono fondamentali negli esperimenti e negli studi, poiché consentono l'analisi delle relazioni e dei modelli tra elementi diversi, facilitare la comprensione di fenomeni complessi.... (per semplificare) para construir cada modelo CART. Totale, estamos viendo el modelo de 5 CART que se está construyendo con diferentes variables. En un obstáculo de la vida real, tendrá más muestras de población y diferentes combinaciones de variables de entrada.
Bandas salariales:
Gruppo musicale 1: Meno di $ 40,000
Gruppo musicale 2: $ 40 000 – 150 000
Gruppo musicale 3: più di $ 150,000
A continuación se muestran los resultados de los 5 modelos CART diferentes.
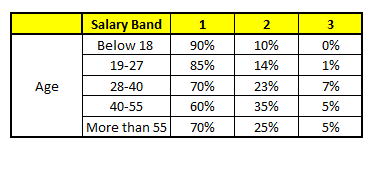
CARRITO 1: Edad variable
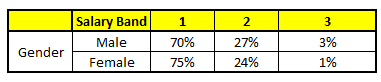
CARRITO 2: Género variable
CARRITO 3: Educación variable
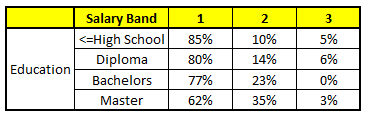
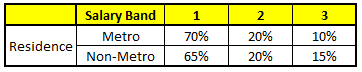
CARRITO 4: Residencia variable
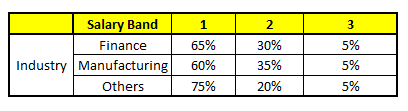
CARRITO 5: Industria variable
Usando estos 5 modelos CART, necesitamos arrivare a un unico conjunto de probabilidad para pertenecer a cada una de las clases salariales. Per semplificare, solo tomaremos una media de probabilidades en este estudio de caso. Aparte de la media simple, además consideramos el método de voto para llegar a el pronóstico final. Para llegar a el pronóstico final, ubiquemos el siguiente perfil en cada modelo CART:
1. Età: 35 anni, 2, Genere: Maschile, 3. Massimo titolo di studio ottenuto: Diploma, 4. Industria: Manifattura, 5. Residenza: Metropolitana
Para cada uno de estos modelos CART, a continuación se muestra la distribución entre las bandas salariales:
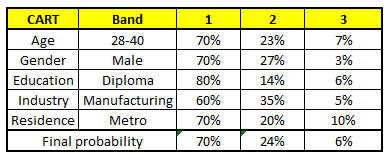
La probabilidad final es simplemente el promedio de la probabilidad en las mismas bandas salariales en diferentes modelos CART. Como puede ver en este análisis, C'è un 70% de posibilidades de que este individuo caiga en la clase 1 (meno di $ 40,000) y alrededor del 24% de posibilidades de que el individuo caiga en la clase 2.
Note finali
El bosque aleatorio proporciona predicciones mucho más precisas en comparación con los modelos simples CART / CHAID o regressione in molti scenari. Questi casi generalmente dispongono di un gran numero di variabili predittive e di un campione di dimensioni enormi. Ciò è dovuto al fatto che cattura la varianza di varie variabili di input contemporaneamente e permette a un gran numero di osservazioni di partecipare alla previsione. In alcuni dei prossimi post, Parleremo più dettagliatamente dell'algoritmo e di come costruire una foresta casuale semplice in R.





