
Introdução
O tempo é o fator mais crítico para decidir se uma empresa vai subir ou descer. É por isso que vemos vendas em lojas e plataformas de comércio eletrônico alinhadas aos festivais.. Essas empresas analisam anos de dados de gastos para entender o melhor momento para abrir as portas e ver um aumento nos gastos do consumidor..
Mas, Como você pode, como cientista de dados, realizar esta análise? Não te preocupes, você não precisa construir uma máquina do tempo! A modelagem de séries temporais é uma técnica poderosa que atua como um portal para entender e prever tendências e padrões..
Mas mesmo um modelo de Série temporalUma série temporal é um conjunto de dados coletados ou medidos em momentos sucessivos, geralmente em intervalos de tempo regulares. Esse tipo de análise permite identificar padrões, Tendências e ciclos nos dados ao longo do tempo. Sua aplicação é ampla, abrangendo áreas como economia, Meteorologia e saúde pública, facilitando a previsão e a tomada de decisões com base em informações históricas.... Tem diferentes facetas. A maioria dos exemplos que vemos na web trata de séries temporais univariadas. Infelizmente, casos de uso do mundo real não funcionam assim. Existem várias variáveis em jogo, e lidar com todos eles ao mesmo tempo é onde um cientista de dados ganhará coragem.
Neste artigo, vamos entender o que é uma série temporal multivariada e como lidar com ela. Também faremos um estudo de caso e o implementaremos em Python para fornecer a você uma compreensão prática do tópico..
Tabela de conteúdo
- Séries temporais univariadas versus multivariadas
- Séries temporais univariadas
- Séries temporais multivariadas
- Gestão de uma série temporal multivariada: regressão automática de vetor (ONDE)
- Por que precisamos de VAR?
- Estacionariedade em uma série temporal multivariada
- Divisão de validação de trem
- Implementação Python
1. Séries temporais univariadas versus multivariadas
Este artigo pressupõe alguma familiaridade com séries temporais univariadas, suas propriedades e as várias técnicas usadas para previsão. Como este artigo se concentrará em séries temporais multivariadas, Eu sugiro que você reveja os seguintes artigos que servem como uma boa introdução para séries temporais univariadas:
Mas vou dar uma rápida visão geral do que é uma série temporal univariada., antes de entrar nos detalhes de uma série temporal multivariada. Vamos examiná-los um por um para entender a diferença.
1.1 Séries temporais univariadas
Uma série temporal univariada, como o nome sugere, É uma série com um variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... dependente do tempo.
Por exemplo, dê uma olhada no conjunto de dados de amostra abaixo que consiste nos valores de temperatura (cada hora), Durante o último 2 anos. Aqui, temperatura é a variável dependente (dependente do tempo).
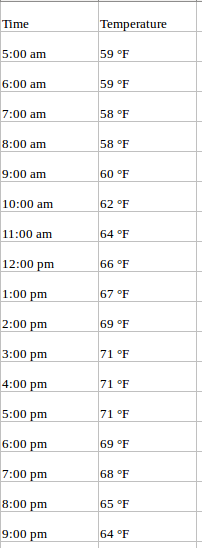
Se formos solicitados a prever a temperatura para os próximos dias, vamos olhar para os valores anteriores e tentar medir e extrair um padrão. Notaríamos que a temperatura é mais baixa pela manhã e à noite, enquanto atinge o pico à tarde. O que mais, se você tem dados dos últimos anos, você notará que está mais frio durante os meses de novembro a janeiro, embora seja comparativamente mais quente de abril a junho.
Essas observações nos ajudarão a prever valores futuros.. Você percebeu que usamos apenas uma variável (a temperatura do último 2 anos)? Portanto, isso é chamado de análise / Previsão de série temporal univariada.
1.2 Séries temporais multivariadas (MTS)
Uma série temporal multivariada tem mais de uma variável dependente do tempo. Cada variável depende não apenas de seus valores anteriores, também tem alguma dependência de outras variáveis. Esta dependência é usada para prever valores futuros. Parece complicado? Deixe-me explicar.
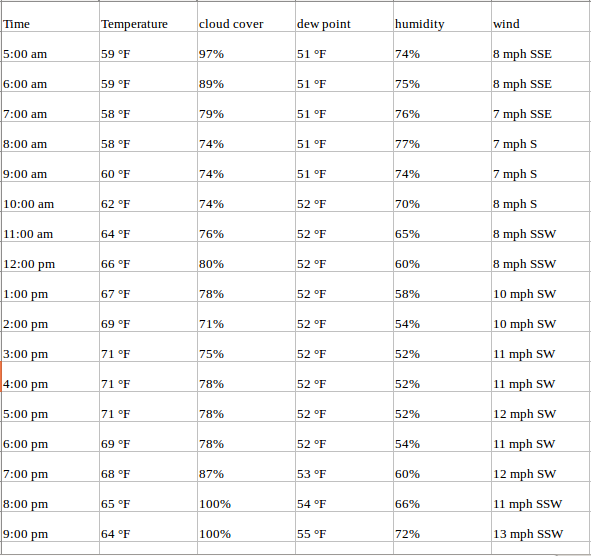
Considere o exemplo acima. Agora, suponha que nosso conjunto de dados inclua a porcentagem de transpiração, ponto de condensação da água, velocidade do vento, a porcentagem de cobertura de nuvens, etc. junto com o valor da temperatura dos últimos dois anos. Neste caso, múltiplas variáveis devem ser consideradas para prever a temperatura de maneira ideal. Uma série como essa se enquadraria na categoria de séries temporais multivariadas.. Abaixo está uma ilustração deste:
Agora que entendemos como é uma série temporal multivariada, vamos entender como podemos usá-lo para construir uma previsão.
2. Gestão de uma série temporal multivariada – ONDE
Nesta secção, Vou apresentar a você um dos métodos mais usados para previsão de série temporal multivariada: Regressão automática de vetor (ONDE).
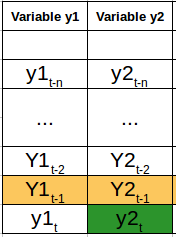
Em um modelo VAR, cada variável é uma função linear dos valores anteriores de si mesma e dos valores anteriores de todas as outras variáveis. Para explicar isso de uma maneira melhor, Vou usar um exemplo visual simples:
Temos duas variáveis, y1 e y2. Precisamos prever o valor dessas duas variáveis no tempo t, a partir dos dados fornecidos para os n valores passados. Para simplificar, Eu considerei o valor do atraso como 1.
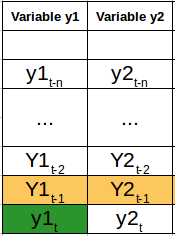
Para calcular y1
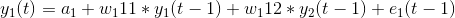
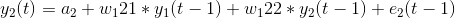
Aqui,
- a1 e a2 são os termos constantes,
- w11, w12, w21 e w22 são os coeficientes,
- e1 e e2 são os termos de erro
Essas equações são semelhantes à equação de um processo AR. Uma vez que o processo AR é usado para dados de série temporal univariados, valores futuros são combinações lineares de seus próprios valores passados apenas. Considere o processo de AR (1):
e
Neste caso, nós temos apenas uma variável – e, um termo constante – uma, um termo de erro – e, e um coeficiente – C. Para acomodar os vários termos de variáveis em cada equação para VAR, vamos usar vetores. Podemos escrever as equações (1) e (2) da seguinte forma:
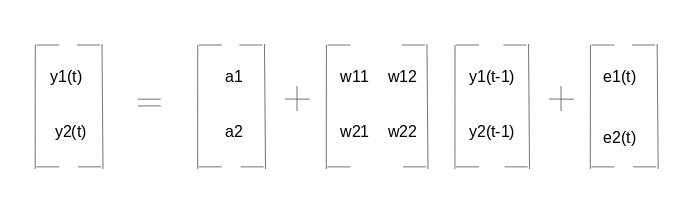
As duas variáveis são y1 e y2, seguido por uma constante, um coeficiente métrico, um valor de atraso e uma métrica de erro. Esta é a equação vetorial para um processo VAR (1). Para um processo VAR (2), outro termo vetorial será adicionado por tempo (t-2) à equação para generalizar para defasagens:
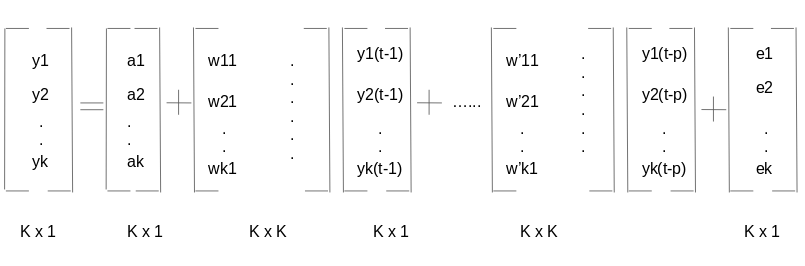
A equação acima representa um processo VAR (p) com variáveis y1, y2 ... yk. O mesmo pode ser escrito como:
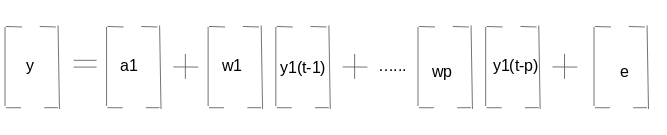
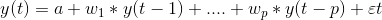
O termo εt na equação representa o vetor multivariado de ruído branco. Para uma série temporal multivariada, et deve ser um vetor aleatório contínuo que satisfaça as seguintes condições:
- E (et) = 0
O valor esperado para o vetor de erro é 0 - E (et1, et2‘) = σ12
Valor esperado de εt y εt'É o desvio padrão da série
3. Por que precisamos de VAR?
Lembre-se do exemplo de previsão de temperaturas temperadas que vimos anteriormente. Pode-se argumentar que será tratado como uma série univariada múltipla. Podemos resolvê-lo usando métodos de previsão univariados simples como AR. Já que o objetivo é prever a temperatura, podemos apenas remover as outras variáveis (exceto temperatura) e ajustar um modelo para a série univariada restante.
Outra ideia simples é prever os valores de cada série individualmente usando as técnicas que já conhecemos.. Isso tornaria o trabalho extremamente fácil!! Então, Por que devo aprender outra técnica de previsão? Este assunto já não é complicado o suficiente?
Das equações acima (1) e (2), é claro que cada variável está usando os valores anteriores de cada variável para fazer as previsões. Ao contrário de AR, VAR é capaz de entender e usar a relação entre várias variáveis.. Isso é útil para descrever o comportamento dinâmico dos dados e também fornece melhores resultados de previsão.. O que mais, implementar VAR é tão simples quanto usar qualquer outra técnica univariada (o que você verá na última seção).
4. Estacionariedade de uma série temporal multivariada
Sabemos, a partir do estudo do conceito univariado, que uma série temporal estacionária nos dará, na maioria dos casos, um melhor conjunto de previsões. Se você não está familiarizado com o conceito de estacionariedade, leia este artigo primeiro: Uma introdução suave para lidar com séries temporais não estacionárias.
Para resumir, para uma dada série temporal univariada:
e
A série é considerada estacionária se o valor de | c | <1. Agora, lembre-se da equação do nosso processo VAR:
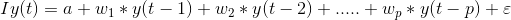
Observação: Eu é a matriz de identidade.
Representa a equação em termos de Operadores de atraso, tenho:
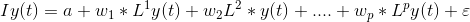
Pegando todos os termos e
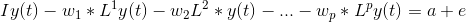
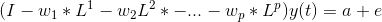
O coeficiente de y
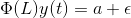
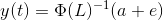
Para uma série ser estacionária, os autovalores de | Phi (eu)-1| deve ser menor que 1 no módulo. Isso pode parecer complicado, dado o número de variáveis na derivação. Essa ideia foi explicada por um exemplo numérico simples no vídeo a seguir. Eu recomendo que você assista para solidificar seu entendimento:
Semelhante ao teste Augmented Dickey-Fuller para séries univariadas, temos o teste de Johansen para verificar a estacionariedade de quaisquer dados de série temporal multivariada. Veremos como realizar o teste na última seção deste artigo.
5. Divisão de validação de trem
Se você já trabalhou com dados de série temporal univariados, conheça os conjuntos de validação de trens. A ideia de criar um conjunto de validação é analisar o desempenho do modelo antes de usá-lo para fazer previsões..
Criar um conjunto de validação para problemas de série temporal é complicado porque temos que levar em consideração o componente de tempo. Não se pode usar diretamente o train_test_split o k-fold validação, pois isso vai interromper o padrão da série. O conjunto de validação deve ser criado com os valores de data e hora em mente.
Suponha que temos que prever a temperatura, ponto de condensação da água, a porcentagem de nuvens, etc. pelos próximos dois meses usando dados dos últimos dois anos. Um método possível é manter os dados dos últimos dois meses de lado e treinar o modelo no 22 meses restantes.
Uma vez que o modelo foi treinado, podemos usá-lo para fazer previsões sobre o conjunto de validação. Com base nessas previsões e nos valores reais, podemos verificar o desempenho do modelo e as variáveis para as quais o modelo não teve um desempenho tão bom. E para fazer a previsão final, use todo o conjunto de dados (combinar conjuntos de trem e validação).
6. Implementação Python
Nesta secção, vamos implementar o modelo Vector AR em um conjunto de dados de brinquedo. Usei o conjunto de dados de qualidade do ar para isso e você pode baixá-lo em aqui.
#importar pacotes necessários
importar pandas como pd
import matplotlib.pyplot as plt
% matplotlib inline

#read the data
df = pd.read_csv("AirQualityUCI.csv", parse_dates =[['Date', 'Tempo']])

#verifique os dtypes
df.dtypes
Objeto Date_Time
CO(GT)            int64
PT08.S1(CO)       int64
NMHC(GT)          int64
C6H6(GT)          int64
PT08.S2(NMHC)     int64
NOx(GT)           int64
PT08.S3(NOx)      int64
NO2(GT)           int64
PT08.S4(NO2)      int64
PT08.S5(O3)       int64
T int64
RH int64
AH int64
dtype: objeto
O tipo de dados do Data e hora a coluna é objeto e temos que mudar para data e hora. O que mais, para preparar os dados, precisamos do índiceo "Índice" É uma ferramenta fundamental em livros e documentos, que permite localizar rapidamente as informações desejadas. Geralmente, é apresentado no início de um trabalho e organiza os conteúdos de forma hierárquica, incluindo capítulos e seções. Sua correta preparação facilita a navegação e melhora a compreensão do material, tornando-se um recurso essencial para estudantes e profissionais de várias áreas.... Ter data e hora. Siga os seguintes comandos:
df['Date_Time'] = pd.to_datetime(df.Date_Time , format ="%d /% m /% Y% H.% M.% S")
data = df.drop(['Date_Time'], eixo = 1)
data.index = df.Date_Time
A próxima etapa é lidar com os valores ausentes. Uma vez que os valores ausentes nos dados são substituídos por um valor -200, teremos que imputar o valor ausente com um número melhor. Considere isto: se o valor do ponto de orvalho atual estiver faltando, podemos supor com segurança que será próximo ao valor da hora anterior. Tem sentido, verdade? Aqui, Vou imputar -200 com o valor anterior.
Você pode escolher substituir o valor usando a média de alguns valores anteriores, ou o valor na mesma hora do dia anterior (você pode compartilhar seu (s) ideia (s) para imputar valores ausentes na seção de comentários abaixo).
#tratamento de valor ausente
cols = data.columns
para j em cols:
    para eu no alcance(0,len(dados)):
       se dados[j][eu] == -200:
           dados[j][eu] = dados[j][i-1]

#verificando a estacionariedade
de statsmodels.tsa.vector_ar.vecm import coint_johansen
# visto que o teste funciona apenas para 12 variáveis, Eu deixei cair aleatoriamente
# na próxima iteração, Eu largaria outro e verificaria os autovalores
johan_test_temp = data.drop([ 'CO(GT)'], eixo = 1)
coint_johansen(johan_test_temp,-1,1).ter
Abaixo está o resultado do teste:
variedade([ 0.17806667,  0.1552133 ,  0.1274826 ,  0.12277888,  0.09554265,
        0.08383711,  0.07246919,  0.06337852,  0.04051374,  0.02652395,
        0.01467492,  0.00051835])
Agora podemos prosseguir e criar o conjunto de validação para ajustar o modelo e testar o desempenho do modelo:
#criando o trem e o conjunto de validação
train = data[:int(0.8*(len(dados)))]
válido = dados[int(0.8*(len(dados))):]

#ajustar o modelo
de statsmodels.tsa.vector_ar.var_model import VAR

modelo = VAR(endog = treinar)
model_fit = model.fit()

# fazer previsões na validação
prediction = model_fit.forecast(model_fit.y, passos = len(válido))
As previsões são na forma de uma matriz, onde cada lista representa as previsões na linha. Vamos transformar isso em um formato mais apresentável.
#conversão de previsões em dataframe
pred = pd.DataFrame(índice = intervalo(0,len(predição)),colunas =[cols])
para j no intervalo(0,13):
    para eu no alcance(0, len(predição)):
       pred.iloc[eu][j] = previsão[eu][j]

#verificar rmse
para eu nas cols:
    imprimir('rmse value for', eu, 'is : ', sqrt(mean_squared_error(pred[eu], válido[eu])))
Saída de código anterior:
valor rmse para CO(GT) é :  1.4200393103392812
valor rmse para PT08.S1(CO) é :  303.3909208229375
valor rmse para NMHC(GT) é :  204.0662895081472
valor rmse para C6H6(GT) é :  28.153391799471244
valor rmse para PT08.S2(NMHC) é :  6.538063846286176
valor rmse para NOx(GT) é :  265.04913993413805
valor rmse para PT08.S3(NOx) é :  250.7673347152554
valor rmse para NO2(GT) é :  238.92642219826683
valor rmse para PT08.S4(NO2) é :  247.50612831072633
valor rmse para PT08.S5(O3) é :  392.3129907890131
valor rmse para T é :  383.1344361254454
valor rmse para RH é :  506.5847387424092
valor rmse para AH é :  8.139735443605728
Após o teste no conjunto de validação, vamos encaixar o modelo no conjunto de dados completo
#fazer previsões finais
modelo = VAR(even = data)
model_fit = model.fit()
yhat = model_fit.forecast(model_fit.y, passos = 1)
imprimir(yhat)
Notas finais
Antes de começar este artigo, a ideia de trabalhar com uma série temporal multivariada parecia assustadora em seu escopo. É um assunto complexo, então tome seu tempo para entender os detalhes. A melhor maneira de aprender é praticar, então espero que a implementação python acima seja útil para você.
Eu recomendo que você use essa abordagem em um conjunto de dados de sua escolha. Isso solidificará ainda mais sua compreensão desse tópico complexo, mas muito útil.. Se você tiver alguma sugestão ou dúvida, compartilhe na seção de comentários.





