
Desbloquear um novo mundo com o algoritmo de regressão vetorial de suporte
As máquinas de vetores de suporte (SVM) são utilizadas de forma popular e extensa para problemas de classificação em aprendizagem automática. Muitas vezes baseei-me nisso não só em projectos de aprendizagem automática, mas também quando quero um resultado rápido num hackathon.
Mas SVM para análise de regressão? Nem sequer tinha considerado essa possibilidade durante algum tempo! E mesmo agora, quando menciono “Regressão vetorial de suporte” aos iniciantes em aprendizagem automática, frequentemente vejo uma expressão de perplexidade. eu entendo: a maioria dos cursos e especialistas nem sequer mencionam a regressão vetorial de suporte (SVR) como un algoritmo de aprendizaje automático.
Pero SVR tiene sus usos, como verá en este tutorial. Primeiro entenderemos rapidamente qué es SVM, antes de sumergirnos en el mundo de la regresión vectorial de soporte y cómo implementarlo em Python.
Observação: Puede obter informações sobre las máquinas de vectores de soporte y los problemas de regresión en formato de curso aquí (É grátis!):
Esto es lo que cubriremos en este tutorial de regresión de vectores de soporte:
- ¿Qué es una máquina de vectores de soporte (SVM)?
- Hiperparámetros del algoritmo de máquina de vectores de soporte
- Introducción a la regresión de vectores de soporte (SVR)
- Implementación de la regresión de vectores de soporte en Python
¿Qué es una máquina de vectores de soporte (SVM)?
Então, O que é exatamente uma Máquina de Vetores de Suporte (Support Vector Machine) (SVM)? Começaremos por entender o SVM em termos simples. Digamos que temos um diagrama com duas classes de etiquetas, como mostrado a seguir figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas....:
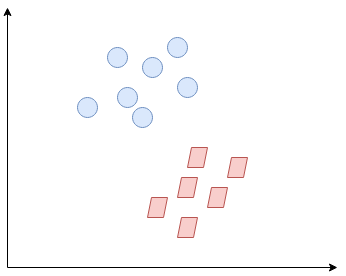
Consegue decidir qual será a linha de separação?? Pode-lhe ter ocorrido isto:
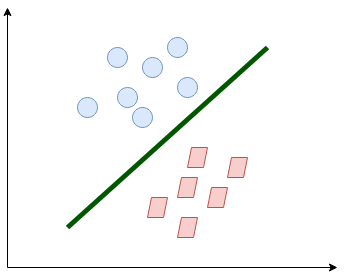
A linha separa bastante bem as classes. Isto é essencialmente o que o SVM faz: separação simples de classes. Agora, quais são os dados?
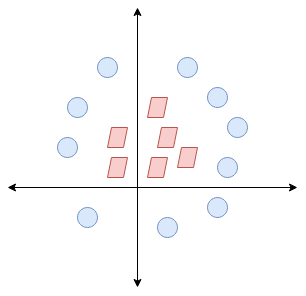
Aqui, não temos uma linha simples que separe estas duas classes. Portanto, vamos expandir a nossa dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e... e introduzir uma nova dimensão ao longo do eixo z. Agora podemos separar estas duas classes:
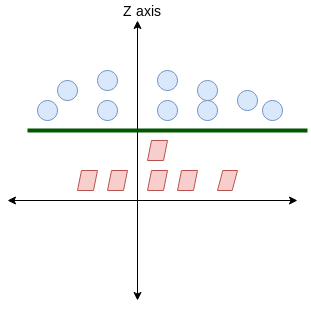
Quando transformamos esta linha de volta para o plano original, ela é atribuída ao limite circular como mostrado aqui:
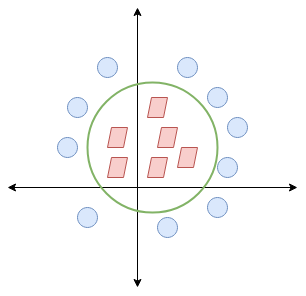
¡Esto es exactamente lo que hace SVM! Intenta encontrar una línea / hiperplano (en un espacio multidimensional) que separe estas dos classes. Depois classifica o novo ponto na função de si se encontra no lado positivo o negativo do hiperplano segundo as classes a predecir.
Hiperparámetros del algoritmo de máquina de vectores de soporte (SVM)
Hay algunos parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... importantes de SVM que deve conhecer antes de continuar:
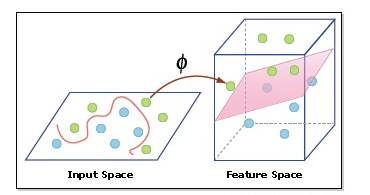
- Núcleo: Un kernel nos ayuda a encontrar un hiperplano en el espacio dimensional superior sin aumentar el costo computacional. Em geral, el costo computacional aumentará si aumenta la dimensión de los datos. Este aumento de dimensión es necesario cuando no podemos encontrar un hiperplano de separación en una dimensión determinada y debemos movernos en una dimensión superior:
- Hiperplano: Esta é basicamente uma linha de separação entre duas classes de dados em SVM. Mas na regressão de vetores de suporte, esta é a linha que será usada para prever a saída contínua
- Limite de decisão: Um limite de decisão pode ser considerado como uma linha de demarcação (para simplificar) de um lado da qual estão os exemplos positivos e do outro lado estão os exemplos negativos. Nesta mesma linha, os exemplos podem ser classificados como positivos ou negativos. Este mesmo conceito de SVM será aplicado também na regressão de vetores de suporte
Para compreender SVM desde o início, recomendo este tutorial: Compreender o algoritmo de Support Vector Machine (SVM) a partir de exemplos.
Introducción a la regresión de vectores de soporte (SVR)
A regressão de vetores de suporte (SVR) utiliza o mesmo princípio que o SVM, mas para problemas de regressão. Vamos dedicar alguns minutos a compreender a ideia por trás do SVR.
A ideia por trás da regressão de vetores de suporte
O problema da regressão é encontrar uma função que se aproxime do mapeamento de um domínio de entrada para números reais com base numa amostra de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina..... Então agora vamos aprofundar e entender como funciona realmente o SVR.
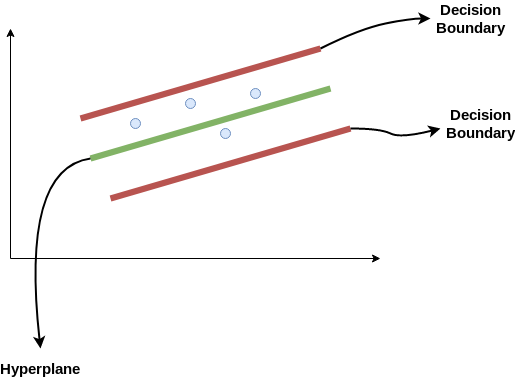
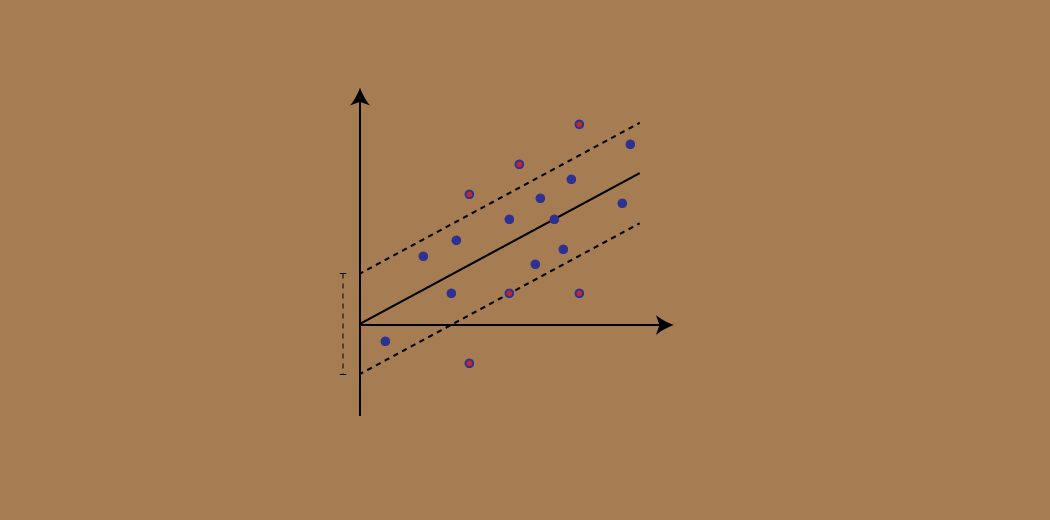
Considere estas duas linhas vermelhas como o limite de decisão e a linha verde como o hiperplano. Nosso objetivo, quando estamos a avançar com o SVR, basicamente considera-se os pontos que estão dentro do limite de decisão. Nuestra mejor línea de ajuste es el hiperplano que tiene un número máximo de puntos.
Lo primero que entenderemos es cuál es el límite de decisión (¡la línea roja de peligro arriba!). Considere que estas líneas están a cualquier distancia, Digamos “uma”, del hiperplano. Então, estas son las líneas que dibujamos a la distancia '+ a’ y '-a’ del hiperplano. Esta 'a’ en el texto se conoce básicamente como épsilon.
Suponiendo que la ecuación del hiperplano es la siguiente:
Y = wx+b (equação do hiperplano)
Então las ecuaciones de límite de decisão se convierten en:
wx+b= +a

wx+b= -a
Portanto, cualquier hiperplano que satisfaga nuestra RVS debería satisfacer:
-uma < E- wx+b < +uma
Nuestro principal objetivo aquí es decidir un límite de decisión a una distancia ‘a’ del hiperplano original, de modo que los puntos de datos más cercanos al hiperplano o los vectores de soporte estén dentro de esa línea límite.
Portanto, vamos a tomar solo aquellos puntos que están dentro del límite de decisión y tienen la menor tasa de error, o están dentro del MargemMargem é um termo usado em uma variedade de contextos, como contabilidade, Economia e impressão. Em contabilidade, refere-se à diferença entre receitas e custos, que permite avaliar a rentabilidade de um negócio. No domínio da publicação, A margem é o espaço em branco ao redor do texto em uma página, que facilita a leitura e proporciona uma apresentação estética. Seu correto manejo é essencial.. de Tolerancia. Esto nos da un modelo de mejor ajuste.
Implementación de regresión vectorial de soporte (SVR) e Python
¡Es hora de ponernos nuestros sombreros de codificación! Nesta secção, entenderemos el uso de la regresión de vectores de soporte con la ayuda de un conjunto de datos. Aqui, tenemos que predecir el salario de un empleado dadas algunas variables independientes. Um projeto clássico de análise de recursos humanos!
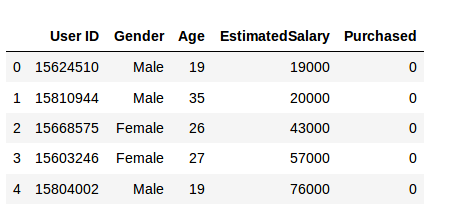
Paso 1: importar as bibliotecas
Paso 2: ler o conjunto de dados
Paso 3: Escalonamento de características
Um conjunto de dados do mundo real contém características que variam em magnitudes, unidades e alcance. Sugeriria realizar o padronizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos.... quando a escala de uma característica é irrelevante ou enganosa.
O Escalonamento de Características basicamente ajuda a normalizar os dados dentro de um intervalo específico. Normalmente, vários tipos de classes comuns contêm a função de escalonamento de características para que realizem o escalonamento de características automaticamente. Porém, a classe SVR não é um tipo de classe de uso comum, portanto, deveríamos realizar o escalonamento de características com Python.
Paso 4: ajuste de SVR ao conjunto de dados
O kernel é a característica mais importante. Hay muchos tipos de núcleos: lineares, gaussianos, etc. Cada uno se utiliza segundo el conjunto de datos. Para mais informações sobre este, lea esto: Soporte Vector Machine (SVM) em Python e R
Paso 5. Predecir un nuevo resultado
Então, la predicción para y_pred (6, 5) será 170,370.
Paso 6. Visualización de los resultados de SVR (para una resoluçãoo "resolução" refere-se à capacidade de tomar decisões firmes e atingir metas estabelecidas. Em contextos pessoais e profissionais, Envolve a definição de metas claras e o desenvolvimento de um plano de ação para alcançá-las. A resolução é fundamental para o crescimento pessoal e o sucesso em várias áreas da vida, pois permite superar obstáculos e manter o foco no que realmente importa.... más alta y una curva más suave)
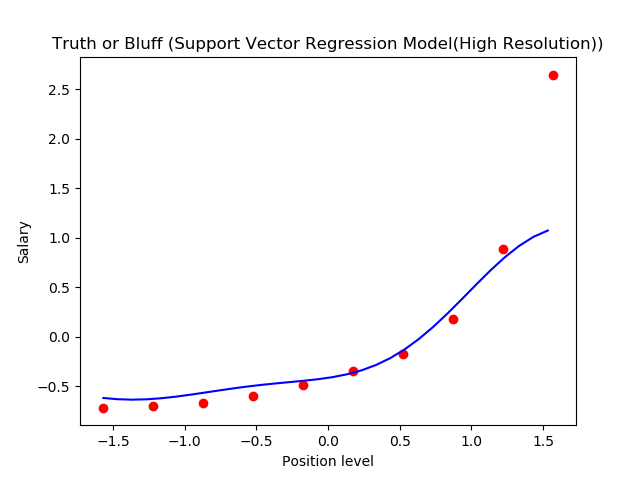
Esto es lo que obtenemos como salida: la línea de mejor ajuste que tiene un número máximo de puntos. ¡Bastante preciso!
Notas finais
Podemos pensar en la regresión de vectores de soporte como la contraparte de SVM para los problemas de regresión. SVR reconoce la presencia de no linealidad en los datos y proporciona un modelo de predicción competente.
Me encantaría escuchar sus pensamientos e ideas sobre el uso de SVR para el análisis de regresión. ¡Conéctese conmigo en la sección de comentarios a continuación e ideemos!





