
Esta postagem foi lançada como parte do Data Science Blogathon.
Você acha IA e ML interessantes??
Você tem interesse em se tornar um engenheiro de aprendizado de máquina?? Você aprendeu linguagens de programação como Python ou R, mas tem dificuldade em seguir em frente? (Isso acontece principalmente no caso de autodidatas). Você acha palavras como Estatísticas intimidantes?, Probabilidade e regressão? É absolutamente compreensível se sentir assim, especialmente se você vem de uma formação não técnica. Mas existe uma solução para isso. E isso é …. para iniciar. Lembrar, se nunca começar, você nunca cometerá erros e talvez nunca aprenda. Então comece pequeno.
Regressão linear simples
Quando usamos LR?
Vamos criar um modelo simples de aprendizado de máquina usando regressão linear. Mas antes de passar para a parte de codificação, vamos dar uma olhada no básico e na lógica por trás disso. A regressão é usada no algoritmo de aprendizado de máquina supervisionado, qual é o algoritmo mais usado no momento. El análisis de regresión es un método en el que establecemos una vinculación entre una variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... dependente (e) e uma variável independente (x); o que nos permite prever e prever os resultados. Você se lembra de resolver equações como y = mx + c dos seus dias de escola? Se então, Parabéns. Você já conhece a regressão linear simples. Sim, não é assim, nada difícil de aprender.
Vamos considerar um exemplo popular. O número de horas investidas no estudo e as notas obtidas no exame. Nesta circunstância, as notas obtidas dependem da quantidade de horas que o aluno investe nos estudos, por isso, as notas obtidas são a variável dependente y e o número de horas é a variável independente x. O objetivo é desenvolver um modelo que nos ajude a prever as notas obtidas para um novo número de horas.. Vamos conseguir isso usando a regressão linear.
Para ser bem claro sobre este conceito, vamos considerar outro exemplo. Em um conjunto de dados com a quantidade de calorias consumidas e o peso ganho, o peso ganho depende das calorias consumidas por uma pessoa. Por isso, o peso ganho é a variável dependente y e o número de calorias é a variável independente x.
y = mx + c é a equação da linha de regressão que melhor se ajusta aos dados e, as vezes, além disso, é representado como y = b0 + b1X. Aqui,
y é a variável dependente, nesta circunstância, as notas obtidas.
x é a variável independente, nesta circunstância, o número de horas.
mo b1 é a inclinação da linha de regressão e o coeficiente da variável independente.
c o b0 é a intersecção da linha de regressão.
A lógica é calcular a inclinação (m) e interceptar (c) com os dados disponíveis e então seremos capazes de calcular o valor de y para qualquer valor de x.
Pacotes e códigos Python necessários
Agora, Como realizar regressão linear em python? Precisamos importar alguns pacotes, a saber NumPy trabalhar com matrizes, Sklearn para realizar a regressão linear, e Matplotlib para traçar a linha de regressão e os gráficos. Observe que é quase impossível ter conhecimento de todos os pacotes e bibliotecas em Python, especialmente para iniciantes. Por isso, é recomendado continuar procurando o pacote certo quando necessário para uma tarefa. É mais fácil lembrar de usar pacotes com experiência prática envolvida, em vez de apenas ler teoricamente a documentação disponível sobre eles.
Seguindo para a parte de codificação. O primeiro passo é importar os pacotes necessários.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
Considerando que este é o primeiro modelo de aprendizado de máquina deles, vamos eliminar algumas complicações, tomando uma amostra muito pequena, en lugar de utilizar datos de una base de dadosUm banco de dados é um conjunto organizado de informações que permite armazenar, Gerencie e recupere dados com eficiência. Usado em várias aplicações, De sistemas corporativos a plataformas online, Os bancos de dados podem ser relacionais ou não relacionais. O design adequado é fundamental para otimizar o desempenho e garantir a integridade das informações, facilitando assim a tomada de decisão informada em diferentes contextos.... grande. Isso também ajudará a ver claramente o resultado nos gráficos e a apreciar o conceito de forma eficaz..
xpoints = np.array ([10, 11, 12, 13, 14, 15]) .reforma (-1,1)
ypoints = np.array ([53, 52, 60, 63, 72, 70])
Observe que estamos remodelando o xpoints tem uma coluna e muitas linhas. O preditor (x) deve ser uma matriz de matrizes e a solução (e) pode ser uma matriz simples.
Uma variável Linreg é criado como uma instância de Regressão linear. Pode receber parâmetros opcionais. Eles não são necessários para este exemplo, então vamos ignorá-los. Como o nome sugere, a .encaixar() O método se ajusta ao modelo e é usado para estimar alguns dos parâmetros do modelo, o que significa que calcula o valor otimizado de myc usando os dados fornecidos.
linreg = LinearRegression()
linreg.fit(xpoints, ypoints)
.prever() O método é usado para obter a solução prevista usando o modelo e leva o preditor xpoints como um argumento.
y_pred = linreg.predict(xpoints)
Agora, imprimir y_pred e observe que os valores estão bem próximos de pontos. Se as respostas previstas e reais tiverem um valor próximo a, significa que o modelo é preciso. Em um caso ideal, os valores de resposta previstos e reais se sobreporiam.
O módulo pyplot da biblioteca Matplotlib foi importado como plt. Então podemos traçar facilmente os gráficos usando .dispersão() que leva xpoints e pontos como argumentos. Trace a solução real. A solução prevista é traçada usando.enredo() Função. O gráfico pode ser rotulado usando.xlabel e .Ylabel.
plt.scatter (x pontos, pontos e)
plt.plot (x pontos, y_pred)
plt.xlabel (“x pontos”)
plt.ylabel (“pontos e”)
plt.show ()
plt.show () muestra todos los objetos de figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... en este momento ativos.
Atributos .coef_ e .interceptar_ dá a inclinação, que também é o coeficiente de x, e a interseção de y. Isso significa que y = c = 8.80, aproximadamente, quando x = 0 e y = 4.22 (1) + 8.80 = 13.02 (aproximadamente) quando x = 1. Observe que na saída a interseção é escalar e o coeficiente é uma matriz.
imprimir(linreg.coef_)
imprimir(linreg.intercept_)
Nós construímos nosso modelo. Agora tente prever a solução y_new para um novo valor de preditor x_new = 16. Lá! Temos um modelo que pode prever a solução para qualquer preditor dado.
x_new = np.array ([16]) .reforma (-1,1)
y_new = linreg.predict (x_new)
imprimir (y_new)
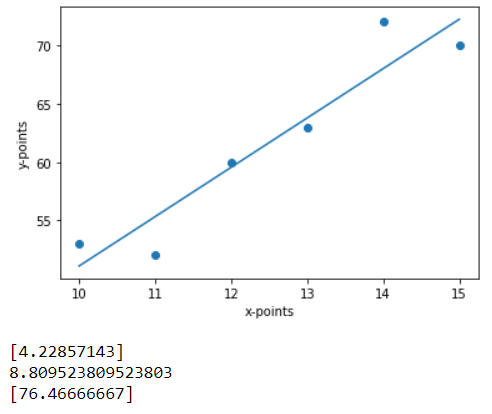
A imagem acima mostra como o resultado final pode ficar. As 3 saídas abaixo do gráfico são a solução para nosso Imprimir() afirmações. Então eles estão pendentes, intersecção e y_new respectivamente.
A equação da linha de regressão é y = 4,23x + 8,80. Então, de acordo com a equação, quando x = 16,
y = 4,23 * (16) + 8,80 = 76,48. A pequena diferença no cálculo deve-se às casas decimais.
Podemos usar .pontuação() método que mostra x e y como seus 2 argumentos para encontrar R2 ou o coeficiente de determinação. Melhor valor para R2 isto é 1.0 e também pode assumir valores negativos, já que o modelo pode ser pior. Um valor mais próximo de R2 uma 1.0 indica a eficiência do nosso modelo.
linreg.score(xpoints, ypoints)
Execute o código e você verá que o valor de R2 isto é 0,89, então a previsão do modelo é confiável.
Que segue?
Isso é tão simples quanto uma regressão linear. Não é a única maneira, mas me pareceu a maneira mais simples e fácil. Não pare aqui. Quando você se sentir confortável com isso, você pode ir um passo adiante e considerar um conjunto de dados maior. Como um exemplo, um arquivo CSV. Você precisará trabalhar com Pandas e pacotes NumPy nesse caso. A seguir, você pode testar um modelo de regressão logística linear ou múltipla. Continue aprendendo e praticando.
A mídia mostrada nesta postagem não é propriedade da DataPeaker e é usada a critério do autor.





