
Introdução:
Uma das etapas mais importantes como parte do pré-processamento de dados é detectar e lidar com outliers, ya que pueden afectar negativamente el análisis estadístico y el proceso de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... de un algoritmo de aprendizaje automático, resultando em menor precisão.
1. O que são outliers? 🤔
Todos nós já ouvimos falar do idioma 'estranho, o que significa algo incomum em comparação com outros em um grupo.
de forma similar, um outlier é uma observação em um determinado conjunto de dados que está longe do resto das observações. Isso significa que um outlier é muito maior ou menor do que os valores restantes no conjunto..
2. Por que eles ocorrem?
Um outlier pode ocorrer devido à variabilidade nos dados, ou devido a um erro experimental / erro humano.
Pode indicar erro experimental ou grande assimetria nos dados (distribuição de cola pesada).
3. Aquele afeto?
Nas estatísticas, temos três medidas de tendência central: meios de comunicação, MedianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos.... y Moda. Ajude-nos a descrever os dados.
A média é a medida precisa para descrever os dados quando não temos outliers presentes..
A mediana é usada se houver um outlier no conjunto de dados.
O modo é usado se houver um outlier E cerca de metade ou mais dos dados forem iguais.
o “meios de comunicação” é a única medida de tendência central que é afetada por outliers, que por sua vez afeta o desvio padrão.
Exemplo:
Considere um pequeno conjunto de dados, amostra = [15, 101, 18, 7, 13, 16, 11, 21, 5, 15, 10, 9]. Olhando para isso, você pode dizer rapidamente que '101’ é um outlier que é muito maior do que os outros valores.
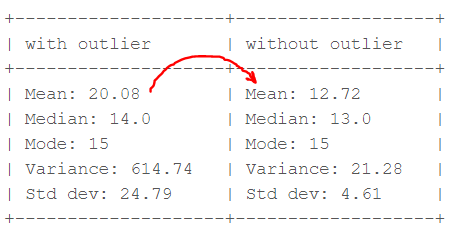
Dos cálculos acima, podemos dizer claramente que a média é mais afetada do que a mediana.
4. Detecção de valores atípicos
Se nosso conjunto de dados for pequeno, podemos detectar o outlier apenas olhando para o conjunto de dados. Mas, E se tivermos um grande conjunto de dados, como identificamos outliers? Precisamos usar técnicas de visualização e matemática.
Abaixo estão algumas das técnicas para detectar outliers.
- Plotagens de caixaDiagramas de caixa, Também conhecido como diagramas de caixa e bigode, são ferramentas estatísticas que representam a distribuição de um conjunto de dados. Esses diagramas mostram a mediana, Quartis e outliers, permitindo que a variabilidade e a simetria dos dados sejam visualizadas. Eles são úteis na comparação entre diferentes grupos e na análise exploratória, facilitando a identificação de tendências e padrões nos dados....
- Classificação Z
- Intervalo entre quantiles (IQR)
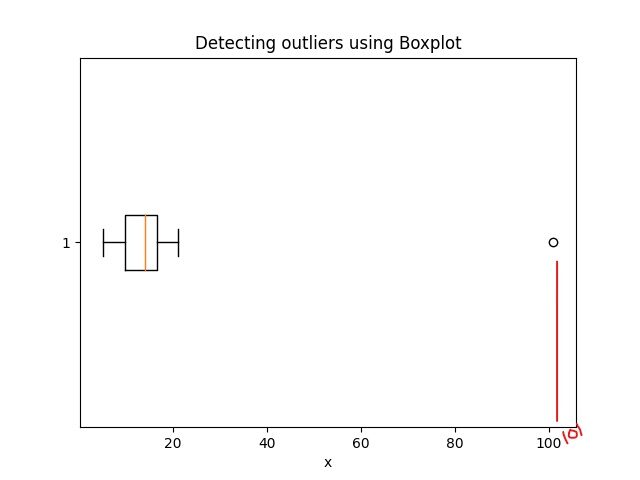
4.1 Detecção outlier usando Boxplot:
O código Python para o diagrama da caixa é:
import matplotlib.pyplot as plt
plt.boxplot(amostra, vert=Falso)
plt.title("Detectando outliers usando Boxplot")
plt.xlabel('Sample')
4.2 Detecção outlier usando pontuações Z
Critério: qualquer ponto de dados cujo Z-score cai fora do 3º desvio padrão é um outlier.
Passos:
- passar por todos os pontos de dados e calcular a pontuação Z usando a fórmula (Xi-média) / std.
- definir um valor limiar de 3 e marcar pontos de dados cujo valor absoluto de pontuação Z é maior do que o limiar como outliers.
import numpy as np
outliers = []
def detect_outliers_zscore(dados):
    thres = 3
    média = np.média(dados)
    std = np.std(dados)
    # imprimir(quer dizer, std)
    para mim nos dados:
        z_score = (I-mean)/std
        if (np.abs(z_score) > thres):
            outliers.append(eu)
    return outliers# Driver code
sample_outliers = detect_outliers_zscore(amostra)
imprimir("Outliers do método de pontuação Z: ", sample_outliers)
Os resultados do código anterior: Outliers do método de pontuação Z: [101]
4.3 Detecção de outliers usando o intervalo entre quantiles (IQR)
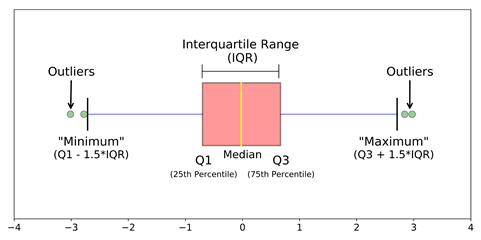
Critério: os pontos de dados que estão localizados 1,5 vezes que o IQR acima do Q3 e abaixo do Q1 são outliers.
Passos:
- Classifique o conjunto de dados em ordem ascendente
- calcular o primeiro e terceiro quartis (T1, 3º T)
- calcular IQR = Q3-Q1
- calcular limite menor = (Q1-1.5 * IQR), limite superior = (3º T + 1.5 * IQR)
- passar pelos valores no conjunto de dados e verificar aqueles que caem abaixo do limite inferior e acima do limite superior e marcá-los como outliers
Código Python:
outliers = []
def detect_outliers_iqr(dados):
    dados = classificados(dados)
    q1 = np.percentil(dados, 25)
    q3 = np.percentil(dados, 75)
    # imprimir(Q1, Q3)
    IQR = q3-q1
    lwr_bound = q1-(1.5*IQR)
    upr_bound = q3+(1.5*IQR)
    # imprimir(lwr_bound, upr_bound)
    para mim nos dados:
        E se (eu<lwr_bound ou eu>upr_bound):
            outliers.append(eu)
    return outliers# Driver code
sample_outliers = detect_outliers_iqr(amostra)
imprimir("Outliers do método IQR: ", sample_outliers)
Os resultados do código anterior: Outliers do método IQR: [101]
5. Tratamento de outliers
Até agora, aprendemos sobre detecção de outliers. A questão principal é O QUE fazemos com os outliers?
Aqui estão alguns dos métodos para lidar com outliers.
- Aparar / remover outlier
- Revestimentos e pavimentos baseados em quantis
- Imputação média / mediana
5.1 Cortar fora / Remoção de outlier
Nesta técnica, removemos outliers do conjunto de dados. Embora não seja uma boa prática seguir.
Código Python para remover o outlier e copiar o resto dos elementos para outra matriz.
# Trimming
for i in sample_outliers:
    a = np.delete(amostra, np.where(amostra==i))
imprimir(uma)
# imprimir(len(amostra), len(uma))
Outlier '101’ é excluído e o resto dos pontos de dados são copiados para outra matriz 'a'.
5.2 Revestimentos e pisos baseados em quantiles
Nesta técnica, o outlier é limitado a um determinado valor acima do valor percentil 90 ou é reduzido a um fator abaixo do valor percentil 10.
Código Python:
# Computação 10, 90th percentiles and replacing the outliers
tenth_percentile = np.percentile(amostra, 10)
ninetieth_percentile = np.percentil(amostra, 90)
# imprimir(tenth_percentile, ninetieth_percentile)b = np.where(amostra<tenth_percentile, tenth_percentile, amostra)
b = np.where(b>ninetieth_percentile, ninetieth_percentile, b)
# imprimir("Amostra:", amostra)
imprimir("Nova matriz:",b)
Os resultados do código anterior: Nova matriz: [15, 20.7, 18, 7.2, 13, 16, 11, 20.7, 7.2, 15, 10, 9]
Pontos de dados menores que o percentil 10 são substituídos pelo valor percentil 10 e pontos de dados que são maiores do que o percentil 90 são substituídos pelo valor percentil 90.
5.3 imputação média / mediana
Como o valor médio é muito influenciado por outliers, recomenda-se substituir outliers pelo valor mediano.
Código Python:
mediana = np.mediana(amostra)# Replace with median
for i in sample_outliers:
    c = np.where(amostra==i, 14, amostra)
imprimir("Amostra: ", amostra)
imprimir("Nova matriz: ",c)
# imprimir(x.dtype)
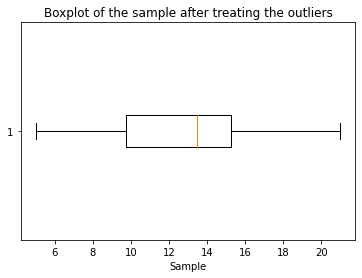
Visualização dos dados depois de lidar com o outlier
plt.boxplot(c, vert=Falso)
plt.title("Boxplot da amostra depois de tratar os outliers")
plt.xlabel("Amostra")
Resumo:
Neste blog, aprendemos sobre uma fase importante de pré-processamento de dados que é um processamento outlier. Agora sabemos diferentes métodos para detectar e tratar outliers.
Referências:
Pontuação Z para detecção outlier
Repositório GitHub para consultar o notebook Jupyter
Espero que este blog ajude você a entender o conceito de outliers. Por favor, vote em se você gosta. Boa aprendizagem !! 😊
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





