
Este artigo foi publicado como parte do Data Science Blogathon
Introdução
são observáveis. Uma vez que não temos os valores para as variáveis não observadas (latente), a Expectativa-maximização O algoritmo tenta usar os dados existentes para determinar os valores ideais para essas variáveis e, em seguida, encontra o parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... do modelo.
Tabela de conteúdo
- 👉 Qual é o algoritmo de maximização de expectativa (EM)?
- 👉 Explicação detalhada do algoritmo EM
- 👉 Diagrama de fluxo
- 👉 Vantagens e desvantagens
- 👉 Aplicações do algoritmo EM
- 👉 Caso de uso do algoritmo EM
- Introdução às distribuições gaussianas
- Modelos de mistura gaussiana (GMM)
- 👉 Implementação de modelos de mistura gaussiana em Python
Qual é o algoritmo de maximização de expectativa (EM)?
👉 É um modelo de variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... latente.
Primeiro, Vamos entender o que significa modelo de variável latente.
Um modelo de variável latente consiste em observável variáveis junto com inobservable variáveis. Variáveis observadas são aquelas variáveis no conjunto de dados que podem ser medidas, enquanto as variáveis não observadas (latente / escondido) são inferidos das variáveis observadas.
- 👉 Pode ser usado para encontrar probabilidade máxima local (MLE) parâmetros ou máximo a posteriori (MAPA) parâmetros para variáveis latentes
em um modelo estatístico ou matemático. - 👉 Usado para prever esses valores ausentes no conjunto de dados, desde que saibamos a forma geral de distribuição de probabilidade associada a essas variáveis latentes.
- 👉 Em palavras simples, a ideia básica por trás deste algoritmo é usar as amostras observáveis de variáveis latentes para prever os valores das amostras que não são observáveis para a aprendizagem. Este processo é repetido até que ocorra a convergência dos valores.
Explicação detalhada do algoritmo EM
👉 Aqui está o algoritmo que você precisa seguir:
- Dado um conjunto de dados incompleto, comece com um conjunto de parâmetros inicializados.
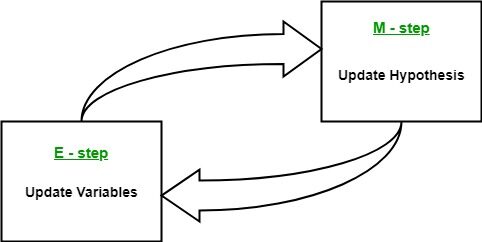
- Etapa de expectativa (passo E): Nesta etapa de expectativa, usando os dados observados disponíveis no conjunto de dados, podemos tentar estimar ou adivinhar os valores de dados ausentes. Finalmente, depois dessa etapa, obtemos dados completos sem valores ausentes.
- Etapa de maximização (passo M): Agora, temos que usar os dados completos, que se preparam na etapa de expectativa, e atualizar os parâmetros.
- Repita o passo 2 e o passo 3 até convergirmos para a nossa solução.
Fonte da imagem: Ligação
👉
Objetivo do algoritmo de maximização da expectativa
O algoritmo de maximização de expectativa visa usar os dados observados disponíveis do conjunto de dados para estimar os dados perdidos para as variáveis latentes e, em seguida, usar esses dados para atualizar os valores dos parâmetros na etapa de maximização..
Vamos entender o algoritmo EM em detalhes:
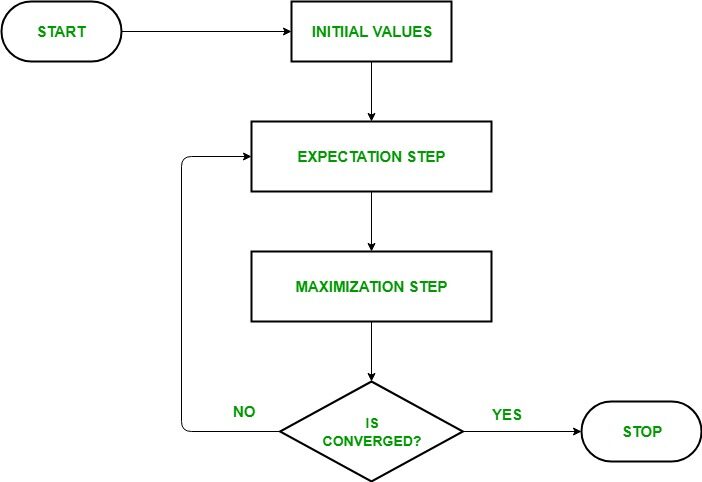
- euEtapa de inicialização: Nesta etapa, nós inicializamos os valores dos parâmetros com um conjunto de valores iniciais, então, entregamos o conjunto de dados observados incompletos ao sistema com a suposição de que os dados observados vêm de um modelo específico. quer dizer, distribuição de probabilidade.
- Etapa de expectativa: Nesta etapa, usar dados observados para estimar ou adivinhar valores de dados ausentes ou incompletos. Usado para atualizar variáveis.
- Etapa de maximização: Nesta etapa, usamos os dados completos gerados no “Expectativa” etapa para atualizar os valores dos parâmetros, quer dizer, atualizar hipótese.
- Verificando a etapa de convergência: Agora, nesta etapa, verificamos se os valores estão convergindo ou não, sim é assim, Pare, caso contrário, repita essas duas etapas, quer dizer, a “Expectativa” passo e “Maximização” passo até que a convergência ocorra.
Fluxograma para o algoritmo EM
Fonte da imagem: Ligação
Vantagens e desvantagens do algoritmo EM
👉 Vantagem
- As duas etapas básicas do algoritmo EM, quer dizer, E-step y M-step, são geralmente muito fáceis para muitos problemas de aprendizado de máquina em termos de implementação.
- A solução para as etapas M muitas vezes existe de forma fechada.
- O valor da probabilidade é sempre garantido para aumentar após cada iteração.
👉 Desvantagens
- Tenho convergência lenta.
- Convergir para o ótimo local só.
- Ele leva em consideração as probabilidades de avanço e retrocesso. Isso contrasta com a otimização numérica que considera apenas chances de avanço.
Aplicações do algoritmo EM
O modelo de variável latente tem várias aplicações da vida real em aprendizado de máquina:
- 👉 Usado para calcular o Densidade gaussiana de uma função.
- 👉 Útil para completar o dados perdidos durante um show.
- 👉 É muito útil em diferentes domínios, como Processamento de linguagem natural (PNL), Visão computacional, etc.
- 👉 Usado na reconstrução de imagens na área de Medicina e engenharia estrutural.
- 👉 É usado para estimar os parâmetros do Modelo de Markov oculto (HMM) e também para alguns outros modelos mistos, como Mistura gaussiana Modelosetc.
- 👉 É usado para encontrar os valores das variáveis latentes.
Caso de uso do algoritmo EM
Noções básicas de distribuição gaussiana
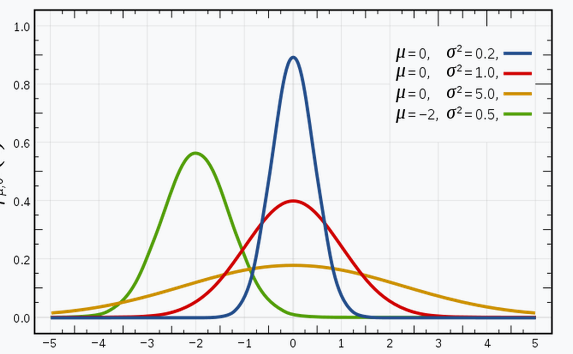
Tenho certeza de que você está familiarizado com as distribuições gaussianas (ou a distribuição normal), já que essa distribuição é muito usada no campo do aprendizado de máquina e estatística. Tem uma curva em forma de sino, com as observações distribuídas simetricamente em torno do valor médio (média).
A imagem apresentada tem algumas distribuições gaussianas com diferentes valores da média (μ) e a variação (σ2). Lembre-se de que quanto maior o valor de σ (Desvio padrão), quanto maior for a extensão ao longo do eixo.
Fonte da imagem: Ligação
No espaço 1-D, a função densidade de probabilidade de uma distribuição gaussiana é dada por:
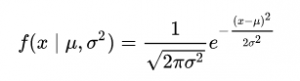
FIG. Função densidade de probabilidade (PDF)
onde μ representa a média e σ2 representa a variação.
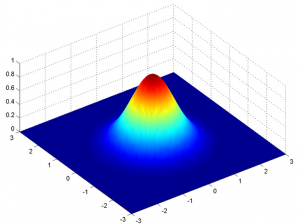
Mas isso só seria verdade para uma variável em 1-D apenas. No caso de duas variáveis, teremos uma curva em forma de sino 3D em vez de uma curva em forma de sino 2D como mostrado abaixo:
A função de densidade de probabilidade seria dada por:
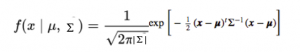
onde x é o vetor de entrada, μ é o vetor médio 2-D e Σ é a matriz de covariância 2 × 2. Podemos generalizar a mesma coisa para o dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e... d.
Portanto, para o modelo multivariado de Gauss, temos x e μ como vetores de comprimento d, e Σ seria um dxd Matriz de covariância.
Portanto, para um conjunto de dados que tem D caracteristicas, teríamos uma mistura de k Distribuições gaussianas (Onde k representa o número de clusters), cada um com um vetor médio e matriz de variância determinados.
Mas nossa pergunta é: “Como podemos encontrar a média e a variância de cada gaussiana?”
Para encontrar esses valores, usamos uma técnica chamada Expectation-Maximization (EM).
Modelos de mistura gaussiana
A principal suposição desses modelos de mistura é que há um certo número de distribuições gaussianas, e cada uma dessas distribuições representa um grupo. Portanto, um modelo de mistura gaussiana tenta agrupar observações que pertencem a uma única distribuição.
Os modelos de mistura gaussiana são modelos probabilísticos que usam o agrupamentoo "agrupamento" É um conceito que se refere à organização de elementos ou indivíduos em grupos com características ou objetivos comuns. Este processo é usado em várias disciplinas, incluindo psicologia, Educação e biologia, para facilitar a análise e compreensão de comportamentos ou fenômenos. No campo educacional, por exemplo, O agrupamento pode melhorar a interação e o aprendizado entre os alunos, incentivando o trabalho.. Facilidade para distribuir observações em diferentes grupos, quer dizer, distribuições gaussianas diferentes.
Por exemplo, o modelo de mistura gaussiana de 2 Distribuições gaussianas
Temos duas distribuições gaussianas: N (𝜇1, 𝜎12) e n(𝜇2, 𝜎22)
Aqui, temos que estimar um total de 5 parametros:
𝜃 = (p, 𝜇1, 𝜎12,𝜇2, 𝜎22)
onde p é a probabilidade de que os dados venham da primeira distribuição gaussiana e 1-p de que venham da segunda distribuição gaussiana.
Então, a função de densidade de probabilidade (PDF) do modelo de mistura é dado por:
g (x |𝜃) = p1(x | 𝜇1, 𝜎12) + (1-p) g2(x | 𝜇2, 𝜎22 )
objetivo: Para ajustar melhor uma determinada densidade de probabilidade, encontrando 𝜃 = (p, 𝜇1, 𝜎12, 𝜇2, 𝜎22) por meio de iterações EM.
Implementação de GMM em Python
É hora de mergulhar no código! Aqui para implementação, nós usamos o Biblioteca Sklearn de Python.
De sklearn, usamos a classe GaussianMixture que implementa o algoritmo EM para ajustar uma mistura de modelos Gaussianos. Após a criação do objeto, usando o GaussianMixture.fit podemos aprender um modelo de mistura gaussiana a partir dos dados de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.....
Paso 1: Importe os pacotes necessários
importar numpy como np
import matplotlib.pyplot as plt
de sklearn.mixture import GaussianMixture
Paso 2: criar um objeto da classe Gaussian Mixture
gmm = GaussianMixture(n_components = 2, pedágio = 0,000001)
Paso 3: ajusta o objeto criado a determinado conjunto de dados
gmm.fit(np.expand_dims(dados, 1))
Paso 4: Imprima os parâmetros de 2 gaussianos de entrada
Gaussian_nr = 1
imprimir('Entrada Normal_distb {:}: µ = {:.2}, σ = {:.2}'.format("1", Mean1, Standard_dev1))
imprimir('Entrada Normal_distb {:}: µ = {:.2}, σ = {:.2}'.format("2", Mean2, Standard_dev2))
Saída:

Entrada Normal_distb 1: µ = 2.0, σ = 4.0

Entrada Normal_distb 2: µ = 9.0, σ = 2.0
Paso 5: Parâmetros de impressão após a mistura 2 gaussianos
para mu, SD, p em zip(gmm.means_.flatten(), np.sqrt(gmm.covariances_.flatten()), gmm.weights_):
    imprimir('Normal_distb {:}: µ = {:.2}, σ = {:.2}, peso = {:.2}'.format(Gaussian_nr, mu, SD, p))
    g_s = stats.norm(mu, SD).pdf(x) * p
    plt.plot(x, g_s, rótulo ="sklearn gaussiano");
    Gaussian_nr + = 1
Produção:
Normal_distb 1: µ = 1,7, σ = 3,8, peso = 0,61
Normal_distb 2: µ = 8.8, σ = 2.2, peso = 0.39
Paso 6: Trace os gráficos de distribuição
sns.distplot(dados, bins = 20, kde = False, norm_hist = True)
gmm_sum = np.exp([gmm.score_samples(e.reshape(-1, 1)) para e em x])
plt.plot(x, gmm_sum, rótulo ="mistura gaussiana");
plt.legend();
Produção:
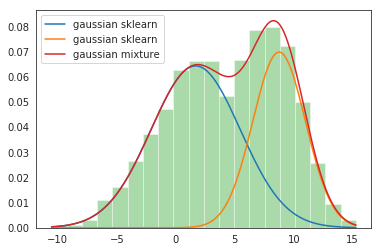
Isso conclui nossa implementação do GMM!!
Notas finais
Obrigado pela leitura!
Se você gostou e quer saber mais, visite meus outros artigos sobre ciência de dados e aprendizado de máquina clicando no Ligação
Sinta-se à vontade para entrar em contato comigo em Linkedin, Correio eletrônico.
Qualquer coisa não mencionada ou você deseja compartilhar suas idéias? Sinta-se à vontade para comentar abaixo e eu entrarei em contato com você.
Sobre o autor
Chirag Goyal
Atualmente, Estou cursando bacharelado em tecnologia (B.Tech) em Ciência da Computação e Engenharia da Instituto Indiano de Tecnologia de Jodhpur (IITJ). Estou muito animado com o aprendizado de máquina, a aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... e inteligência artificial.
A mídia mostrada neste artigo sobre Algoritmo de maximização de expectativa não são propriedade da DataPeaker e são usados a critério do autor.





