
Este artigo foi publicado como parte do Data Science Blogathon
Introdução
Imagine entrar em uma livraria para comprar um livro sobre a economia mundial e não conseguir encontrar a seção da loja que tem esse livro., presumindo que a livraria simplesmente empilhou todos os tipos de livros. Então você percebe como é importante dividir a biblioteca em diferentes seções de acordo com o tipo de livro.
A modelagem de temas é semelhante a dividir uma biblioteca com base no conteúdo dos livros, pois se refere ao processo de descoberta de tópicos em um corpus de texto e anotação dos documentos com base nos tópicos identificados.
Quando você precisa segmentar, compreender e resumir uma grande coleção de documentos, modelagem de tópicos pode ser útil.
Modelado de temas usando LDA:
A atribuição latente de Dirichlet (LDA) é uma das maneiras de implementar modelagem de tema. É um modelo probabilístico generativo em que cada documento é assumido como consistindo em uma proporção diferente de tópicos.
Como funciona o algoritmo LDA?
As etapas a seguir são realizadas em LDA para atribuir tópicos a cada um dos documentos:
1) Para cada documento, inicializar aleatoriamente cada palavra para um tópico entre os K tópicos onde K é o número de tópicos predefinidos.
2) Para cada documento d:
Para cada palavra w no documento, calcule:
- P (tema t | documento d): Proporção de palavras no documento d que são atribuídas ao tópico t
- P (palabra w | tema t): Proporção de atribuições para o tópico t em todos os documentos do Word que vêm de w
3) Reatribua o tópico T 'à palavra w com probabilidade p (t’ | d) * p (C | t ‘) considerando todas as outras palavras e suas atribuições de assunto
A última etapa é repetida várias vezes até atingirmos um estado estável onde as atribuições do tópico não mudam mais. A proporção de tópicos para cada documento é determinada a partir dessas atribuições de tópicos.
Exemplo ilustrativo de LDA:
Digamos que temos o seguinte 4 documentos como um corpus e queremos realizar uma modelagem de tópicos nesses documentos.
Documento 1: Assistimos muitos vídeos no YouTube.
Documento 2: Os vídeos do YouTube são muito informativos.
Documento 3: Ler um blog técnico me faz entender as coisas facilmente.
Documento 4: Eu prefiro blogs do que vídeos do YouTube.
A modelagem LDA nos ajuda a descobrir tópicos no corpus anterior e atribuir combinações de tópicos para cada um dos documentos. Como exemplo, o modelo pode produzir algo como abaixo:
Tema 1: 40% videos, 60% Youtube
Tema 2: 95% blogs, 5% Youtube
Os documentos 1 e 2 então pertenceria a 100% para o tópico 1. O documento 3 pertenceria a 100% para o tópico 2. O documento 4 pertenceria a 80% para o tópico 2 e ele 20% para o tópico 1.
Esta atribuição de tópicos a documentos é feita por meio de modelagem LDA seguindo as etapas que discutimos na seção anterior. Agora vamos aplicar LDA a alguns dados de texto e analisar os resultados reais em Python.
Modelagem de tema usando LDA em Python:
Pegamos os dados da 'Amazon Fine Food Reviews’ de Kaggle (https://www.kaggle.com/snap/amazon-fine-food-reviews) aqui para ilustrar como podemos implementar a modelagem de tema usando LDA em Python.
Lendo os dados:
Começamos importando a biblioteca Pandas para ler o CSV e salvá-lo em um quadro de dados.
importar pandas como pd
rev = pd.read_csv(r"Reviews.csv")
rev.head()
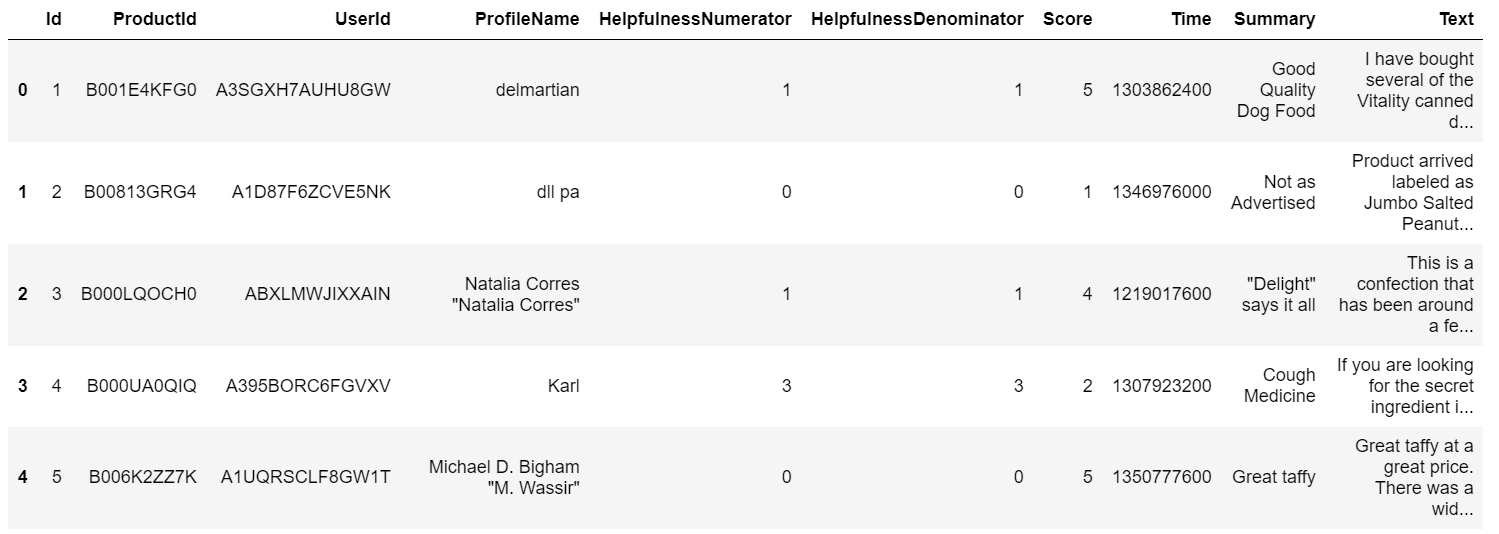
Estamos interessados em modelar tópicos para a coluna ‘Texto’ neste conjunto de dados.
Importando as bibliotecas necessárias:
Precisaremos importar a biblioteca NLTK, pois usaremos o stemming para o pré-processamento. O que mais, também removeríamos as palavras irrelevantes antes de realizar o LDA. Para realizar modelagem de tema, precisamos converter nossa coluna de texto em uma forma vetorizada e, portanto, importamos o TfidfVectorizer.
importar nltk
from nltk.corpus import stopwords #stopwords
from nltk.stem import WordNetLemmatizer
de sklearn.feature_extraction.text import TfidfVectorizer
stop_words = set(nltk.corpus.stopwords.words('inglês'))
Pré-processamento do texto:
Aplicaremos radicais às palavras para que as palavras raiz de todas as palavras derivadas sejam usadas. O que mais, palavras de parada são eliminadas e palavras com comprimento maior que 3.
def clean_text(título):
      le=WordNetLemmatizer()
      word_tokens=word_tokenize(título)
      tokens=[the.lemmatize(C) para w em word_tokens se w não em stop_words e len(C)>3]
        cleaned_text=" ".Junte(tokens)
      return cleaned_text
rev['cleaned_text']= rev['Text'].Aplique(clean_text)
Vetorização TFIDF na coluna de texto:
A realização de uma vetorização TFIDF na coluna de texto nos fornece uma matriz de termos do documento na qual podemos modelar o tema.. TFIDF refere-se a frequência de termo frequência inversa de documentos, uma vez que esta vetorização compara o número de vezes que uma palavra aparece em um documento com o número de documentos que a contêm.
vect = TfidfVectorizer(stop_words = stop_words,max_features = 1000)
vect_text = vect.fit_transform(rev['cleaned_text'])
LDA em texto vetorizado:
o parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... que le hemos dado al modelo LDA, como é mostrado a seguir, inclui o número de tópicos, o método de aprendizagem (que é a maneira como o algoritmo atualiza as atribuições de tópicos aos documentos), o número máximo de iterações para realizar. fora e o estado aleatório. Os parâmetros que demos ao modelo LDA, como é mostrado a seguir, inclui o número de tópicos, o método de aprendizagem (que é a maneira como o algoritmo atualiza as atribuições de tópicos aos documentos), o número máximo de iterações para realizar. fora e o estado aleatório.
from sklearn.decomposition import LatentDirichletAllocation
lda_model = LatentDirichletAllocation(n_components = 10,
learning_method='online',random_state = 42, max_iter = 1)
lda_top = lda_model.fit_transform(vect_text)
Verificando os resultados:
Podemos verificar a proporção de tópicos que foram atribuídos ao primeiro documento usando as linhas de código indicadas abaixo.
imprimir("Documento 0: ")
para eu,tópico em enumerar(lda_top[0]):
  imprimir("Tema ",eu,": ",tópico * 100,"%")
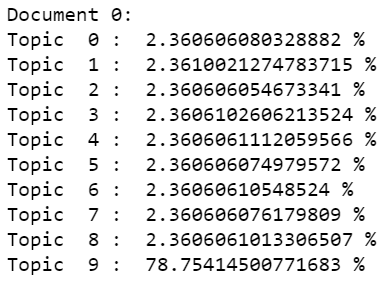
Analisando os problemas:
Vamos ver quais são as principais palavras que compõem os tópicos. Isso nos daria uma visão do que define cada um desses temas..
vocab = vect.get_feature_names()
para eu, comp em enumerar(lda_model.components_):
     vocab_comp = zip(vocabulário, comp)
     sorted_words = classificado(vocab_comp, chave = lambda x:x[1], reverso = verdadeiro)[:10]
     imprimir("Tema "+str(eu)+": ")
     para t em sorted_words:
            imprimir(t[0],fim =" ")
            imprimir("n")
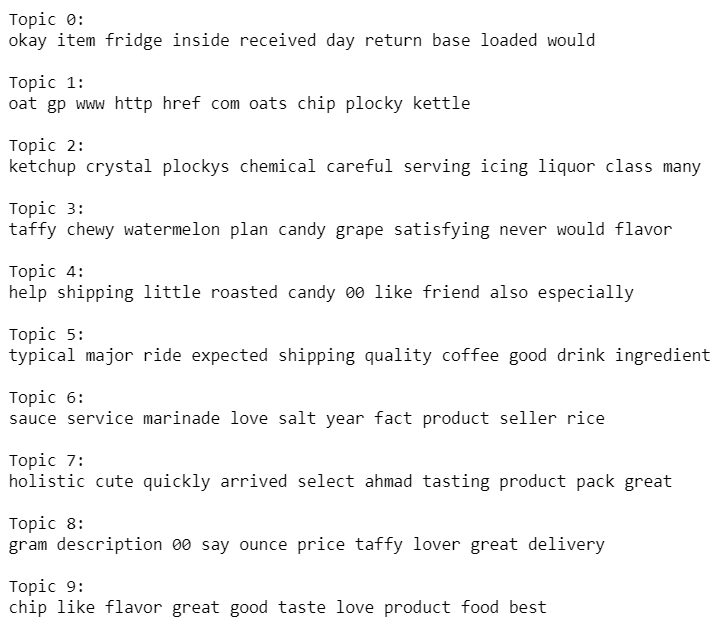
Além de LDA, outros algoritmos podem ser usados para realizar modelagem de tema. Indexação Semântica Latente (LSI), fatoração de matriz não negativa são alguns dos outros algoritmos que podem ser tentados para realizar modelagem de tema. Todos esses algoritmos, como LDA, envolvem a extração de recursos das matrizes de termos do documento e a geração de um grupo de termos que diferem uns dos outros, que acabou levando à criação de temas. Esses temas podem ajudar a avaliar os principais temas de um corpus e, portanto, organizar grandes coleções de dados textuais.
Sobre o autor
Nibedita
completou seu mestrado em Engenharia Química pelo IIT Kharagpur em 2014 e
atualmente trabalha como consultor sênior na AbsolutData Analytics. Na sua
Capacidade atual, trabalha na criação de soluções baseadas em IA / ML para clientes de
uma variedade de indústrias.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





