
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
Este artigo lhe dará clareza sobre o que é a redução de dimensionalidade, sua necessidade e como funciona. Também há código Python para ilustração e comparação entre PCA, ICA e t-SNE.
O que é redução de dimensionalidade e por que precisamos de
A redução da dimensionalidade é simplesmente reduzir o número de recursos (colunas) enquanto retém o máximo de informações. A seguir estão as razões para a redução da dimensionalidade:
- A redução da dimensionalidade ajuda na compressão de dados e, portanto, reduz o espaço de armazenamento.
- Reduza o tempo de cálculo.
- Também ajuda a eliminar recursos redundantes, sim, existem.
- Remover funções mapeadas.
- Reduzir as dimensões dos dados para 2D ou 3D pode nos permitir traçar e visualizar com precisão. A seguir, pode ver os padrões mais claramente.
- Também é útil para remover ruído e, como resultado disso, nós podemos melhorar
Existem muitos métodos para redução de dimensionalidade como PCA, ICA, t-SNE, etc., veremos PCA (Análise do componente principal).
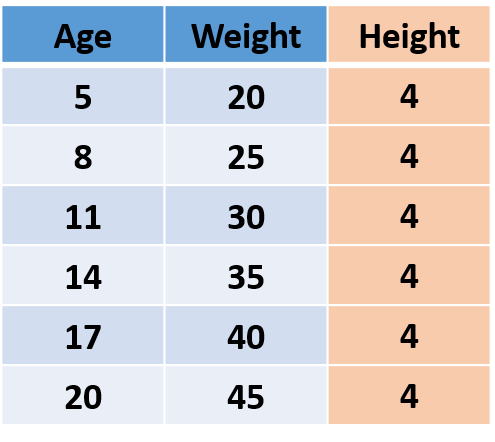
Vamos primeiro entender o que é em formação em dados. Considere os seguintes dados imaginários, quem é velho, peso e altura das pessoas.
Figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... 1
Como a 'Altura’ de todas as pessoas é o mesmo, quer dizer, a variação é 0, então não adiciona nenhuma informação, para que possamos excluir a coluna ‘Height’ sem perder nenhuma informação.
Agora que sabemos que a informação é variação, Vamos entender como funciona o PCA. Em PCA, nós encontramos novas dimensões (caracteristicas) que capturam a variação máxima (quer dizer, em formação). Para entender isso, usaremos o exemplo anterior. Depois de remover 'Height', Nós temos 'Idade’ e 'Peso'. Essas duas características cuidam de todas as informações. Em outras palavras, podemos dizer que precisamos 2 caracteristicas (Idade e Altura) para conter a informação, e se pudermos encontrar um novo recurso que sozinho pode conter todas as informações, podemos substituir as características de origem 2 com um novo recurso exclusivo, alcançando a redução de dimensionalidade!
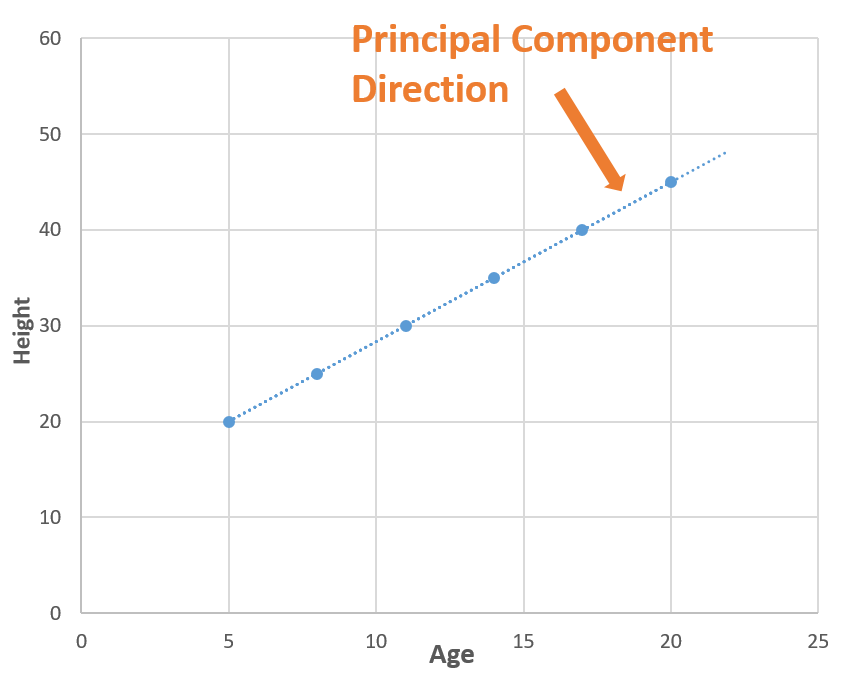
Agora considere uma linha (linha pontilhada azul) o que passa por todos os pontos. A linha pontilhada azul está capturando todas as informações, para que possamos substituir 'Idade’ e 'Peso’ (2 dimensões) com linha pontilhada azul (1 dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e...) sem perder nenhuma informação, e neste w
Você se pergunta como encontramos a linha pontilhada azul (componente principal), então há muita matemática por trás disso.. Você pode ler Este artigo o que explica isso, mas em palavras simples, encontramos as direções em que podemos capturar variância máxima usando autovalores e autovetores.
Ilustração de PCA em Python
Vamos ver como usar o PCA com um exemplo. Usei dados de qualidade do vinho que 12 características como acidez, açúcar residual, cloretos, etc., e a qualidade do vinho para 1600 amostras. Você pode baixar o caderno jupyter daqui e siga.
Primeiro, vamos carregar os dados.
importar numpy como np
importar pandas como pd
de sklearn.decomposition import PCA
df = pd.read_csv('winequality-red.csv')
df.head()
y = df.pop('qualidade')
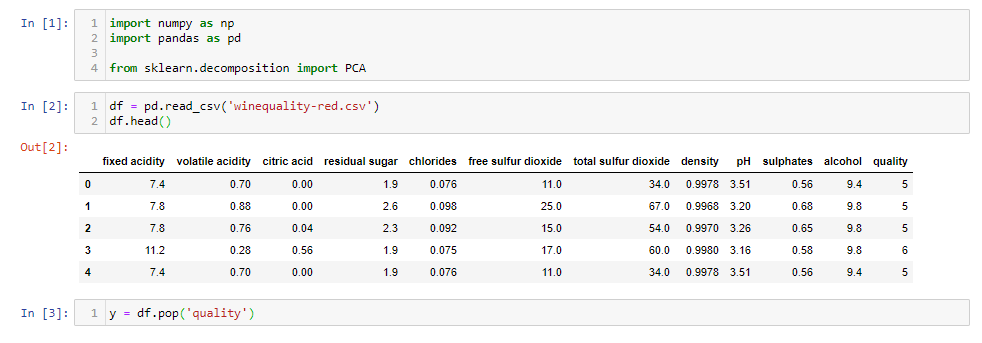
Depois de carregar os dados, nós eliminamos a 'Qualidade’ Do vinho, uma vez que é a característica alvo. Agora vamos dimensionar os dados, porque senão, O PCA não será capaz de encontrar os componentes principais ideais. Por ex. temos uma característica em 'metros’ e outro em ‘quilômetros’, a característica com unidade 'metro’ terá mais variação do que ‘quilômetros’ (1 km = 1000 m), então o PCA dará mais importância à característica com alta variância . Então, vamos fazer a escala.
de sklearn.preprocessing import StandardScaler
escalar = StandardScaler()
df_scaled = pd.DataFrame(scalar.fit_transform(df), colunas = df.columns)
df_scaled
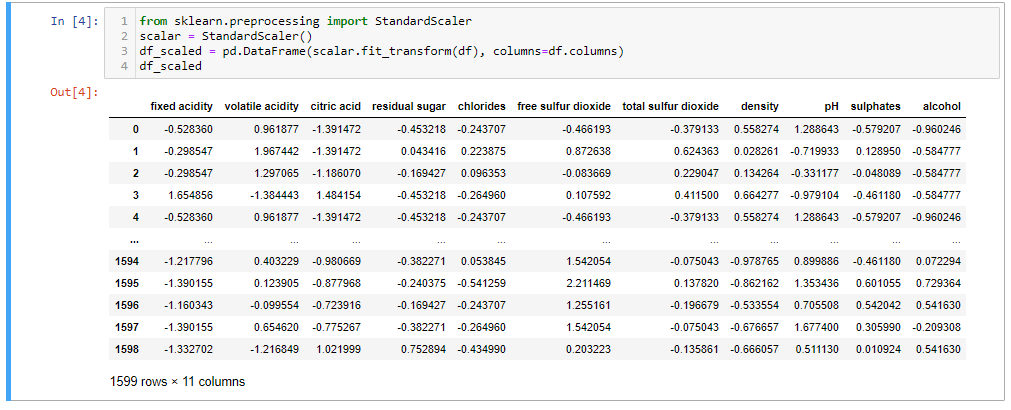
Agora nós
pca = PCA()
df_pca = pd.DataFrame(pca.fit_transform(df_scaled))
df_pca
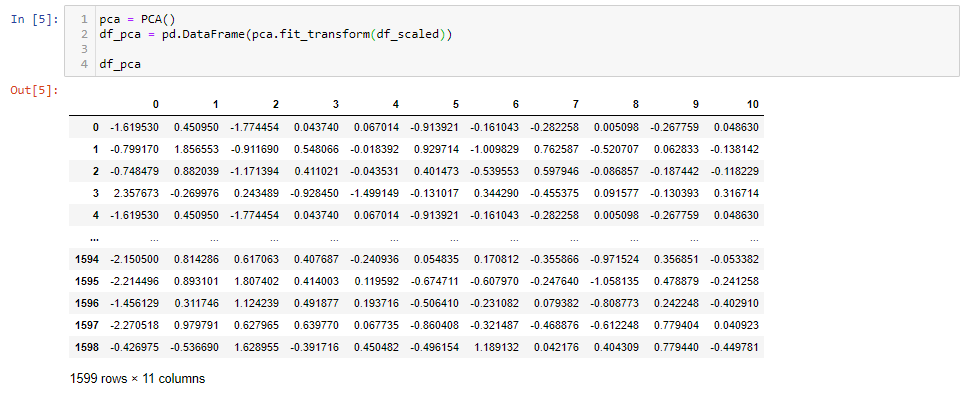
Depois de aplicar PCA, obtemos 11 componentes principais. É interessante ver quanta variação cada componente principal captura.
import matplotlib.pyplot as plt
pd.DataFrame(pca.explained_variance_ratio_).plot.bar()
plt.legend('')
plt.xlabel('Componentes Principais')
plt.ylabel('Variância Explicada');
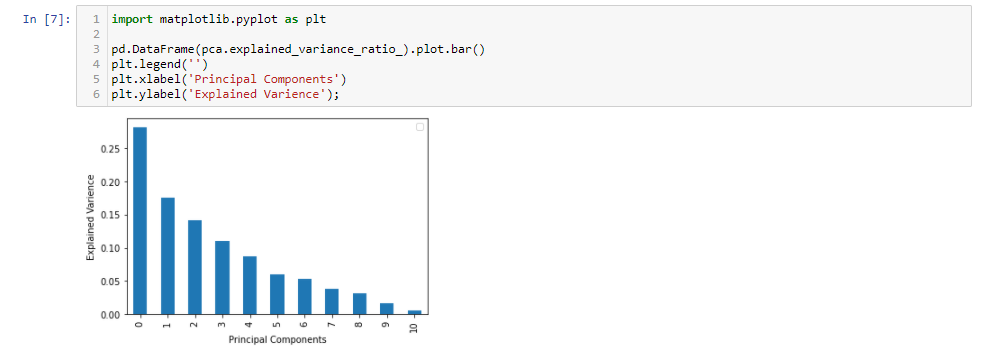
Os primeiros 5 captura de componentes principais em torno do 80% da variância, para que possamos substituir o 11 características originais (acidez, açúcar residual, cloretos, etc.) com o novo 5 características que têm o 80% da informação. Portanto, nós reduzimos o 11 dimensões apenas 5 dimensões, mantendo a maior parte das informações.
Diferença entre PCA, ICA e t-SNE
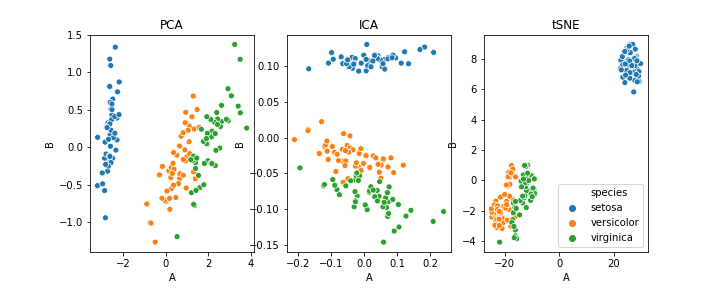
Como este artigo se concentra nas idéias básicas por trás da redução de dimensionalidade e como funciona o PCA, não vamos entrar em detalhes, mas aqueles que estão interessados podem passar por Este artigo.
Em resumo, PCA reduz dimensionalidade enquanto captura a maior parte da variação. Agora, ficaria animado em aplicar o PCA aos seus dados, mas antes disso, Quero destacar algumas das desvantagens do PCA:
- Variáveis independentes tornam-se menos interpretáveis
- A padronização de dados é uma obrigação antes do PCA
- Perda de informação
Espero que você encontre este artigo informativo. Obrigado!
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





